6.1 硬件加速:FPGA、ASIC 与 GPU
6.1 硬件加速:FPGA、ASIC 与 GPU 的竞赛格局
本节摘要:同态计算的性能瓶颈在内存带宽而非算力,这一判断决定了三类硬件路线的形态:图形处理器生态成熟、以带宽换吞吐;现场可编程门阵列用可重构流水线换能效;专用加速器为同态负载定制数据通路与片上内存,宣称再提一至两个数量级。本节拆解瓶颈来源、三条路线的代表性工作与量级收益,给出负载与硬件的匹配建议。
瓶颈再认识:算力易得,带宽难求
第四章末尾留了一句"图形处理器的瓶颈在内存带宽",这里把账算开。同态运算的工作集大得反常:一条密文数十万字节,一次乘法要搬动密文、重线性化密钥(几十条同尺寸多项式)与中间结果,有效计算强度(每字节搬运能做的乘加数)远低于通用负载。硬件上行话叫"受带宽限制的负载"——堆算力单元没用,数据喂不进去。这个判断的证据链来自多个独立团队的性能剖析:数论变换与密钥交换的执行时间里,访存等待占一半以上,算术单元利用率低得可怜。
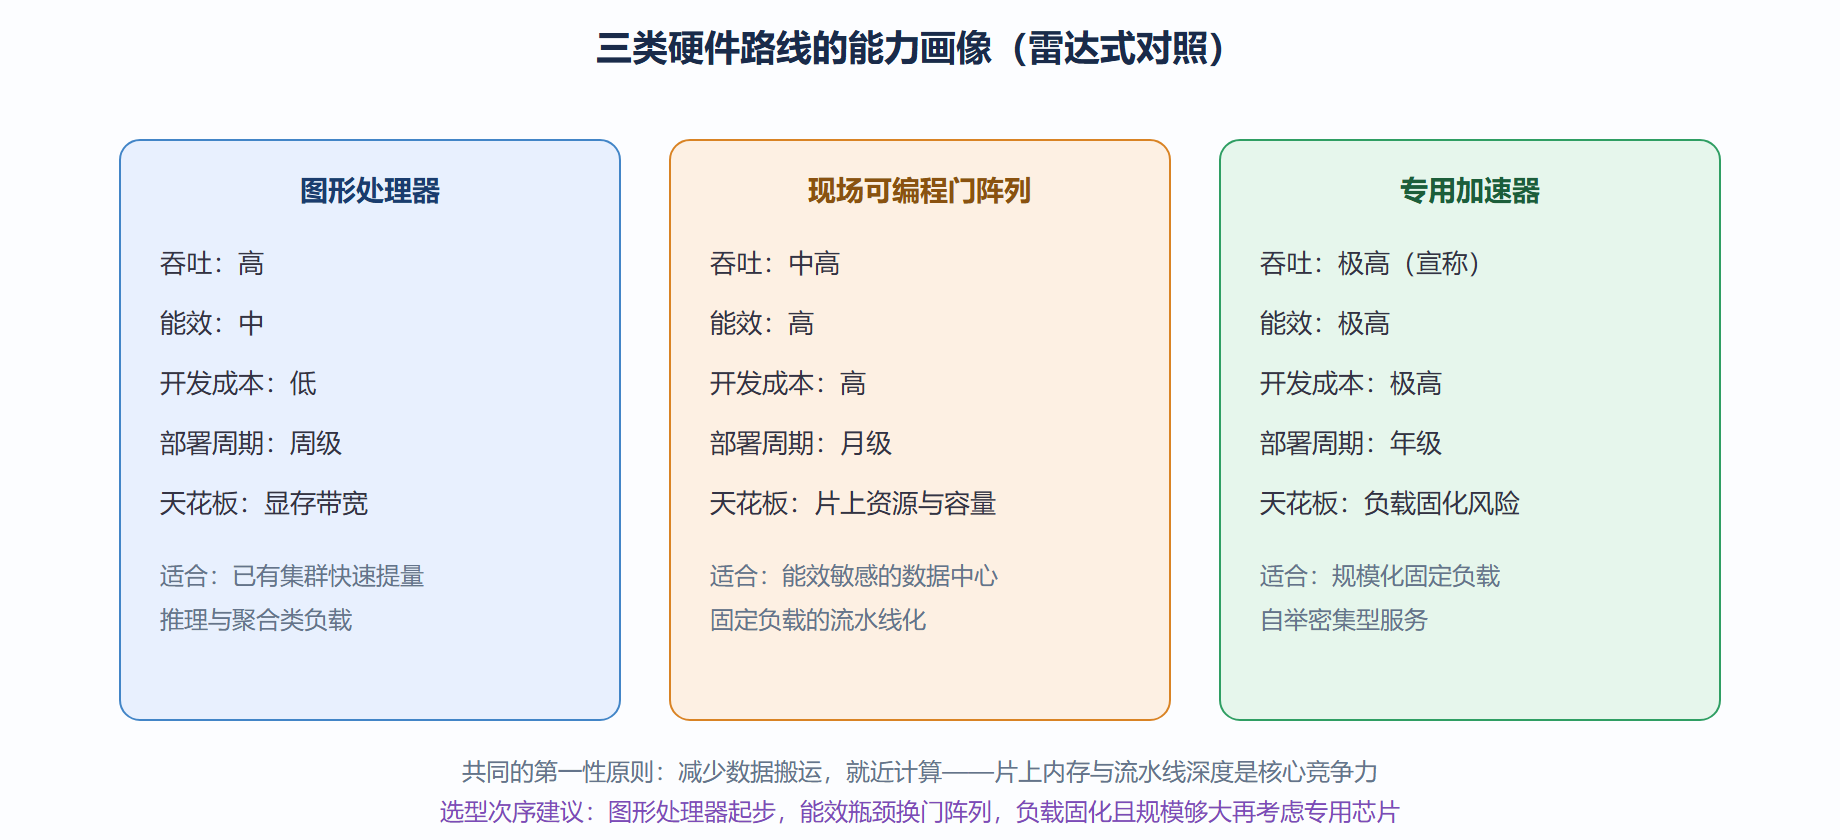
由此推出硬件设计的第一性原则:减少搬运、就近计算。三条技术路径都围绕它展开。图形处理器路线靠高带宽显存与大规模线程并行,把现有软件栈的吞吐提到一至两个数量级,生态最成熟、改造最轻。现场可编程门阵列路线把蝶形变换做成深度流水线,数据在片上流转、访存次数骤减,能效比占优,但开发周期长、单芯片容量有限。专用加速器路线最激进:为数论变换、模乘、自举设计专用数据通路,配上几十兆到几百兆字节的片上内存,把整个工作集装进芯片,宣称对特定负载再提一至两个数量级——学术界与初创公司都已展示原型,其中代表性工作把加密卷积网络推理从中央处理器的分钟级压到亚秒级、把自举速率推到每秒数千次的量级。
三条路线的对照
| 路线 | 代表形态 | 收益量级(对软件基线) | 优势 | 短板 |
|---|---|---|---|---|
| 图形处理器 | 主流卡上的同态库 | 一至两个数量级 | 生态成熟、部署快 | 带宽天花板、功耗 |
| 现场可编程门阵列 | 数据中心卡的可重构流水线 | 一至两个数量级(能效更优) | 能效比、确定性延迟 | 开发慢、容量小 |
| 专用加速器 | 定制芯片 | 宣称再一至两个数量级 | 片上内存消除搬运 | 流片贵、周期长、通用性差 |
图:硬件路线对比
代表性工作与量级记录
给几条有坐标价值的记录(量级为公开论文与产品宣称的典型值,随代际浮动)。图形处理器侧:主流开源库在旗舰卡上把自举吞吐推到每秒数百到数千次、加密推理进入毫秒级;学术工作用批量处理把小型网络的单次推理压到几十毫秒。现场可编程门阵列侧:代表性原型把数论变换做到数百兆赫的稳定流水,能效比图形处理器高数倍;数据中心级的部署以能效为主要诉求。专用加速器侧:学术界的代表性芯片为数论变换与模算术定制数据通路,配大容量片上内存,宣称对加密卷积推理提速四个数量级左右(相对未优化软件基线;相对优化软件基线的净收益要小得多,评估时要看基线口径);工业界的路线图瞄准自举密集型服务与加密虚拟机。
读这些数字要带两个心眼。其一,看基线:四个数量级的提速常以未优化的中央处理器软件为分母,对上了第四章优化技术的软件基线,净收益通常收缩到一到两个数量级——不是宣传作假,而是分母口径不同。其二,看负载:专用芯片的性能是针对特定参数档与特定算子深度的,换一个方案或维度档,数据通路可能完全不适配。"峰值收益"与"你的负载上的收益"之间隔着参数匹配这一关。
负载与硬件的匹配建议
实践中的匹配逻辑可以写成三步。第一步判断负载类型:推理与聚合类(线性为主、深度浅)对带宽的需求低于训练与自举密集类(深度大、中间结果多),前者图形处理器即可满足,后者才需要门阵列或专用路线。第二步判断规模:小规模试点直接用云上的图形处理器实例(按小时计费、无采购风险);规模化后再做能效与定制化评估。第三步判断演进速度:负载参数还在频繁变化(方案升级、维度调档)时不要上专用芯片——固化的数据通路赶不上算法迭代,这是专用路线最大的隐性风险。历史上密码硬件的教训反复出现:为上代算法定制的芯片在算法换代后变成昂贵的不动产,同态方案的参数与算子仍在快速演化,采购决策要把"算法保鲜期"折进折旧模型。
💡 关键直觉:判断一项硬件宣传的可信度,先看它的评测报告是否公布工作集大小与内存带宽利用率——敢公布这两个数字的,收益数字通常能复现;只谈算力峰值的,多半在回避真实瓶颈。
本节要点回顾
- 要点一:同态负载受内存带宽限制而非算力限制,硬件路线的胜负手在减少搬运(片上内存、深度流水线、数据通路定制)
- 要点二:三条路线的收益量级与代价——图形处理器一至两个数量级且部署最快、门阵列能效优、专用芯片宣称更高但有固化风险
- 要点三:读性能宣传先查基线口径(对未优化软件的四位数提速,对优化基线通常收缩一到两个数量级)
- 要点四:匹配三步——负载类型、规模阶段、算法保鲜期;专用芯片的最大风险是数据通路赶不上算法迭代
四、硬件加速的评估框架
评估任何同态硬件加速方案,用四维框架过一遍。维度一,覆盖面:它加速的是哪一层——NTT 与模乘的底层原语(FPGA 与 ASIC 都擅长)、还是自举的整条流水线(只有少数 ASIC 声称覆盖)、还是算子级的编译映射(GPU 软件栈的主场);覆盖面决定它能替你解决多少问题。维度二,弹性:参数变了、方案换了,硬件还能用吗——固定流水线的 ASIC 在方案迭代面前的折旧速度,是它性价比公式里最容易被低估的一项。维度三,集成成本:从驱动、编译器到算子库的软件栈成熟度,以及与现有同态库的适配层工作量——硬件本身的账单往往小于软件适配的账单。维度四,规模化路径:现在的演示板到未来的量产供货之间隔着什么(流片周期、产能、价格曲线),按你的业务增长节奏去对时间表。四维过完再算总账:同态硬件今天的正确姿势,是让 GPU 与 FPGA 承担可预期的加速、把 ASIC 留给已经定型的热点算子——买算力之前,先买确定性。
最后补一段对采购时点的判断:硬件加速方案的价值高度依赖同态负载的稳定性——业务算子三个月一变的探索期,上专用硬件等于把变化冻结在硅片里,FPGA 的可重编程性才是主战场;业务算子一年以上不变、且规模足以摊薄流片与库存的成熟期,ASIC 的单位成本优势才会兑现。把这两条时点判断写进采购备忘,与四维框架(覆盖面、弹性、集成成本、规模化路径)配合使用——硬件选型的错误大多不是选错了芯片,而是在错误的时间选了正确的芯片。