6.4 与其他隐私计算技术的融合
6.4 与其他隐私计算技术的融合:组合的艺术
本节摘要:同态加密、安全多方计算、差分隐私、可信执行环境、零知识证明各守一块信任维度,现实系统几乎总是组合使用。本节给出五种技术的坐标系对照、四类经过验证的组合模式(同态加速多方计算、密文域加噪、分级信任混合、同态加零知识防恶意)、以及组合设计的常见错误。
五种技术,五个维度
把隐私计算的主要技术放进同一个坐标系,先要承认它们回答的不是同一个问题。同态加密回答"计算方看不到数据";安全多方计算回答"多方合算而不互泄";差分隐私回答"发布结果不泄露个体";可信执行环境回答"硬件隔离的计算飞地";零知识证明回答"证明者为验证者的断言成立而不泄露依据"。五个回答可以同时为真,也可以只挑两三个——组合设计的本质是按威胁模型挑维度。用一张主表对照:
| 技术 | 保护对象 | 信任假设 | 计算开销 | 精度影响 | 典型角色 |
|---|---|---|---|---|---|
| 同态加密 | 数据与中间结果 | 数学难题(加环路假设) | 高(慢二到四个数量级) | 近似线有可控误差 | 密文域计算底座 |
| 安全多方计算 | 各方输入 | 诚实比例假设 | 中(通信密集) | 无 | 多方协议骨架 |
| 差分隐私 | 个体在发布结果中的痕迹 | 无(信息论保证) | 低 | 有(噪声注入) | 发布出口的保险丝 |
| 可信执行环境 | 数据在飞地内 | 硬件厂商与物理实现 | 低(近原生) | 无 | 性能敏感的密域 |
| 零知识证明 | 证明者的私有信息 | 数学难题 | 中(证明生成) | 无 | 正确性与合规背书 |
表里没有全能冠军。同态加密的开销最高但信任假设最干净(不信硬件、不信多数方);可信执行环境性能最好但要托付硬件供应链;差分隐私几乎零开销但只保护"发布口径"。工程选型的第一课是承认这是一个多目标优化,不存在支配解。
四类经过验证的组合模式
模式一:同态加速多方计算。经典多方计算协议里,乘法门要交互通信,大规模线性代数把通信量推到不可用。组合方案把协议里最重的线性段(矩阵乘、内积)交给同态加密在密文域完成,多方交互只处理非线性与门限操作——通信量下降一到两个数量级,这是同态部件在多方协议里的标准用法(预处理模型的现代变体沿此思路演化)。
模式二:密文域加噪。第五章联邦一节讲过:加密保护聚合过程,差分噪声保护发布结果,两者在密文上无缝拼接(噪声作为明文系数加进密文)。这个模式的价值在于它示范了"信息论保证与计算论保证可以串联"——过程靠数学难题保密,出口靠噪声给个体兜底,两道闸各管一段。
模式三:分级信任混合。高敏数据的重计算用同态(慢但信任最干净),低敏的预处理与调度用可信执行环境(快但要信硬件),公开结果的正确性用零知识证明背书。真实系统按数据分级与性能预算切分计算位置,"信任分层"是架构图上最先画的线。
模式四:同态加零知识防恶意。第五章云场景提过:基础同态部署假设服务器诚实执行,遇到恶意服务器(故意算错、偏离电路)需要零知识证明来约束——服务器证明"我确实对密文执行了约定的电路"。这个组合是近年研究热点,代价是证明生成的额外开销,收益是把诚实但好奇假设升级到恶意模型,对高价值场景(加密虚拟机的解密请求、金融联合计算)是刚需。
组合设计的常见错误
错误一,堆技术而无威胁模型。见过把五种技术全部塞进架构图的方案书——每一层都有理由,唯独说不清防的是哪个攻击者。组合必须从威胁模型倒推:列出攻击者能力(偷看、篡改、合谋、拒绝服务),每个防御组件对应至少一条攻击路径,对不上号的组件删掉。错误二,信任假设打架。可信执行环境与同态加密组合时,若密钥在飞地内生成又在飞地外使用,两套假设的边界交叉处最容易出漏洞——组合设计要画出每份秘密的完整生命周期,标注每一段它依赖的假设。错误三,性能预算错配。把差分隐私加在密文聚合之后才发现校准需要明文统计量,被迫在中间解密——组合的顺序错误会破坏整个隐私承诺,评审时按数据流逐步骤核对"这一步谁能看到什么"。错误四,忽视组合带来的新攻击面。两个安全组件的接口(证明系统验证同态计算、飞地输出进入密文域)本身是新代码,历史上组合协议的漏洞大多出在接口而不是组件。
💡 关键直觉:组合隐私技术像配药——单味药的疗效与剂量都清楚,疗效出问题往往出在相互作用上。威胁模型就是处方笺,先诊断(攻击者能力)再抓药(技术组合),并核对配伍禁忌(信任假设与性能预算的冲突)。
本节要点回顾
- 要点一:五种技术各答一问,坐标系里没有支配解;组合设计是按威胁模型挑维度的多目标优化
- 要点二:四类验证过的模式——同态加速多方计算(通信降数量级)、密文域加噪(过程与出口双保险)、分级信任混合(按数据分级切位置)、同态加零知识(升级到恶意模型)
- 要点三:四类常见错误——无威胁模型堆技术、信任假设打架、顺序错配破坏隐私链、接口成为新攻击面
- 要点四:评审组合方案的核心动作是画秘密的生命周期图,逐段标注假设与可见者
四、融合架构的选型决策树
把四大技术的融合做成一棵可选型决策树。第一问,数据能不能出域:能出且只需防偷看——传输加密加可信硬件足矣,同态不必上场;完全不能出域——进入同态与多方安全计算的候选池。第二问,计算形态是算术还是布尔:统计与推理走同态(CKKS 与 BFV),比较与检索走混淆电路或 TFHE,两者混合的多层方案是隐私机器学习的常态。第三问,交互轮次是否受限:多方安全计算的每一轮交互都是延迟与协调成本,跨机构场景里这一项经常一票否决,此时同态的单向性(数据方只上传一次)成为决定性优势。第四问,验证需求有多强:结果要不要可证明——要,叠加零知识证明层;不要,省下这部分算力预算。第五问,性能缺口多大:缺口在一到两个数量级以内,用算法与参数调优硬扛;超过两个数量级,引入可信硬件兜底或降级业务承诺。五问走完,技术组合自然浮出水面。这棵决策树的价值不在于给出唯一解,而在于把"隐私计算选型"从名词堆砌的争论变成有分叉的工程判断——每一问都是一次责任的明确归属。
图:隐私计算技术融合的选型决策树
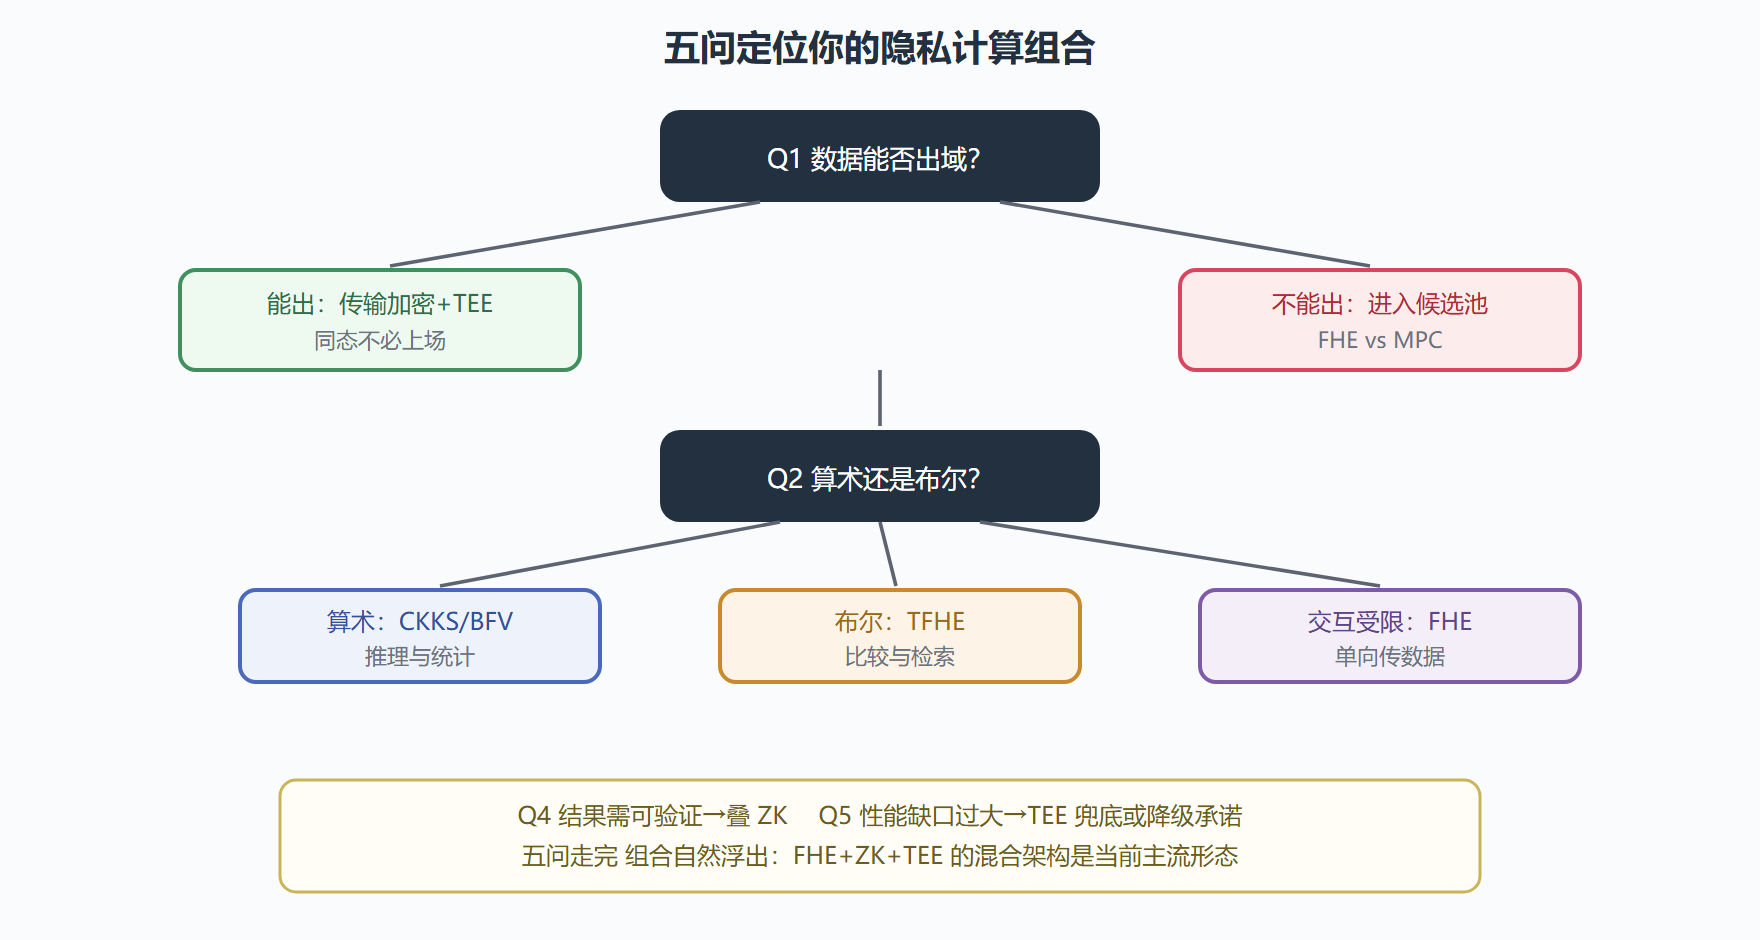
决策树的用法补充一句:把五问的答案写进方案文档的扉页,评审会上的大多数分歧会自动消解——因为分歧的根源往往不是技术判断不同,而是五问的前提没有对齐。