2.4 嫌疑人档案:节点嵌入与图嵌入
2.4 嫌疑人档案:节点嵌入与图嵌入
本节摘要:节点嵌入是把节点映射到低维向量、并让向量几何关系反映图结构关系的技术;图嵌入则通过读出操作把整张图的节点表示压缩成单个向量。本节先走随机游走家族(DeepWalk、node2vec)的老路,再看图神经网络嵌入如何补上归纳与特征融合两块短板,最后给出图级读出的三种方案,为第四章的结案任务备好弹药。
档案室的卡片柜
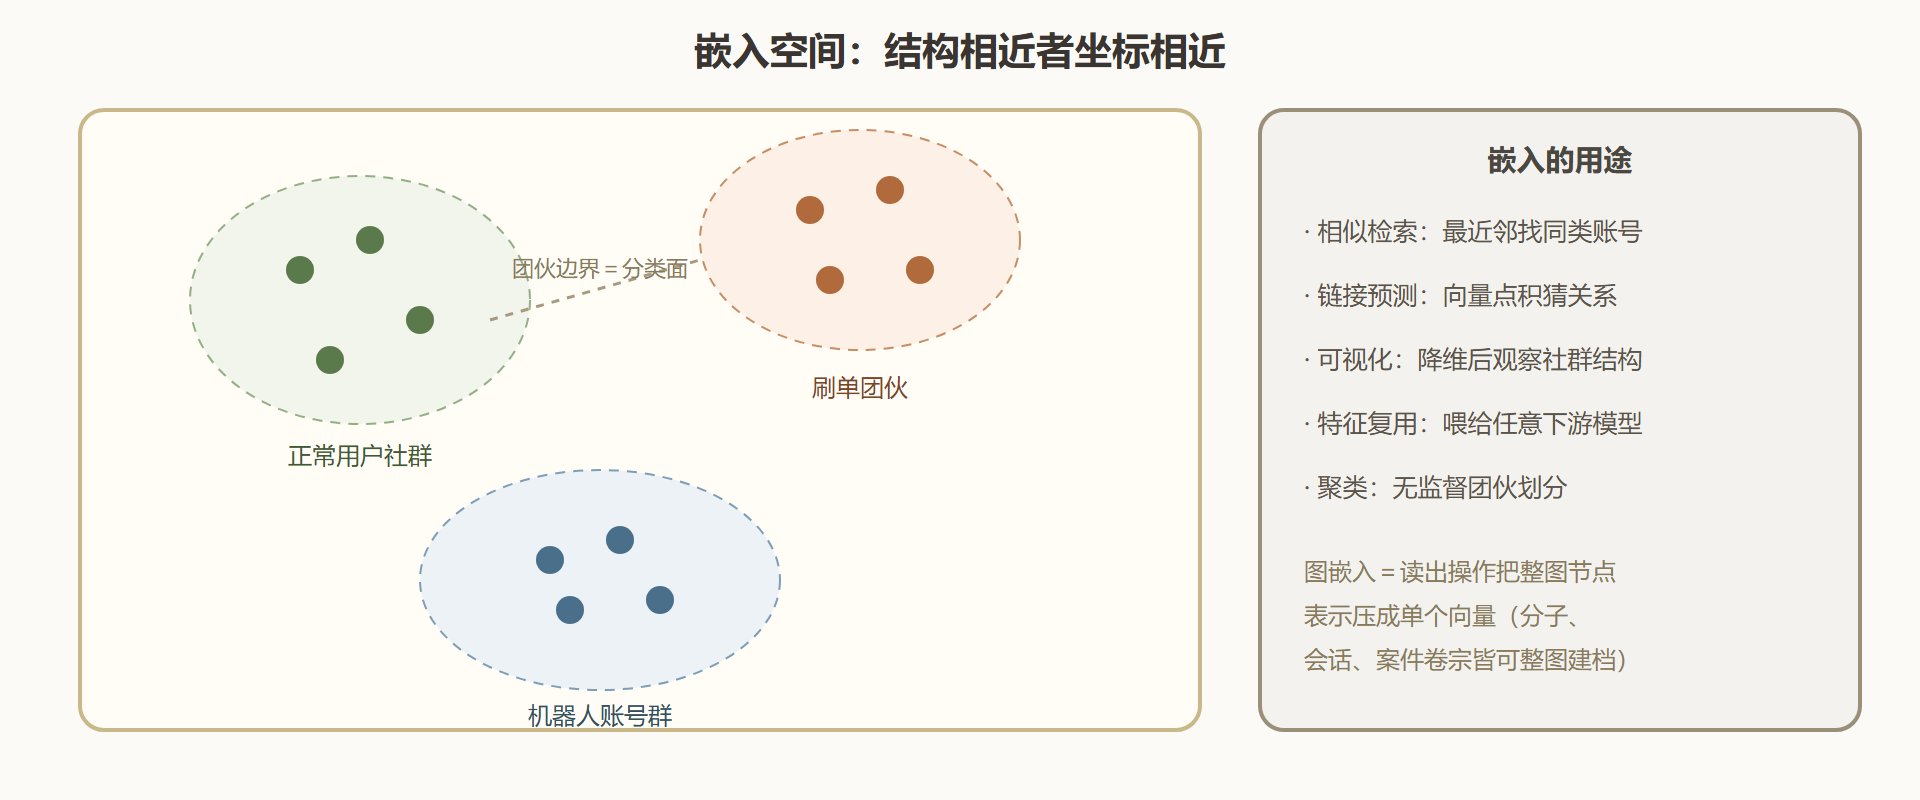
侦探社的档案室有一面卡片柜:每个嫌疑人一张卡片,卡面上除了文字摘要,还标着一串坐标——把卡片按坐标钉在软木板上,关系紧密的嫌疑人自然聚成几团。这面软木板就是嵌入空间的具象:嵌入是把节点映射成低维向量,并让向量间的距离或夹角反映节点间结构关系的操作。本节是第二章的收官:前三节把走访规程讲完,现在看走访的最终产出如何沉淀、如何复用。老资格的做法(随机游走家族)与新时代的做法(图神经网络)都通向同一面软木板,但适用边界截然不同。
图:嵌入空间——软木板上的嫌疑人分布
老路:随机游走家族
DeepWalk 的思路出奇地朴素:在图上反复做随机游走,把走过的节点序列当作"句子",用词向量模型的 Skip-gram 训练每个节点的嵌入——共同出现在游走序列里的节点,向量被推近;不共现的推远。由于游走容易在社区内部打转,社区内节点大量共现,嵌入空间里自然形成团块。node2vec 在此基础上给游走加了两个可调偏置:偏向宽度优先使嵌入反映结构相似性(同角色节点靠近,比如所有"枢纽账号"聚成一团),偏向深度优先则反映同属一团的等价性。加上负采样技巧,这套"游走加词向量"流水线在浅层时代几乎统治了图表示学习。它的局限也很清楚:其一,直推式——每个节点的向量是单独训练的参数,新节点入场必须重训或增量训练;其二,只用结构不用属性——节点特征与嵌入过程脱节;其三,游走是随机的过程,嵌入质量对采样波动敏感。
import numpy as np import networkx as nx rng = np.random.default_rng(11) # 两个社群+一个桥节点的小图 G = nx.Graph([(i, i+1) for i in range(5)] + [(6, 7), (7, 8), (8, 9), (9, 10), (6, 10)] + [(5, 6)]) # 步骤一:随机游走采"句子" def random_walks(G, num_walks=40, walk_len=12): walks = [] nodes = list(G.nodes()) for _ in range(num_walks): rng.shuffle(nodes) for s in nodes: walk, cur = [s], s for _ in range(walk_len - 1): nbrs = list(G.neighbors(cur)) if not nbrs: break cur = rng.choice(nbrs) walk.append(cur) walks.append(walk) return walks # 步骤二:统计"共现窗口"内的节点对,构造 PPMI 矩阵(Skip-gram 的简化替身) def ppmi(walks, vocab, window=3): idx = {v: i for i, v in enumerate(vocab)} co = np.zeros((len(vocab), len(vocab))) for w in walks: for i, u in enumerate(w): for j in range(i+1, min(i+window+1, len(w))): co[idx[u], idx[w[j]]] += 1 co[idx[w[j]], idx[u]] += 1 p = co / co.sum() pu, pv = p.sum(1, keepdims=True), p.sum(0, keepdims=True) with np.errstate(divide='ignore', invalid='ignore'): pmi = np.log(p / (pu @ pv)) ppmi_m = np.maximum(pmi, 0) ppmi_m[~np.isfinite(ppmi_m)] = 0 return ppmi_m vocab = list(G.nodes()) M = ppmi(random_walks(G), vocab) # 步骤三:截断 SVD 取前几维作为嵌入(词向量的经典降维替身) U, S, _ = np.linalg.svd(M, full_matrices=False) emb = U[:, :2] * np.sqrt(S[:2]) from collections import defaultdict groups = defaultdict(list) for v, e in zip(vocab, emb): tag = "社群一" if v < 5 else ("社群二" if v > 5 else "桥") groups[tag].append((v, np.round(e, 2))) for k, vals in groups.items(): print(k, vals) # 两个社群在二维平面上各自聚拢、方向不同;桥节点落在两者之间——结构信息成功沉淀
新路:图神经网络嵌入
图神经网络做嵌入的方式在第二章已经铺好:输入特征矩阵经过数层消息传递,输出的节点表示本身就是嵌入。与随机游走家族相比,它补齐了三块短板。归纳能力:模型学的是聚合函数而非逐节点参数,训练时没见过的节点带着特征与邻边入场即可直接推断——GraphSAGE 论文的标题"inductive representation learning"说的正是这件事。属性融合:节点特征从第一层就参与消息传递,嵌入同时携带结构信息与内容信息。任务端到端:嵌入层与任务头共享损失,表示为目标而定制,不再是"先无标签预训练、再下游微调"的两段式。工程实践中两条路线并非取代关系:无特征或弱特征、静态图、要快速出基线时,游走家族依然好用;有丰富特征、节点持续新增、要端到端优化时,图神经网络是正解。
import torch import torch.nn.functional as F from torch_geometric.nn import GCNConv, global_mean_pool from torch_geometric.data import Data # 节点嵌入:两层 GCN 的输出即节点级嵌入(模型细节下一章展开) x = torch.eye(11) # 无特征图用单位阵起步 edge_index = torch.tensor([[0,1,1,2,2,3,3,4,5,6,6,7,7,8,8,9,9,10], [1,0,2,1,3,2,4,3,6,5,7,6,8,7,9,8,10,9]], dtype=torch.long) conv1, conv2 = GCNConv(11, 8), GCNConv(8, 4) with torch.no_grad(): h = conv2(conv1(x, edge_index).relu(), edge_index) print("节点嵌入维度:", h.shape) # 11 个节点 × 4 维 # 图嵌入:读出操作把节点表示压成单向量 batch = torch.zeros(11, dtype=torch.long) # 全部节点属于同一张图 g_vec = global_mean_pool(h, batch) print("图嵌入维度:", g_vec.shape) # 1 × 4 # 若 batch 里混入多张图的节点编号,global_mean_pool 会按图分组各自读出
图级读出的三种方案
把整张图压成一个向量(读出操作)有几种主流方案。均值读出对节点表示取平均,简单稳定,是图分类的默认起点;它与均值聚合同病相怜——节点数不同、成分相同的图可能撞出同一个向量。求和读出保留规模信息,分子场景里"有几个氧原子"影响溶解度,求和是更贴切的选择。注意力读出给每个节点学一个重要性权重再加权汇总,让模型自己决定"哪些节点能代表整张图",在节点贡献悬殊的任务(比如关键嫌疑人认定)上更贴身。层次化读出更进一步,先在小社区内读出、再把社区摘要读出为全图向量,模拟卷积网络里逐级池化的层级抽象。读出方案与 2.3 节的聚合函数共享同一套选型逻辑:看规模的证据价值、看节点的贡献差异。
本节要点
- 嵌入定义:节点到低维向量的映射,几何关系承载结构语义,相似检索与链接预测直接建立在向量运算上。
- 游走家族:随机游走加词向量,社区结构自动成团;局限在直推式、弱属性、采样敏感。
- 图神经网络嵌入:归纳式、属性融合、端到端,是带特征动态图的默认选择。
- 图级读出:均值、求和、注意力、层次化四档,选型逻辑与聚合函数一致——规模与贡献差异决定取舍。
第二章至此收官:走访规程、卷积来路、消化机制、档案沉淀已成体系。下一章打开装备库,五套经典办案手段将依次登场,每套都是本章总章程的一次具体化。