3.5 GIN 与变体鉴别科:表达能力的上限
3.5 GIN 与变体鉴别科:表达能力的上限
本节摘要:图同构网络(GIN)回答这样的理论问题——哪类聚合函数能最大限度区分不同的邻域多重集合?答案是与同构检验的经典算法对齐:求和聚合配单射消息函数。本节按五段式展开:鉴定委托的背景、多重集合撞车实验、与同构检验对齐的公式、NumPy 撞车复现与 PyG 实战;末段以鉴别科身份盘点混合模型与变体全景,为整个工具箱收尾。
案件背景:给装备定等级
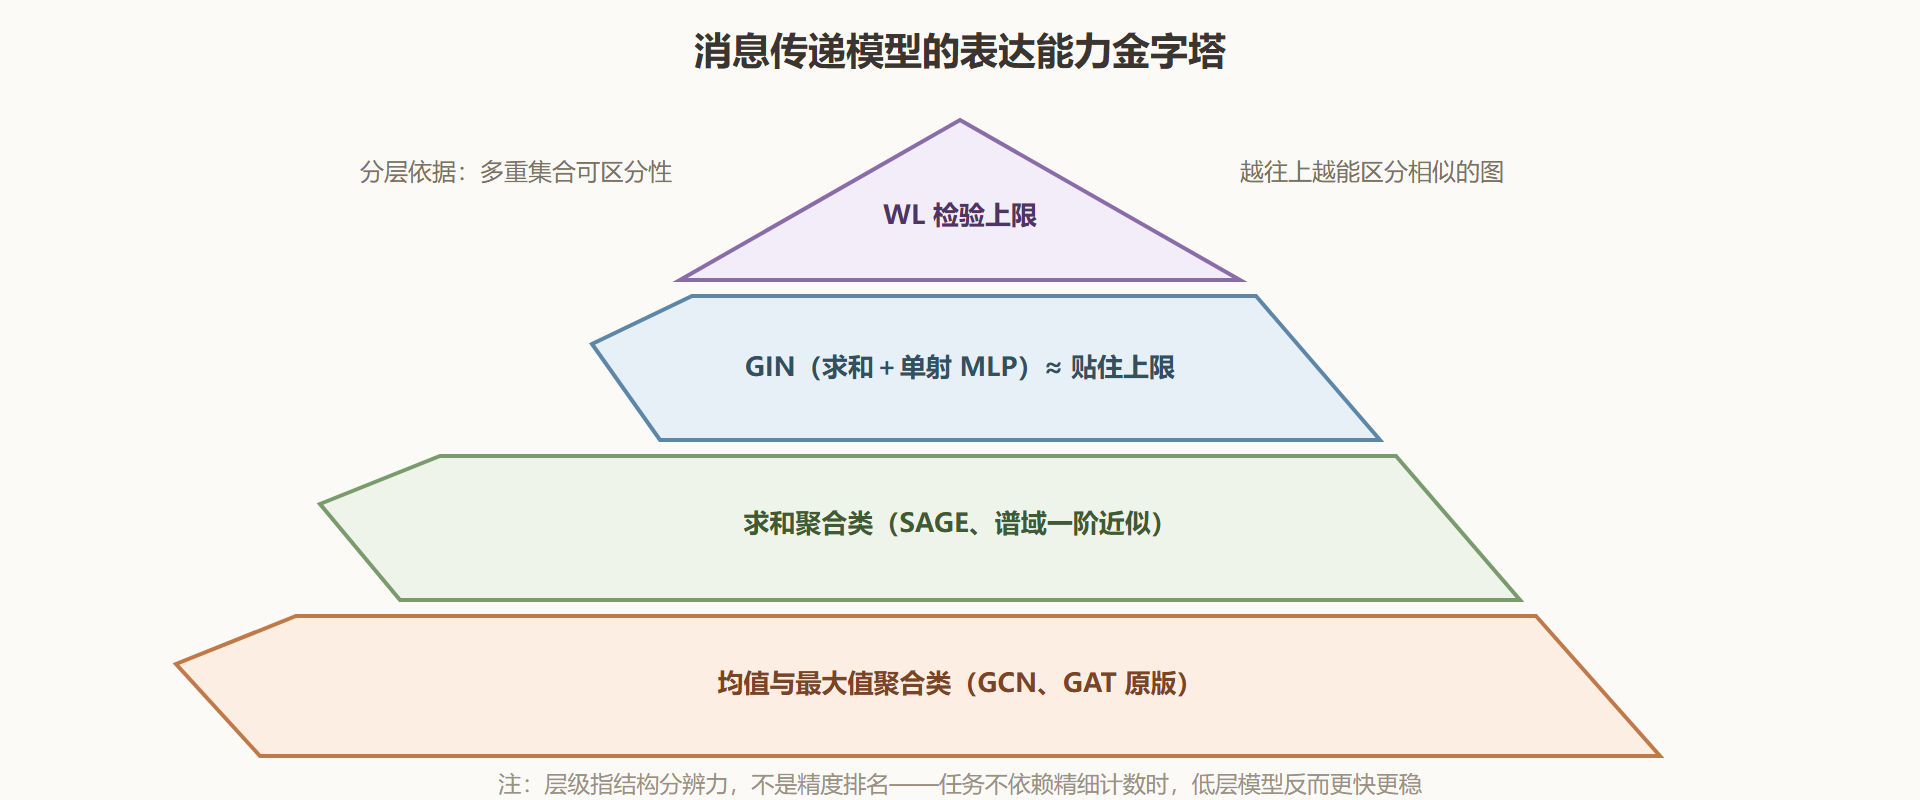
前四节的装备各有擅长,但鉴定科收到一份较真的委托:如果排除数据与调参因素,单看模型结构,它们的"分辨力"有没有等级之分?判例来自图论的经典难题——图同构判定:两张图结构是否完全相同(仅节点编号不同)。任何基于消息传递的图神经网络都无法超过同构检验经典算法(威尔夫-莱曼迭代检验,通称 WL 检验)的分辨力上限,这个结论把问题转化为:怎样的消息传递设计能贴住 WL 上限。答案就是 GIN——求和聚合加单射消息函数的多层感知机组合。这桩鉴定委托的价值在于给选型提供理论底气:当任务依赖"数清邻域里各类证据的个数"时(分子计数、结构指纹),聚合函数的选择不是风格问题,而是能力问题。
图:表达能力金字塔
机制拆解:多重集合的撞车实验
消息传递的聚合对象是"邻域特征的多重集合"——集合里允许重复元素,因为多个邻居可以有相同特征。表达能力问题因此等价于:聚合函数能否把不同的多重集合映射到不同的输出。均值聚合会撞车:"元素一"与"元素二倍数量"取均值结果相同(数量信息被除法抹掉);最大值聚合会撞车:"单个特征甲"与"特征甲重复任意次"取最大值相同(重复信息被丢弃);求和配单射消息函数则不撞车——多重集合的"元素与计数"都被完整保留。WL 检验的每轮迭代恰好是"邻域多重集合的重新着色",因此层数对齐 WL 轮数的求和式消息传递,分辨力也逐层对齐。GIN 的机制由此定型:消息函数取单射的多层感知机,聚合取求和,更新取"自身表示乘可学习系数再加聚合结果,过 MLP"——自身与邻域的关系用可学习的缩放系数平衡,避免信息被邻域淹没。
公式推导:从 WL 对齐到 GIN 层
WL 检验的迭代是:每轮把节点的当前颜色与"邻居颜色的多重集合"拼成新标签,压缩为新的颜色编码;迭代若干轮后比较两图的颜色分布。把"颜色"替换为"嵌入向量"、"压缩编码"替换为"单射函数",就得到 GIN 的层公式:新表示等于多层感知机作用于"自身表示乘以一加系数,加上邻域消息之和"。推导要点有三。其一,单射性靠多层感知机实现——通用逼近定理保证足够宽的 MLP 可逼近任意连续函数,而"和构造成对不同的输入必得不同输出"的组合单射性,通过把输入拆成"自身与多重集合"两部分分别编码再组合来保证。其二,系数(常记作 epsilon)可以是固定小量或可学习参数,控制"自身档案"相对"邻域证词"的分量。其三,堆叠层数对应 WL 迭代轮数,理论上贴住上限——但真实任务里,任务标签往往不要求全部分辨力,均值聚合的"平滑"反而可能是有效的归纳偏置,这正是金字塔注释强调"层级不等于精度排名"的原因。
代码实战:复现撞车与调用 GIN
先复现撞车实验——构造多重集合对,观察三类聚合的表现。
import numpy as np from collections import Counter # 待区分的邻域多重集合(元素允许重复) S1 = Counter({0: 1, 1: 1}) # {0, 1} 均值 0.5 S2 = Counter({0: 3, 1: 3}) # {0,0,0,1,1,1} 均值仍 0.5 S3 = Counter({2: 1}) # {2} 最大值 2 S4 = Counter({2: 4}) # {2,2,2,2} 最大值仍 2 def to_vec(S, dim=4): # 多重集合 → 计数向量 v = np.zeros(dim) for k, c in S.items(): v[k] = c return v def mean_agg(S): v = to_vec(S); return v / max(sum(S.values()), 1) def max_agg(S): v = to_vec(S); return (v > 0).astype(float) def sum_agg(S): return to_vec(S) print("均值聚合: S1→", mean_agg(S1), " S2→", mean_agg(S2), " 撞车:", np.allclose(mean_agg(S1), mean_agg(S2))) print("最大值聚合: S3→", max_agg(S3), " S4→", max_agg(S4), " 撞车:", np.allclose(max_agg(S3), max_agg(S4))) print("求和聚合: S1→", sum_agg(S1), " S2→", sum_agg(S2), " 撞车:", np.allclose(sum_agg(S1), sum_agg(S2))) # 求和保留了计数维度——唯一没有撞车的一档
再用 PyG 搭 GIN 并跑图分类骨架(求和读出与 GIN 的计数气质最搭)。
import torch import torch.nn.functional as F from torch_geometric.nn import GINConv, global_add_pool from torch_geometric.datasets import TUDataset dataset = TUDataset(root="/tmp/MUTAG", name="MUTAG") # 分子图分类:致变性判定 data0 = dataset[0] def make_gin_layer(dim): # GINConv 内部的 MLP 即"单射消息函数"的可学习实现 mlp = torch.nn.Sequential( torch.nn.Linear(dim, dim * 2), torch.nn.ReLU(), torch.nn.Linear(dim * 2, dim)) return GINConv(mlp) class GIN(torch.nn.Module): def __init__(self, in_dim, hid, num_classes): super().__init__() self.embed = torch.nn.Linear(in_dim, hid) self.c1, self.c2 = make_gin_layer(hid), make_gin_layer(hid) self.head = torch.nn.Linear(hid, num_classes) def forward(self, x, ei, batch): h = self.embed(x).relu() h = self.c1(h, ei).relu() h = self.c2(h, ei) return self.head(global_add_pool(h, batch)) model = GIN(dataset.num_features, 32, dataset.num_classes) out = model(data0.x, data0.edge_index, torch.zeros(data0.num_nodes, dtype=torch.long)) print("单分子前向输出:", out.shape, "(对应类别 logits)") # 训练循环与第三章 3.1 节同构:交叉熵+Adam,图级任务用 batch 把多个分子打包
变体对比:混合模型与工具箱全景
按鉴定科的归档习惯,最后把工具箱的改造手段列成全景(这一栏吸收原计划中"混合模型与变体"的全部内容)。改造主要发生在四个槽位:聚合函数(GCN 归一化、SAGE 均值池化、GAT 注意力、GIN 求和)、更新函数(拼接投影、门控、残差)、跨层连接(跳跃知识机制把各层输出拼接或注意力加权,缓解深层信息稀释)、传播方式(个性化 PageRank 式传播用少数参数换大感受野)。常见组合套路:异质图用"关系分路聚合"(关系图卷积,第六章展开);深网络用"残差加跳跃知识加归一化"三件套;快基线用"预计算传播加线性分类"。选型口诀浓缩成表。
| 任务特征 | 首选套路 | 理由 |
|---|---|---|
| 快基线、特征强 | SGC 或单层 GCN | 传播可预计算,速度压倒一切 |
| 节点持续新增 | GraphSAGE 系抽样归纳 | 流程式表示不绑定旧节点 |
| 邻域权重悬殊 | GAT 系注意力 | 权重随内容竞争产生 |
| 图级判别、结构计数 | GIN 求和+求和读出 | 贴住分辨力上限 |
| 邻域噪声大 | 均值聚合+残差 | 平滑偏置+梯度通路 |
| 需要边特征 | MPNN 框架定制层 | 边特征一等公民 |
💡 鉴别科的结案词:表达能力的层级是"能不能"的判断,工程选型是"值不值"的权衡——先问任务需要几成分辨力,再决定为它付出多少计算与噪声敏感性。
工具箱鉴定完毕。下一章带着全套装备出外勤:节点级、边级、图级三类结案任务,以及真实业务现场的完整卷宗。