5.1 训练阵型与规模化作战:全图、采样与小批次
5.1 训练阵型与规模化作战:全图、采样与小批次
本节摘要:全图训练把整张图整体装入显存,简单高效但规模受限;小批次训练靠邻居采样把每个样本的计算图钉在固定大小,代价是采样偏差与多轮重叠计算。本节比较全图、分层采样、子图采样、图分区四种阵型的开销模型,并给出按图规模与监督密度的选型流程。
显存爆掉的那个下午
复盘会的第一个案例很典型:工程师把业务图(数百万节点)照着教程的全图训练代码一跑,显卡直接爆掉——教程的引文数据集只有几千节点,显存开销完全不在一个量级。图神经网络的显存困境来自邻域的指数扩张:两层网络、每层抽几十个邻居,单个目标节点的计算图就涉及上千节点;全图训练更是把所有节点的中间表示同时驻留显存。本节把"训练阵型"当成正式的工程决策来讲:全图、分层采样、子图采样、图分区四种阵型,各有明确的开销模型与适用边界。第三章 3.2 节从模型角度讲过 GraphSAGE 的采样,本节从训练系统角度重新组织这份知识,落点是选型流程图。
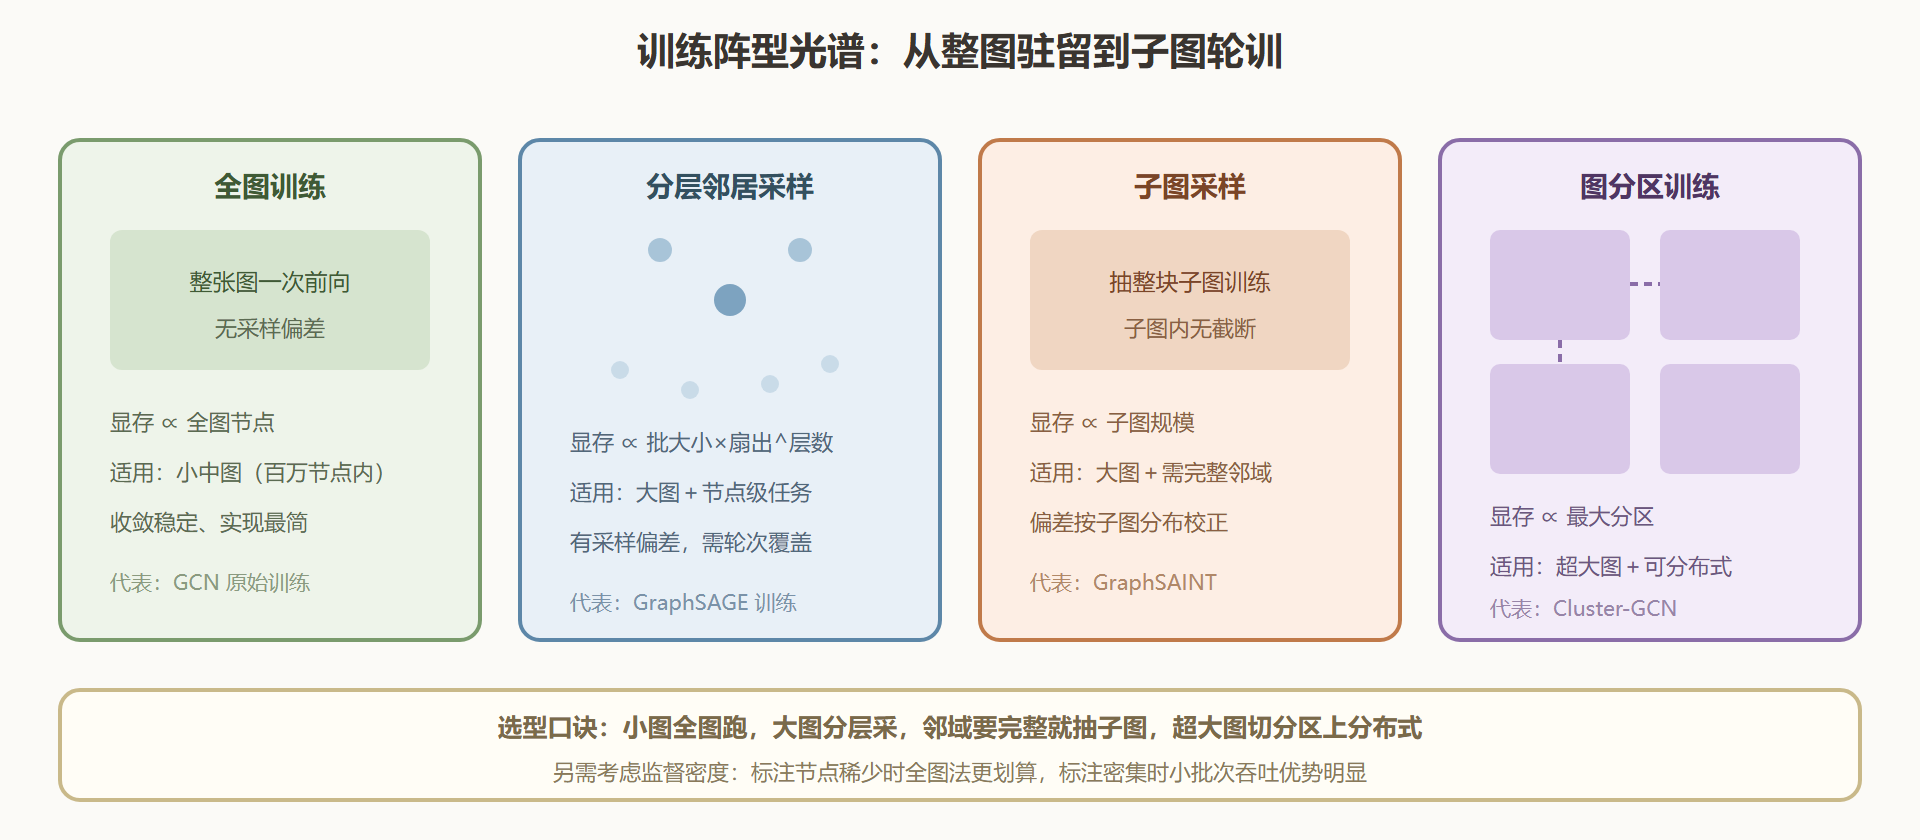
图:四种训练阵型的开销对比
开销模型:显存与算力随什么增长
全图训练的显存与全图节点数乘表示维数成正比——每层的中间表示、梯度、优化器状态都要为全部节点驻留空间,图过亿边就彻底没戏。分层邻居采样的显存由"批大小乘每层扇出的层数次幂"决定:扇出是每层抽的邻居数,两层、扇出各为十的时候单个样本涉及上百节点,扇出二十五就上千——扇出与层数是显存的两根主杠杆,调它们就是在"邻域覆盖率"与"批次成本"之间做交易。子图采样把显存锁定为子图规模,且子图内部的消息传递不被截断,层间一致性最好。图分区则把大图切成若干簇,逐簇训练,显存上限由最大分区决定,代价是割边上的信息丢失——分区算法要尽量把强连接留进同簇。
# 阵型开销的粗估实验:数一数不同扇出下单个批次的计算图规模 def ego_size(fanouts): """返回目标节点数为一时,分层采样涉及的总节点数""" size, frontier = 1, 1 for k in fanouts: frontier = frontier * k # 本层新展开的节点数 size += frontier return size for fanouts in [[10, 10], [15, 10], [25, 15], [10, 10, 10]]: print(f"扇出 {fanouts} → 单样本计算图节点数 ≈ {ego_size(fanouts)}") # [10,10]→111;[25,15]→401;三层 [10,10,10]→1111—— # 层数是比扇出更凶的杠杆:多一层,规模翻一个扇出倍数 batch = 1024 print(f"批大小 {batch} × 计算图 111 ≈ {batch*111:,} 节点/批次(含大量跨样本重复节点)") # 相邻目标节点的邻域高度重叠,分层采样的重复计算正是它的效率税
采样偏差与轮次覆盖
小批次阵型引入了新的误差源:每个批次只看到邻域的抽样,梯度的期望等于全图梯度,但方差随扇出变小而变大。工程上的对策有三条。提高扇外层、压扇内层:外层(第一跳)邻居对目标节点影响最直接,抽样份额应向外层倾斜。轮次覆盖:训练足够多的轮次让随机抽样反复洗牌,等价于对邻域做平均。方差监控:若训练曲线抖动剧烈,先怀疑扇出过小而不是模型过复杂。子图采样类方法还有自己的偏差校正:按子图被抽中的概率给损失加权,让估计无偏——这是选型时区别于朴素分层采样的技术卖点。
# 用 PyG 的 NeighborLoader 走一遍分层采样小批次训练(承接 3.2 节的骨架) import torch import torch.nn.functional as F from torch_geometric.datasets import Planetoid from torch_geometric.loader import NeighborLoader from torch_geometric.nn import SAGEConv data = Planetoid(root="/tmp/Cora", name="Cora")[0] loader = NeighborLoader( data, num_neighbors=[15, 10], # 外层多抽、内层少抽 batch_size=128, shuffle=True, input_nodes=data.train_mask, # 只从带标签节点出发建批次 ) class Net(torch.nn.Module): def __init__(self): super().__init__() self.c1 = SAGEConv(data.num_features, 32) self.c2 = SAGEConv(32, 7) def forward(self, x, ei): return self.c2(self.c1(x, ei).relu(), ei) net = Net() opt = torch.optim.Adam(net.parameters(), lr=0.01) for batch in loader: opt.zero_grad() out = net(batch.x, batch.edge_index) loss = F.cross_entropy(out[batch.train_mask], batch.y[batch.train_mask]) loss.backward(); opt.step() print("分层采样小批次训练就绪:扇出与层数决定显存上限")
推理阶段的阵型
训练阵型解决"学得动",推理阵型解决"服务得起"。全图推理只需一次前向即可拿到全部节点表示,适合静态图的批量评估;在线推理(新节点随时到)用归纳式模型加即时邻域收集,单请求延迟取决于邻域规模,扇出控制同样生效。工程上常把"已算好的节点表示"缓存下来,新请求只重算受影响的邻域——图结构变更时的增量计算是工业系统的核心课题,也是选型时评估框架能力的硬指标之一。
阵型选型清单
- 图在十万节点级以内:全图训练,省心且收敛稳,注意力放在模型与正则。
- 节点级任务、标注稀疏:全图半监督仍是首选,采样反而浪费结构信息。
- 亿级边、节点级任务:分层邻居采样,扇向外重内轻,监控梯度方差。
- 邻域完整性敏感(如需要精确计数):子图采样或图分区,避免截断偏差。
- 需要分布式扩展:图分区训练,分区质量决定割边信息损失。
阵型迁移还有条务实建议:不要在项目第一天就上最复杂的阵型。正确的路径是"全图训练验证思路、分层采样验证吞吐、分布式最后压轴"——每一步都有明确的验证目标,出了问题能快速定位是模型问题还是阵型问题。反过来,从分布式起步的项目往往连"模型是否有效"都还没验证,就已经被工程细节淹没,复盘时连责任都难划分。
阵型定了,下一个复盘议题是量刑标尺:损失函数与优化器怎么配,才能让监督信号不失真、训练过程不跑偏。