7.2 未破之案与新技术动向
7.2 未破之案与新技术动向
本节摘要:图学习领域有四桩公认的悬案——表达能力被标准消息传递的理论上限锁死、可扩展性被邻域指数扩张绑架、动态性受制于流式更新与遗忘、泛化性在跨图分布偏移前失守。对应的新技术动向包括:突破上限的高阶与子图方法、图基础模型与"图即文本"的统一接口、图与大语言模型的互补融合、神经算法推理。本节逐案归档现状与路线。
悬案墙上的四张通缉令
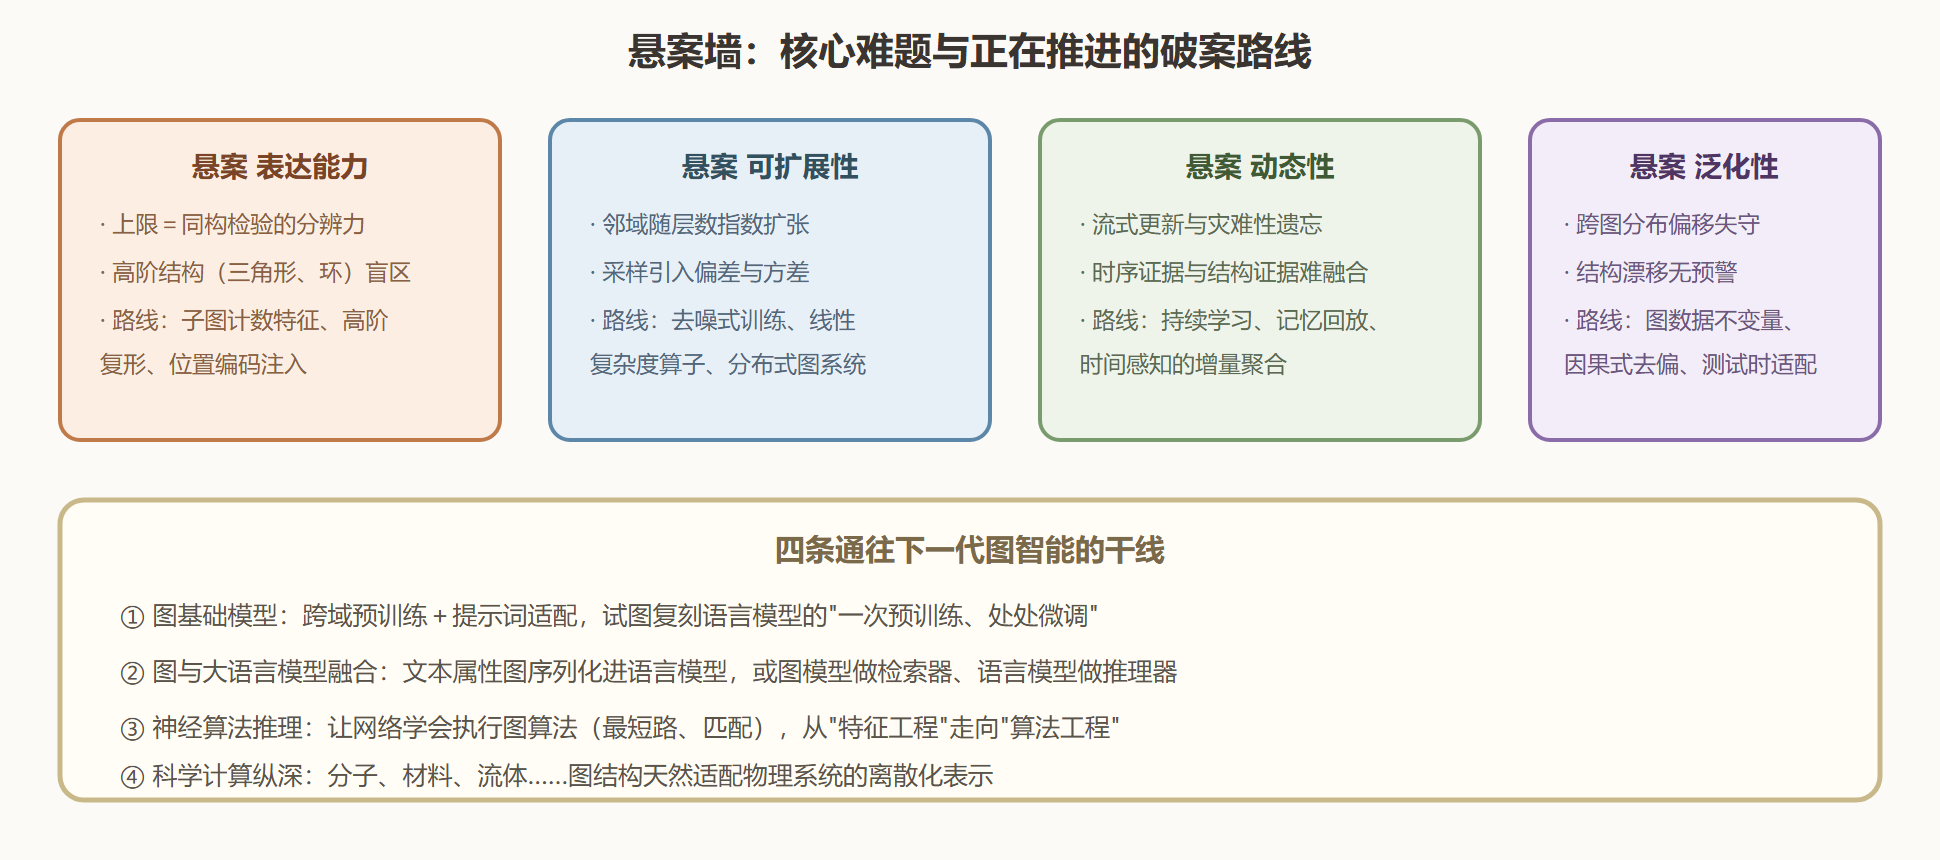
档案室最里面有一面悬案墙,钉着四张通缉令。第一张写着表达能力:第三章 GIN 一节已经证明,标准消息传递的分辨力被同构检验的经典算法封顶—— WL 检验分不出的图,任何堆层数的消息传递都分不出,而 WL 检验分不出的图对(某些规则结构)在化学与密码学里真实存在。第二张写着可扩展性:邻域随层数指数扩张的结构性矛盾,采样只是缓解不是治愈,超大规模图上的训练仍是工程苦役。第三张写着动态性:图在变、模型在漂,流式更新时新知识覆盖旧知识的"灾难性遗忘"在图上尤其难解——节点的旧表示与新表示要跨版本对齐。第四张写着泛化性:跨图分布偏移(训练社交图、服务生物图;训练过去、服务未来)之下,图模型的性能衰减缺乏理论刻画,第七章第一节的偏移测试揭露的正是这桩案。四桩悬案相互纠缠:为破解表达能力堆深度的努力会撞上可扩展性与过平滑,动态图上的更新又常常以牺牲泛化为代价。
图:四桩悬案与对应的技术路线
逐一归档:现状与进展
表达能力案。突破上限的思路有三支。子图增强:把"三角形计数、环计数、最短路径"这类高阶结构算成特征注入模型,等于给侦探配上放大镜,看得见纯邻域聚合看不见的图案。高阶结构:把图提升为单纯复形等数学对象再定义消息传递,理论分辨力超过 WL 上限,代价是构造与计算成本。位置编码:给节点注入"在整个图里的坐标"(拉普拉斯特征向量、随机游走命中分布),弥补局部聚合对全局位置的失明——图 Transformer 一系正是靠位置编码把注意力机制搬到全图尺度。工程上这些手段已进入主流框架的工具箱,选型时要权衡"分辨力增益"与"预处理成本"。
# 高阶结构特征:三角形计数作为"放大镜"示例 import networkx as nx G = nx.Graph([(0,1),(0,2),(1,2),(2,3),(3,4),(4,5),(5,3)]) tri = nx.triangles(G) clu = nx.clustering(G) for v in sorted(G.nodes()): print(f"节点{v}: 三角形 {tri[v]}|聚类系数 {clu[v]:.2f}") # 节点0/1/2 参与{0,1,2}三角形,其余节点不在任何三角形里—— # 纯邻域聚合对这种"图案差异"不敏感,注入计数特征后才可区分
可扩展性案。路线从"算得动"走向"算得巧"。线性复杂度算子把聚合简化为可解耦的形式(先变换再传播的解耦设计让传播可以预计算),去噪式训练对全图做预测后按子图修正,分布式图系统解决多机协作的图切分与通信。实用建议:先把第五章的阵型光谱用足(很多"规模问题"其实是阵型没选对),再考虑引入新算子。
动态性案。持续学习的三板斧(正则化约束、记忆回放、参数隔离)在图上有图特有的变形:回放的不是样本而是"代表性的邻域快照",约束的不是普通参数而是聚合函数与时间编码。评估体系同样要跟着改——静态图时代的"一次划分一次终评"在流式场景完全失灵,替代方案是滚动窗口评估:按时间顺序推进训练与评测窗口,报告指标随时间的漂移曲线,曲线平稳的模型才算真正抗遗忘。工程上至少要做到"模型版本与图版本对齐+增量评估流水线"——图变了模型却没重训,是线上静默劣化的头号原因(第五章交付节的教训)。
泛化性案。图数据的不变量研究试图回答"哪些结构性质跨域稳定";因果式去偏在图上可操作化为"切断捷径边的影响";测试时适配让模型在服务现场用无标注信号轻量自校准。泛化难题还有个容易被忽视的侧面:结构的"语义漂移"——同样是好友边,不同平台的好友密度差异巨大,模型在稠密图上学会的聚合强度迁移到稀疏图上就会过头。缓解这类问题的实用手段包括度分布对齐(把训练图与目标图的度分布差异作为协变量校正)和聚合强度自适应(让归一化系数随目标图的密度可调)。对工程团队的诚实建议:跨域部署前先跑分布偏移测试(上一节的协议),量化落差再决定投入,不要指望"更大的模型"自动解决泛化。
# 结构漂移的量化:训练图与目标图的度分布对齐实验 import numpy as np import networkx as nx rng = np.random.default_rng(6) g_train = nx.barabasi_albert_graph(600, 6, seed=2) # 稠密:每次接六条边 g_target = nx.barabasi_albert_graph(600, 1, seed=3) # 稀疏:每次接一条边 deg_t = np.array([d for _, d in g_train.degree()]) deg_g = np.array([d for _, d in g_target.degree()]) # 用分位数向量对比结构分布(比只比均值敏感得多) qs = [0.1, 0.25, 0.5, 0.75, 0.9, 0.99] q_t, q_g = np.quantile(deg_t, qs), np.quantile(deg_g, qs) print("训练图度分位数:", q_t.astype(int)) print("目标图度分位数:", q_g.astype(int)) drift = np.abs(q_t - q_g) / (q_t + 1e-9) print("相对漂移:", np.round(drift, 2)) # 高分位处的漂移最刺眼:训练图的枢纽度数是目标图的数倍, # 模型在训练图学到的聚合强度对目标图必然过头——部署前就该看到这张表
给不同读者的行动清单
按身份领取各自的下一步。工程师:把悬案清单当"风险登记表"用——接项目时先判断哪桩悬案会咬到自己(大图项目先想可扩展性,流式项目先想动态性),提前把第五章的阵型与诊断工具备好。研究者:表达能力与泛化性两桩悬案的理论工具还稀缺,子图表达力刻画与图上分布偏移的形式化都是活跃方向,入门文献可从各自领域的综述入手。产品与决策者:记住"四桩悬案"意味着四类承诺不能随便许——"任何图都能处理""加机器就能扩""模型永远不过期""换个业务照样准",每句都对应一桩未破的悬案,谈判时把边界讲清楚比事后补救便宜得多。
新技术动向速评
图基础模型的愿景是把语言模型的"预训练加提示"范式移植到图上,难点在图没有天然的统一词表——节点与特征的语义跨域差异极大,"图即文本"(把文本属性图序列化成语言模型能读的序列)是目前最有活力的接口方案。图与大语言模型融合的两个流派互补:序列化派让语言模型直接读图文本,间接获推理红利;协作派让图模型做精确的结构检索与计算、语言模型做语义推理与解释,各守所长。神经算法推理瞄准"让网络学会执行经典图算法",意义在于把离散算法的精确性与神经网络的泛化性嫁接,最短路的神经版本已在路由优化里试水。给学习者的选路建议:紧跟"文本属性图加基础模型"这条干线(就业与研究的需求都旺),同时把经典消息传递的地基打牢——新干线全部建在它上面。
本节要点
- 四桩悬案:表达能力封顶、可扩展性受限、动态性易忘、泛化性脆弱,相互纠缠需组合施策。
- 破案工具箱:子图特征与位置编码补分辨力、解耦算子降复杂度、持续学习抗遗忘、不变量与偏移测试稳泛化。
- 四条干线:图基础模型、图语言融合、神经算法推理、科学计算纵深,文本接口是当前最大公约数。
- 工程姿态:先用量足现有工具(阵型、协议、诊断),再追新——悬案不会因为换新模型就自动告破。
技术边界归档完毕,最后一节回到侦探本人:权力越大、责任越重,图数据的伦理清单必须逐项验收。