1.2 图的表示:邻接矩阵与邻接表
1.2 图的表示:邻接矩阵与邻接表
本节摘要:邻接矩阵用二维数组存图,判断"两点间是否有边"只需一次数组访问,代价是点数平方级的空间;邻接表用"每个顶点挂一条邻居链表"的方式存图,空间与点数加边数成正比,遍历邻居极快。本节给出两者的完整对比、选型决策表与 Python 风格实现,并说明为什么绝大多数真实图(社交网络、路网)都落在邻接表这一边。
本节目标
阅读完本节,你应当能够:
- 写出给定图的邻接矩阵和邻接表;
- 从空间、查边、遍历邻居三个维度比较两种表示法;
- 根据稠密度和算法需求做出表示法选型;
- 在邻接表上实现带权图的存储,并为第 2、3 章的算法做好接口准备。
一、为什么要纠结表示法
上一节我们把问题翻译成了图,但计算机里没有"图"这种东西,只有数组和链表。表示法决定了每个基本操作的价格:
- "这两个点之间有边吗?"(查边)
- "这个点有哪些邻居?"(遍历邻居)
- "整个图要占多少内存?"(空间)
不同的算法对这三个问题的问法频率完全不同。Kruskal 算法反复扫边集、几乎不查单个点对;Dijkstra 算法每轮都要遍历当前点的全部邻居。选错表示法,复杂度可能整体差一个量级。这不是 premature optimization——它是算法设计的一部分。
二、邻接矩阵:一整张"关系表格"
邻接矩阵是一个二维数组,行列都对应顶点。若顶点 i 与顶点 j 之间有边,则矩阵第 i 行第 j 列为 1(带权图为权重),否则为 0(带权图常用一个足够大的"无穷大"值)。
以一个 4 顶点的无向图为例:边为 A-B、A-C、B-C、B-D。
A B C D A 0 1 1 0 B 1 0 1 1 C 1 1 0 0 D 0 1 0 0
注意对角线为 0(无自环),且无向图的矩阵沿对角线对称——每条边在矩阵里出现两次。有向图则不一定对称:第 i 行第 j 列为 1 表示"从 i 指向 j"。
邻接矩阵的优点:查边只要看一眼格子,时间恒定;实现简单,两层循环就能枚举一切。缺点也直白:空间是点数的平方。存一个 100 万顶点的社交网络(哪怕每人只有几十个好友),矩阵要 10 的 12 次方个格子,内存直接爆炸;而且遍历一个点的邻居要扫完一整行,绝大多数扫到的都是 0。
三、邻接表:只为存在的边付钱
邻接表为每个顶点维护一个邻居列表,只记录真实存在的边。上面的图用邻接表表示:
A: [B, C] B: [A, C, D] C: [A, B] D: [B]
带权图中,每个邻居改存"目标点 + 权重"二元组。两种表示的直观差异:
Python 风格的带权邻接表(字典套字典,是后续章节代码的统一起点):
graph = { 'A': {'B': 4, 'C': 1}, 'B': {'D': 2}, 'C': {'B': 3, 'D': 5}, 'D': {} } # 遍历 A 的所有邻居及其权重 for neighbor, weight in graph['A'].items(): print('A 到', neighbor, '距离', weight) # 查询 A 与 B 之间是否有边:'B' in graph['A']
原始文集还提到过一个实用细节:邻接矩阵常配合"顶点编号从 0 连续排布"使用,矩阵下标即顶点编号;而邻接表配合哈希表(如上例的字典)可以直接用字符串当顶点名,省去编号映射。工程里两者常组合使用——外部用名字,内部转编号。
四、三笔账一起算:完整对比与选型
| 维度 | 邻接矩阵 | 邻接表 |
|---|---|---|
| 空间复杂度 | 顶点数平方 | 顶点数加边数 |
| 查询两点间是否有边 | 恒定时间 | 正比于该点度数 |
| 遍历一个点的全部邻居 | 扫一整行,正比于顶点数 | 正比于该点度数 |
| 增加一条边 | 一次写入 | 链表/列表追加 |
| 判断整个图的边数 | 需数一遍矩阵 | 直接可维护计数 |
| 适用图型 | 稠密图、点数小 | 稀疏图、点数大 |
| 典型场景 | Floyd-Warshall 的距离矩阵 | 路网、社交网上跑 Dijkstra |
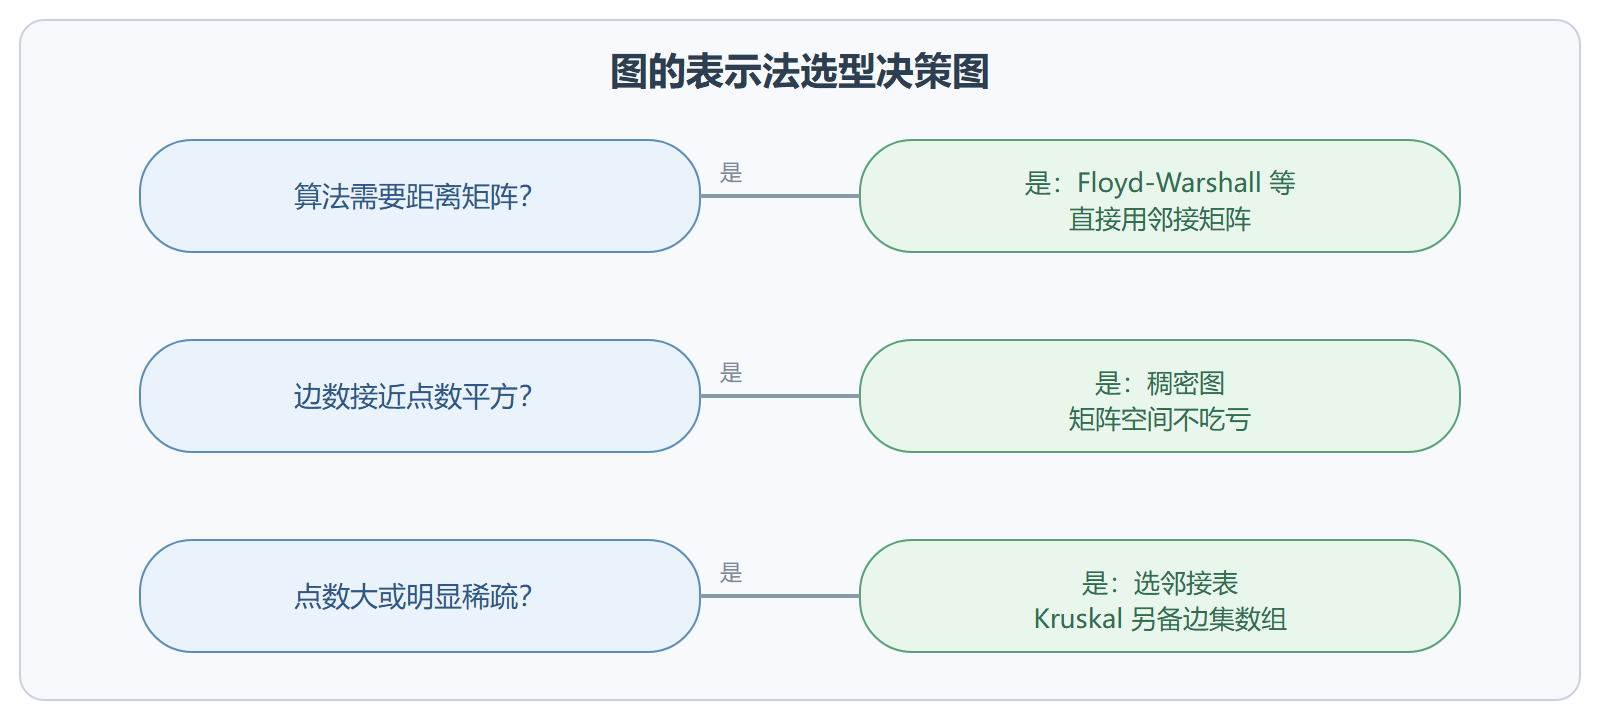
选型经验可以压缩成三句话:点数小(几千以内)且稠密,矩阵省心;点数大或稀疏,必选邻接表;算法本身需要矩阵结构(如 Floyd-Warshall 的动态规划表),就直接用矩阵。 判断"稀疏"的粗略标准:边数明显低于点数平方(比如低于其百分之一)。真实世界的图几乎全是稀疏图——社交网络平均度数不过几百,路网平均路口度数只有 3 左右,远够不上平方级。
此外,还有第三种表示:边集数组(把所有边放进一个列表,每条边记录起点、终点、权重)。它查边和遍历邻居都慢,但 Kruskal 算法要做的第一件事就是把边按权重排序,边集数组反而是最顺手的输入形态。第 3 章会实际用到。
图结构选型决策
⚠️ 常见坑:带权图用邻接矩阵时把"无边"初始化为 0。查边时 0 和"权重恰好为 0 的边"无法区分,而且 0 会被某些算法当成合法路径长度。正确做法是用一个足够大的哨兵值表示无穷大,或在邻接表里干脆不存不存在的边。
💡 关键直觉:邻接矩阵为"所有可能的关系"预付了内存,邻接表只为"实际存在的关系"付费。真实世界的关系网普遍稀疏——这就是为什么开源图计算库几乎清一色建立在邻接表(或其压缩变体 CSR)之上。
四、深入一层:空间之外的三笔隐性账
选型时除了空间与时间,还有三笔容易被忽略的账。
缓存友好性。邻接矩阵是一整块连续内存,顺序扫描时 CPU 缓存命中率极高;邻接表的链表实现节点散落各处,每跳一步都可能是一次缓存未命中。这解释了一个反直觉现象:在中等规模的稠密图上,"复杂度更差"的矩阵遍历有时跑得比邻接表还快。工程上的折中方案是把邻接表做成"数组套数组"的紧凑形态(如 CSR:一个偏移数组加一个邻居数组),既保线性空间又保连续访问。
构建成本。矩阵的初始化是平方级——即使图还没加边,光"开一张空表"就要付出满额代价;邻接表按需增长,边来一条付一条。对"顶点极多、边很少"的图(比如数千万用户的稀疏关注网络),矩阵连初始化都承受不起。
可变性。两类结构都方便加边;删边则矩阵占优(格子清零即可),邻接表的链式结构删除需要先定位,代价与度数相关。如果你的场景是"频繁删除边 + 频繁查询点对",矩阵的恒定时间查边会重新变得值钱——选型永远跟着操作频率走,而不是跟着教条走。
常见疑问解答
带权图里"无穷大"该设多大?
设为"所有可能路径权重之和还大"的值即可,常用做法是取一个远超总边权和的常数。要小心两点:相加可能溢出(两个无穷大相加翻越整数上限),以及"无穷大加有限值仍应视为无穷大"的比较逻辑。Python 的浮点无穷大能自然处理这两点,静态类型语言则要显式设防。
邻接表用数组、链表还是字典?
数组(每点一个动态数组)缓存最友好,是竞赛与高性能库的主流;链表适合频繁删边的场景但缓存差;字典(哈希)支持字符串键与 O(1) 查边,开发期最省心。一个务实的路线是:原型用字典,压测发现瓶颈后再换数组加编号映射。
图很大存不下内存怎么办?
超过内存的图要考虑两件事:压缩与切分。压缩方向包括 CSR 编码、位图存邻接矩阵;切分方向把顶点分片到多机,跨机的边成为通信开销——这是分布式图计算框架的核心问题,第 5.2 节的"并行化"路径会再次提到。选型时要先问"图是否真的放不下",过早引入分布式是常见的复杂度灾难。
动手实验:亲手量一次反转点
用一个脚本生成两组随机图:一组固定一千个顶点,边数从一千递增到五十万;另一组固定稠密度,顶点数从一百递增到一万。分别用矩阵与邻接表实现"全图遍历",记录耗时并画成曲线。你会亲眼看到两条曲线的交叉——边数尚小时矩阵领先(缓存与实现简单),越过某个稀疏度后邻接表一路走低、矩阵被平方级拖垮。这个交叉点随语言、硬件、实现细节漂移,但"存在交叉"这件事本身不会变。做过一次这个实验,"按稠密度选型"就从口诀变成了经验。
建图的代码清单
无论用哪种表示,建图阶段有四步固定动作:读入顶点并建立编号映射;初始化存储结构(矩阵填零或无穷大、表开空容器);读入边并写入(无向图写两次、有向图写一次);统计校验(边数、自环数、最大度是否符合预期)。第四步最常被省略也最值钱——上游数据的一个格式变化(比如重复边暴增)往往在"最大度异常"上最早露头,五分钟的前置校验能省一整晚的排错。
还有第四种表示吗?
有,且在专业库里是主流:十字链表(有向图专用,每条边同时挂在起点的出边表与终点的入边表上,兼顾出边与入边的遍历)与邻接多重表(无向图专用,一条边只存一个节点但挂两个表)——两者都是邻接表的精细化变体,解决"边被存两份"的冗余。更现代的工程选择是前文提到的 CSR 压缩形态。理解这一族的关键始终不变:一切表示法都是"顶点指向邻居"的不同物理布局,逻辑上是同一张表。
补充一句实践观察:真实项目里最常见的组合是"外层字典加内层列表",即用顶点名直接索引、邻居用列表存储——开发效率与运行性能的平衡点,等性能压测报警后再向数组化迁移也不迟,过早优化在图存储上同样成立。
一节小结
- 邻接矩阵:二维数组,查边恒定时间,空间为顶点数平方,适合稠密图与点数小的图。
- 邻接表:每顶点一条邻居列表,空间为顶点数加边数,遍历邻居正比于度数,是稀疏大图的标准选择。
- 第三选项:边集数组面向"按边处理"的算法,Kruskal 排序边时最顺手。
- 选型口诀:要矩阵的算法用矩阵;稠密小图用矩阵;其余一律邻接表。
- 带权存储:邻接表存"邻居 + 权重"二元组,无边的语义靠"不在列表里"表达,避免 0 值歧义。
- 编号与命名:内部用连续编号配合数组,外部用名字配合哈希表,两层各取所长。
表示法定了,图就能"跑"起来了。下一节讲遍历——DFS 与 BFS 这两个骨架,几乎出现在后面每一个进阶算法的内部。