第2章 最短路径
第 2 章 · 最短路径
章节摘要:最短路径问题研究"从一个顶点到另一个顶点,边权之和最小的路径",是导航、路由、物流调度的算法内核。本章按"单源—全源—特殊图"展开:单源一线讲 Dijkstra 的贪心与堆优化、Bellman-Ford 的迭代松弛与 SPFA 的队列改进;全源一线讲 Floyd-Warshall 的三重循环动态规划与 Johnson 的"重赋权"技巧;最后讲 DAG 与无权图这两类可以"抄近道"的特例。读完本章,你面对任何最短路径需求都能报出正确的算法与复杂度。
本节导读
阅读完本章,你应当能够:
- 精确描述松弛操作,并说明它是所有最短路算法的共同原子动作;
- 解释 Dijkstra 的贪心为何在非负权下正确、遇到负权边为何失效;
- 写出 Bellman-Ford,并用它检测负权环;
- 说明 SPFA 的队列优化原理与"能被卡掉"的风险;
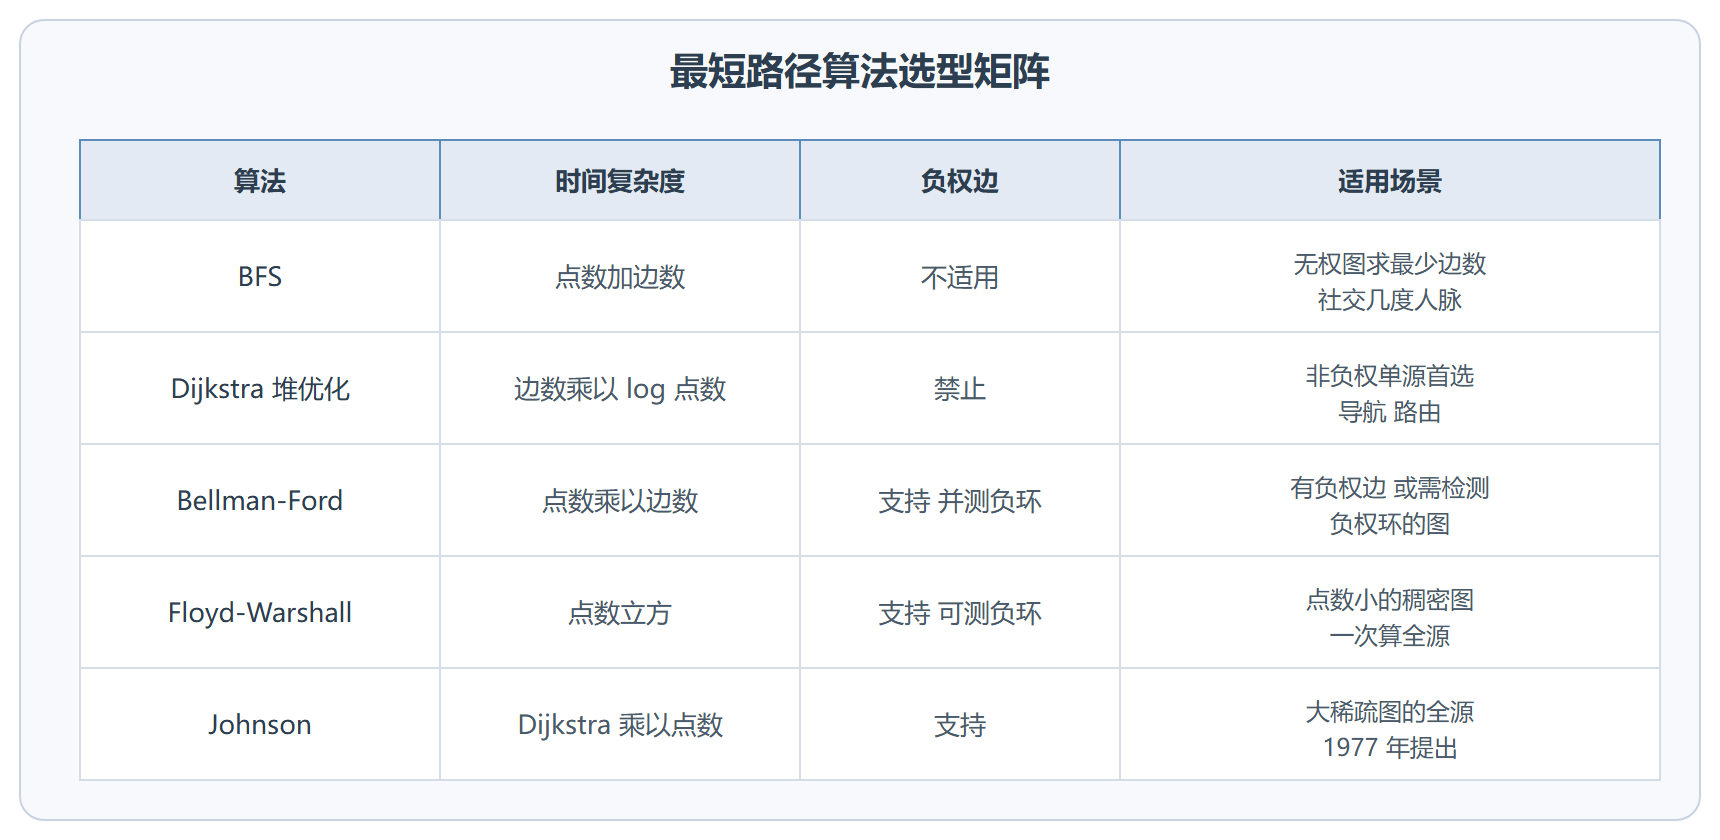
- 根据图的规模、稠密度、边权符号在五大算法中选型;
- 在 DAG 上用拓扑序线性时间求解,在无权图上直接 BFS。
核心概念速览
一切最短路算法都在做同一件事:反复松弛,区别只在"以什么顺序、挑哪些边松弛"。
最短路径算法选型全景
子章节导航
2.1 Dijkstra 算法
非负权单源最短路的标配。讲清贪心的不变量、堆优化的由来、手算模拟与失效场景。
2.2 Bellman-Ford 与 SPFA
当边权可以为负,贪心不再安全。Bellman-Ford 用全量迭代换正确性并顺便检测负环,SPFA 用队列让它平均跑得更快。
2.3 Floyd-Warshall 与 Johnson
要的不是"一个源",而是"所有点对"。三重循环的动态规划 vs "重赋权 + 跑遍 Dijkstra"的组合拳,分别统治稠密图与稀疏图。
2.4 DAG 与无权图上的最短路径
两类可以抄近道的图:DAG 借拓扑排序线性求解(还能顺带求最长路),无权图直接把 BFS 当最短路用。
子章节之间的逻辑关系
本章的暗线是"松弛的调度策略":Dijkstra 按"当前最近"调度,Bellman-Ford 按"全量轮询"调度,SPFA 按"谁被更新谁上岗"调度,Floyd 按"中转点"调度,DAG 按"拓扑序"调度。
松弛操作(共同原子动作) ├── 单源:Dijkstra(非负权)→ 失效 → Bellman-Ford / SPFA(负权) ├── 全源:小稠密图 Floyd-Warshanll ← 拆成多次单源 → 稀疏图 Johnson └── 特例:DAG 按拓扑序松弛一次即终 / 无权图 BFS 天然按层次松弛
先学 Dijkstra 才能理解 Johnson(它内部跑 Dijkstra);先学 Bellman-Ford 才能理解 SPFA 与 Johnson 的重赋权合法性来源。建议顺序即小节顺序。
常见疑问解答
面试手写最短路,默认写哪一种?
默认 Dijkstra 堆优化版。它是"非负权 + 单源"这一最常见设定的标准答案,代码量适中,还能顺势考察优先队列与懒删除的细节。若面试官追问负权边,再展开 Bellman-Ford;追问全源,再谈 Floyd 与 Johnson 的分工。一主两备的准备策略比平均用力更有效。
这些算法在真实系统里是"裸跑"的吗?
几乎都不是。真实导航系统在 Dijkstra 之上叠加分层路网、预处理索引与双向搜索;路由协议把最短路做成了分布式协议的一部分。但所有工程变体的正确性根基仍然是本章的原始算法——理解了"为什么贪心对、为什么迭代收敛",看变体论文才不会迷路。
学完本章最容易被问倒的盲区?
两个:一是"什么时候不能用 Dijkstra"(负权边,以及为什么负权会击穿贪心——2.1 节的反证要能张口就来);二是"Floyd 的三重循环为什么中转点必须在最外层"(动态规划的阶段变量,2.3 节)。这两问几乎是技术面检验深度与否的试金石。
本章的自测清单
五题自查:默写松弛语句并解释语义;说明 Dijkstra 贪心正确性依赖的前提与失效原因;写出 Bellman-Ford 的轮数上限及其理由;解释 Floyd 中转点为何必须最外层;给出"依赖链求总工期"的建模与算法选择。全对说明你已经把"松弛的调度策略"这条暗线握在手里,可以进入生成树的世界。
章末的一句提醒
最短路径是三大问题中"变形"最多的一族:单源、全源、点对点、带负权、动态权重、分层加速——变体清单还能列很长,但它们全部建立在"松弛"这一个动作之上。学完本章后遇到陌生变体,先找它的"松弛调度策略",找到之后,新算法就只是老朋友换了件外套。
最后交代一句阅读节奏:本章四节最好按序读完,因为 Johnson 的重赋权要用到 Dijkstra、SPFA 的队列要用到 Bellman-Ford 的收敛理论,跳读会让后半程的概念凭空多出几个"为什么"。
前置知识与后续延伸
- 前置:第 1 章的邻接表与 BFS(Dijkstra 是 BFS 的加权升级版)、优先队列的概念(第 5 章会展开实现细节)。
- 为后续铺垫:Dijkstra 的堆优化是第 5 章性能分析的主角案例;最短路径的"松弛"思维将在第 4 章最大流的"增广"中再次出现——两者都是"发现更好的解就修正"的迭代过程。