社交网络分析:从连通到社区发现
社交网络分析:从连通到社区发现
「small world」,小世界——社会学家 Stanley Milgram 的连锁信实验让这个词流行起来:信件沿着熟人链条传递,竟只用寥寥几跳就从美国中部的小镇到达了波士顿的股票经纪人。凯旋检阅的第一场把战场设在人际连接上:好友关系、关注关系、合作关系统统抽象成图,人就是顶点。本节检阅全册兵法在社交战场的成色:连通性与中心性回答"谁在网络的要害位置",社区发现回答"人群沿着什么边界抱团",随机图对照回答"你看到的结构是不是错觉"。第 4、6、9 章的部队在此集结点验。
先体检再分析:连通与直径
拿到一张社交图,第一步不是急着算指标,而是做结构体检。连通分量清点(第 4 章)告诉你这张网碎成几块——真实社交平台通常是"一个巨型分量加一堆边缘孤岛",孤立账号、弃用小号、封闭小圈子各有生态。块内做一次广度优先(第 3 章)又能拿到层次分布与直径的近似——直径是"最远的两跳距离",它决定了信息扩散的最坏延迟。
import networkx as nx def network_health(G): """社交图体检:分量结构、密度、平均度""" comps = sorted(map(len, nx.connected_components(G)), reverse=True) n, m = G.number_of_nodes(), G.number_of_edges() density = 2 * m / (n * (n - 1)) if n > 1 else 0 return { "分量数": len(comps), "最大分量占比": comps[0] / n, "孤立顶点数": sum(1 for c in comps if c == 1), "密度": round(density, 4), "平均度": round(2 * m / n, 2), } # 造一张带小圈子的仿真社交网 social = nx.relaxed_caveman_graph(6, 8, 0.18, seed=7) social = nx.convert_node_labels_to_integers(social) print(network_health(social))
体检输出里"最大分量占比"接近一而仍有孤立顶点,正是社交平台的典型形态——巨型分量的存在性本身就是第 9 章相变理论的现实回声。
中心性:四把衡量"要害"的尺子
"谁最重要"不是一道题,是一族题——答案取决于你怎么定义重要。度中心性数邻居:谁的好友最多,营销学叫"节点触达力"。接近中心性算到所有人的平均距离(第 5 章单源最短路的直接调用):离谁都近的人,传话最快。介数中心性数"被多少条最短路路过":桥型人物未必朋友多,但删掉他,人群之间就要绕远——组织情报学最看重这把尺子。特征向量中心性看"邻居的分量":被重要的人认识才算重要,社交影响力的经典度量,也是搜索引擎排序思想的直系祖先。
def centrality_parade(G): """四把中心性尺子同场点验""" import heapq deg = nx.degree_centrality(G) clo = nx.closeness_centrality(G) bet = nx.betweenness_centrality(G) eig = nx.eigenvector_centrality_numpy(G) def top(d, k=3): return [v for v, _ in heapq.nlargest(k, d.items(), key=lambda x: x[1])] return {"度": top(deg), "接近": top(clo), "介数": top(bet), "特征向量": top(eig)} parade = centrality_parade(social) for name, nodes in parade.items(): print(f"{name}中心性 前三名:", nodes)
四份榜单几乎必然不同——这正是度量设计的深意:指标是价值观的代码化。传播控场选介数,营销投放选度,声誉评估选特征向量;把榜单混着用,等于用错了价值观。
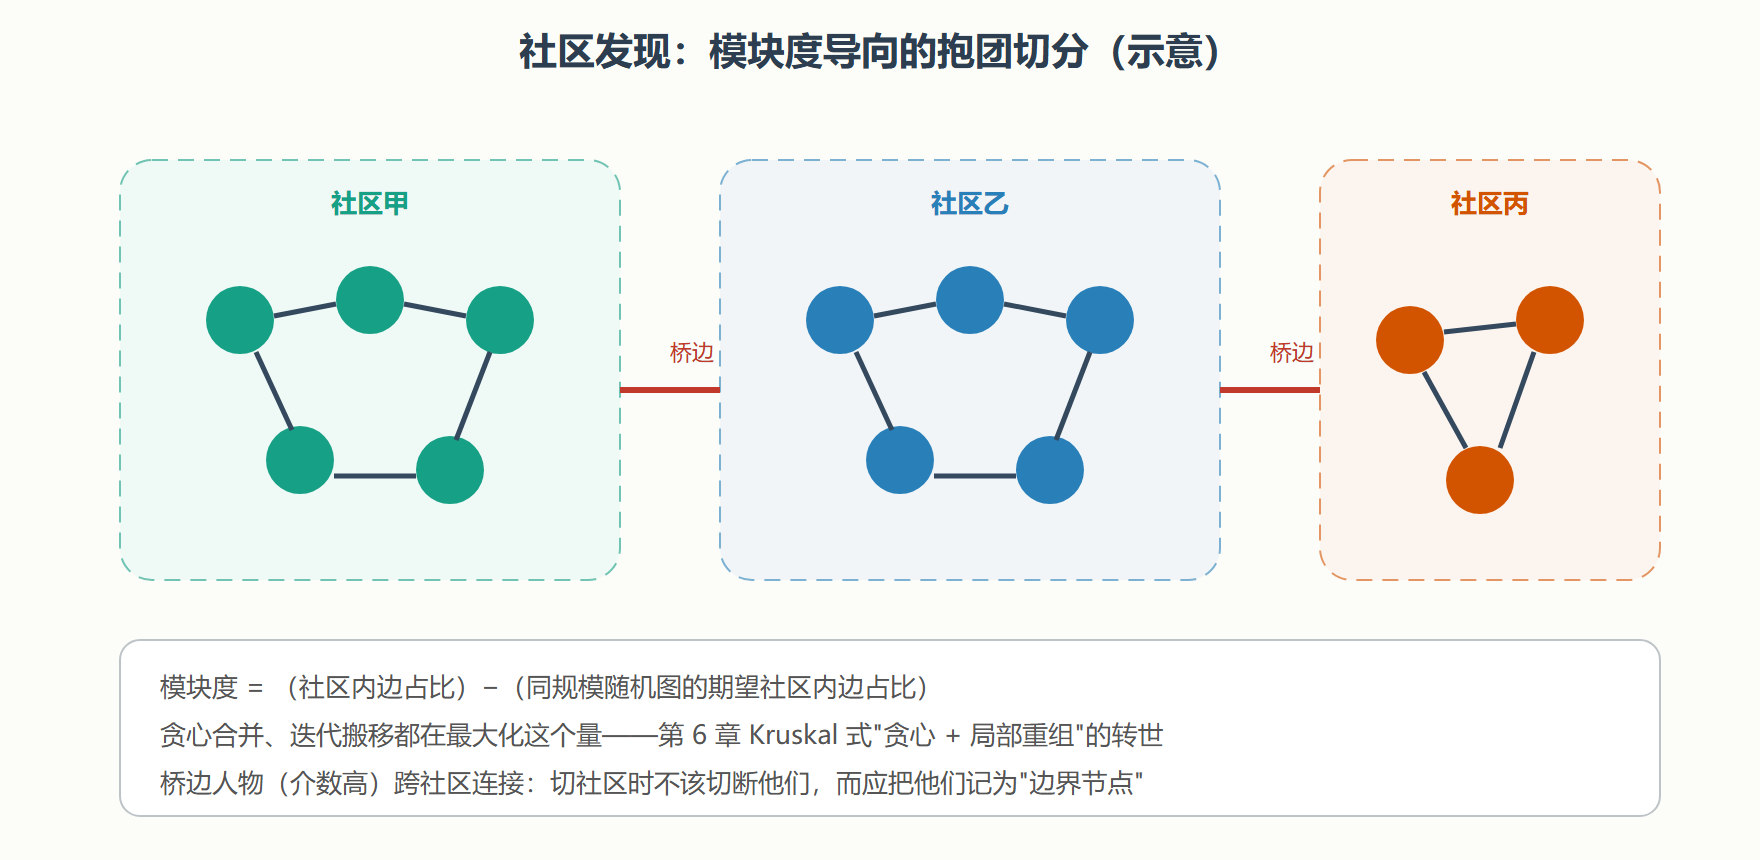
社区发现:切人群的算法族
社区发现问:能否把顶点切成若干组,使组内连接远密于组间。它没有唯一真答案——"社区"本身就是建模选择,于是算法呈谱系分布:谱聚类用拉普拉斯矩阵的特征向量把图"摊平再聚类",数学上与随机游走的慢收敛方向挂钩;Louvain 类贪心迭代地搬移顶点以最大化模块度(真实社区内边占比减去随机图期望值的那份"超出"),多层合并后自底向上长出社区层级;标签传播让每个顶点随多数邻居改标签,几轮收敛后天然分堆,快得能在亿级图上跑。三条路线风格迥异,但骨干都眼熟:贪心合并(第 6 章 Kruskal 的气质)、局部重组(第 7 章增广路的气质)、邻居扩散(第 3 章广度优先的气质)——经典兵法换个马甲重新列队。
def community_probe(G): """社区发现演练:贪心模块度 + 零假设对照""" from networkx.algorithms.community import greedy_modularity_communities comms = greedy_modularity_communities(G) mod = nx.algorithms.community.modularity(G, comms) return [sorted(c) for c in comms], round(mod, 3) comms, mod = community_probe(social) print("社区数:", len(comms), "| 模块度:", mod) def null_hypothesis_check(G, mod_observed, rounds=20): """随机图零假设:同规模同密度下模块度本来能有多高""" n, m = G.number_of_nodes(), G.number_of_edges() from networkx.algorithms.community import greedy_modularity_communities scores = [] for t in range(rounds): R = nx.gnm_random_graph(n, m, seed=500 + t) cs = greedy_modularity_communities(R) scores.append(nx.algorithms.community.modularity(R, cs)) avg = sum(scores) / len(scores) return f"随机对照平均模块度 {avg:.3f} vs 观测 {mod_observed}" print(null_hypothesis_check(social, mod))
零假设对照是社交分析的职业操守:同规模的随机图(第 9 章模型)也会被算法切出"社区",模块度有一个随机的地板值;观测值不显著高于地板,所谓的社区就只是噪声的形状。真实社交网的模块度通常数倍于随机地板——抱团是真的,但"多真"必须量化才算数。
应用与边界
中心性与社区的商业化身无处不在:影响力最大化(选哪些种子用户能让传播覆盖最广——它的精确解是难解问题,贪心加子模性分析给出可证明的近似比)、舆情关键人监测(介数榜单)、反欺诈的团伙挖掘(社区 + 异常密度)、推荐系统的好友圈召回。边界也要说清:社交网络的深度建模(传播动力学、网络演化、图表示学习)属于网络科学与图神经网络的地盘——站内专题册承接,本册把地基打牢即功德圆满。
⚠️ 常见坑:拿有向关注图直接跑无向指标。关注是单向的,转成无向图会把"被千万人关注的账号"与"关注了千万账号的账号"混为一谈——方向先想清楚,再决定用入度、出度还是对称化。
💡 关键直觉:社交图分析的全部输出都是"把结构翻译成排名"——度、介数、模块度,各是一种翻译官。读懂一份分析报告,先问它的翻译官是谁、漏译了什么。
社交战场检阅完毕。下一场转入地理与网络基础设施:导航系统与互联网路由里,最短路算法如何在亿级战场上落地。