2.1 ER随机图:掷硬币掷出来的网络
2.1 ER随机图:掷硬币掷出来的网络
摘要:ER 随机图由两位数学家提出,是最早的随机网络模型:节点对之间以独立概率连边(或等价地固定边数随机放置)。它度分布近泊松、聚类系数约等于连接概率、平均路径随规模对数增长,并在平均度跨过临界点时涌现巨连通分量。本节按「标本来历—形态特征—生成机制—实验观察—野外行为」五段展开,全程用 networkx 复现关键现象。
标本来历:一道「反常识」的数学题
上世纪中叶的布达佩斯,一位以「把数学活成生活方式」闻名的数学家与同事合作,提出了一个在当时看来近乎玩笑的问题:假如网络里的连接不是设计出来的、也不是演化出来的,而是纯粹随机配对的结果,这张图会长成什么样?这就是随机图理论的起点。此前的图论研究单张具体的图,而随机图研究的是「一个随机系综里所有图的平均性质」——这步跨越把概率论工具整体搬进了图论,也为后来的统计物理派网络科学埋好了地基。
这件标本在馆内的地位由用途决定:它是零假设的化身。任何真实网络拿来做形态鉴定,第一件事就是和同规模的随机图并排比对——差异不是噪声,差异是发现。
生成机制:两种等价的掷法
ER 模型有两种常见写法,outcome 高度一致。固定边数的口径:先摆好全部节点,再从所有可能的节点对里随机抽出指定条数的边。固定概率的口径:遍历每一对节点,独立地以概率连边——就像给每对节点掷一次硬币。前者边数精确可控,后者推导方便:每个节点面对着其余每个节点,各以概率相连,它的度因此服从二项分布;网络一大而平均度有限时,二项分布收敛到泊松分布,均值即平均度。两种口径在边数取期望值时统计性质彼此逼近,实务里随意选用,推导时偏爱后者。
形态特征:泊松侧脸与三条读数
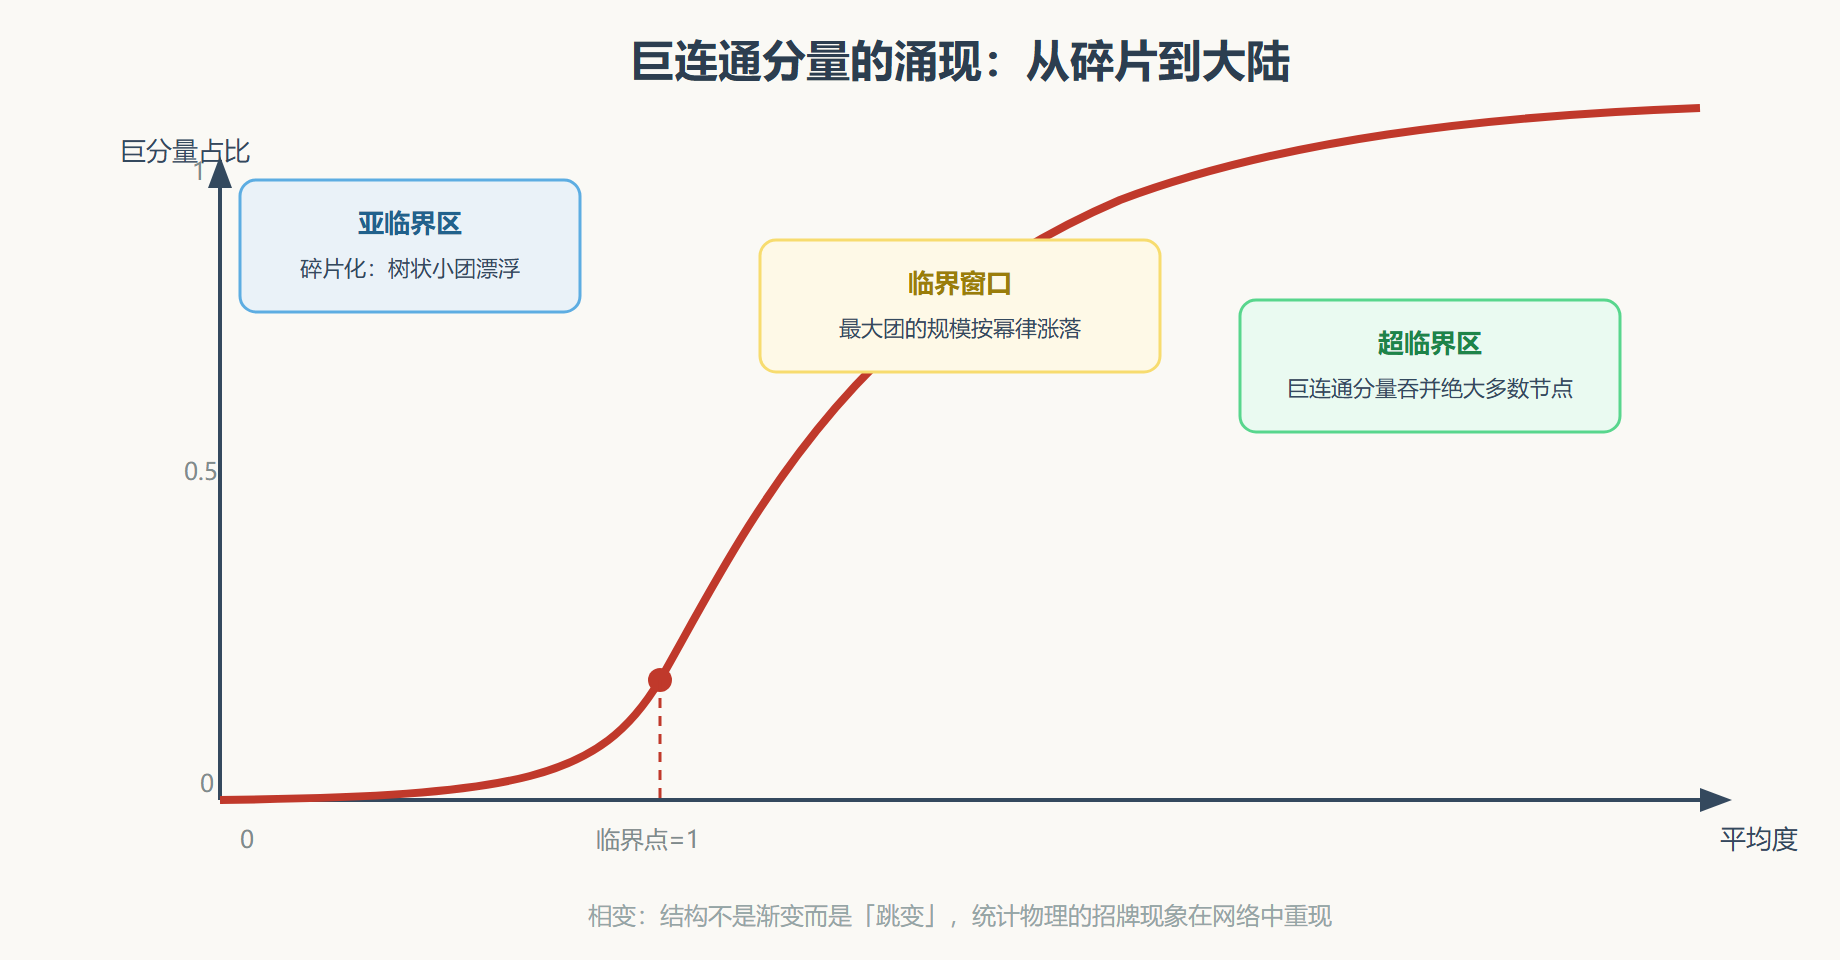
随机图的体检报告可以闭卷写出。度分布为泊松:绝大多数节点挤在平均度附近,比平均值高很多的节点按指数级稀少——侧脸照上没有枢纽。聚类系数约等于连接概率:你的两位邻居互相认识的概率,与随便两位陌生人相识的概率相同,随机图里没有「朋友圈效应」。平均路径长度以规模的对数增长:节点数翻番再翻番,平均距离只缓慢爬升,随机图天然就是小世界——短路径不是真实网络的专利,这一点常被初学者弄错。相变:平均度低于临界水平时,网络碎成无数小团;一旦跨过,一个吞下几乎全部节点的巨连通分量骤然登场。
图 ER随机图的相变曲线
实验观察:亲手复现两条结论
光看结论不算拥有,把标本放进培养皿亲手量一遍。第一个实验培育随机图并核对泊松侧脸与低聚类:
import networkx as nx from collections import Counter import math n, avg_k = 5000, 4 p = avg_k / (n - 1) # 由期望平均度反推连接概率 G = nx.gnp_random_graph(n, p, seed=42) degs = [d for _, d in G.degree()] mean = sum(degs) / len(degs) var = sum((d - mean) ** 2 for d in degs) / len(degs) print(f"平均度实测 {mean:.2f}(期望 {avg_k}),方差 {var:.2f}") print(f"最大度 {max(degs)}(泊松预测的极端值远小于此处的真实肥尾阈值)") print(f"聚类系数 {nx.average_clustering(G):.4f}(理论约等于 p={p:.5f})") print("度分布顶部:", dict(sorted(Counter(degs).items())[:6]))
实测读数与理论严丝合缝:方差约等于均值(泊松的身份证)、聚类系数落到连接概率的量级、度分布的峰就压在平均度上。换到真实社交网络上跑同一段代码,「方差远大于均值」立刻报警——那正是第 3 章肥尾形态的信号。
第二个实验复现相变:固定规模,扫描平均度,追踪最大连通分量的占比。
import networkx as nx n = 2000 print("平均度 -> 最大连通分量占比") for avg_k in [0.2, 0.5, 0.9, 1.0, 1.1, 1.5, 2.0, 3.0]: G = nx.gnp_random_graph(n, avg_k / (n - 1), seed=7) comps = sorted(nx.connected_components(G), key=len, reverse=True) frac = len(comps[0]) / n print(f"{avg_k:>5.1f} -> {frac:.3f}")
读数会显示:平均度在临界水平之下时最大团只占零头;跨过临界点后占比迅速爬升;平均度到中等水平时巨分量已吞下几乎整个网络。想看得更「跳变」,可以把规模逐步加大再扫描——曲线在临界点附近越来越陡,这正是相变的定义性特征。
相变窗口附近还有一段值得驻足的风景。临界点上,最大团块的规模呈无典型尺度的剧烈涨落——同一参数反复培育,最大团忽大忽小;恰好跨过临界点时,巨分量与大量小碎片并存,巨分量的边缘呈树状分叉而非稠密团块。这些细节在渗流理论(第 5 章)里有整章的戏份,此处先记一句:临界点不是干净的开关,而是一整片涨落异常剧烈的地带——工程系统若恰好运行在临界区附近,观测读数会天然抖动,这不是测量误差,是相变地带的地貌。此外,临界点两侧的分支结构也有判读价值:亚临界区的小团几乎全是树(边数恰为点数减一),超临界区的巨分量内部才开始出现环——「树与环的分界」给连通性读数多加了一层结构判据,后续零模型检验(第 5 章)会用同一套语汇。
野外行为:作为尺子活在所有后续章节
ER 随机图本尊在野外并不存在——没有哪个真实系统靠掷硬币连边。但作为尺子它无处不在:小世界鉴定要和随机对照比聚类(第 3 章);幂律鉴定要和泊松侧脸比尾巴(第 3 章);零模型假设检验直接就是「配置随机化」(第 5 章);传播阈值的理论基线也画在随机图上(第 6 章)。甚至它的相变也后继有人:渗流理论(第 5 章)、级联失效(第 6 章)里那些「临界点两侧天壤之别」的现象,都是随机图相变的直系后代。
💡 关键直觉:随机图的三个「缺点」——没有枢纽、没有朋友圈、不会演化——恰恰是它当对照组的资格证。尺子必须简单,刻度才可信。
本节登记完第一件理论标本,下一节培育第二件:在规则格子上开一道随机口子,看看「一点点无序」能买到多大的结构红利。