4.1 BA模型:增长与优先连接
4.1 BA模型:增长与优先连接
摘要:BA 模型用两条机制解释无标度形态的来源——增长(网络持续加入新节点)与优先连接(新节点偏向连接高度节点,概率与度成正比)。两机制共同产出度指数为三的幂律与「先来者优势」。本节按五段展开:来历(机制猜想的由来)、特征、算法实现、对照实验、边界与变体,是全册机制分析的起点。
标本来历:两条可疑线索合龙
解剖室的第一件事是案情还原。野外考察登记的肥尾形态摆在台上,问:随机图为什么长不出来?拆开随机图的两条隐含假设,各自都可疑。假设一说节点是「一次性到齐」再配对——可疑,因为真实网络是逐日生长的:网页一个个上线、论文一篇篇发表、新用户持续注册。假设二说配对机会均等——也可疑,因为新上线的网页更可能链接到早已声名显赫的站点,新作者更可能引用奠基性论文:连接的概率天然偏向「已有声望」的节点。
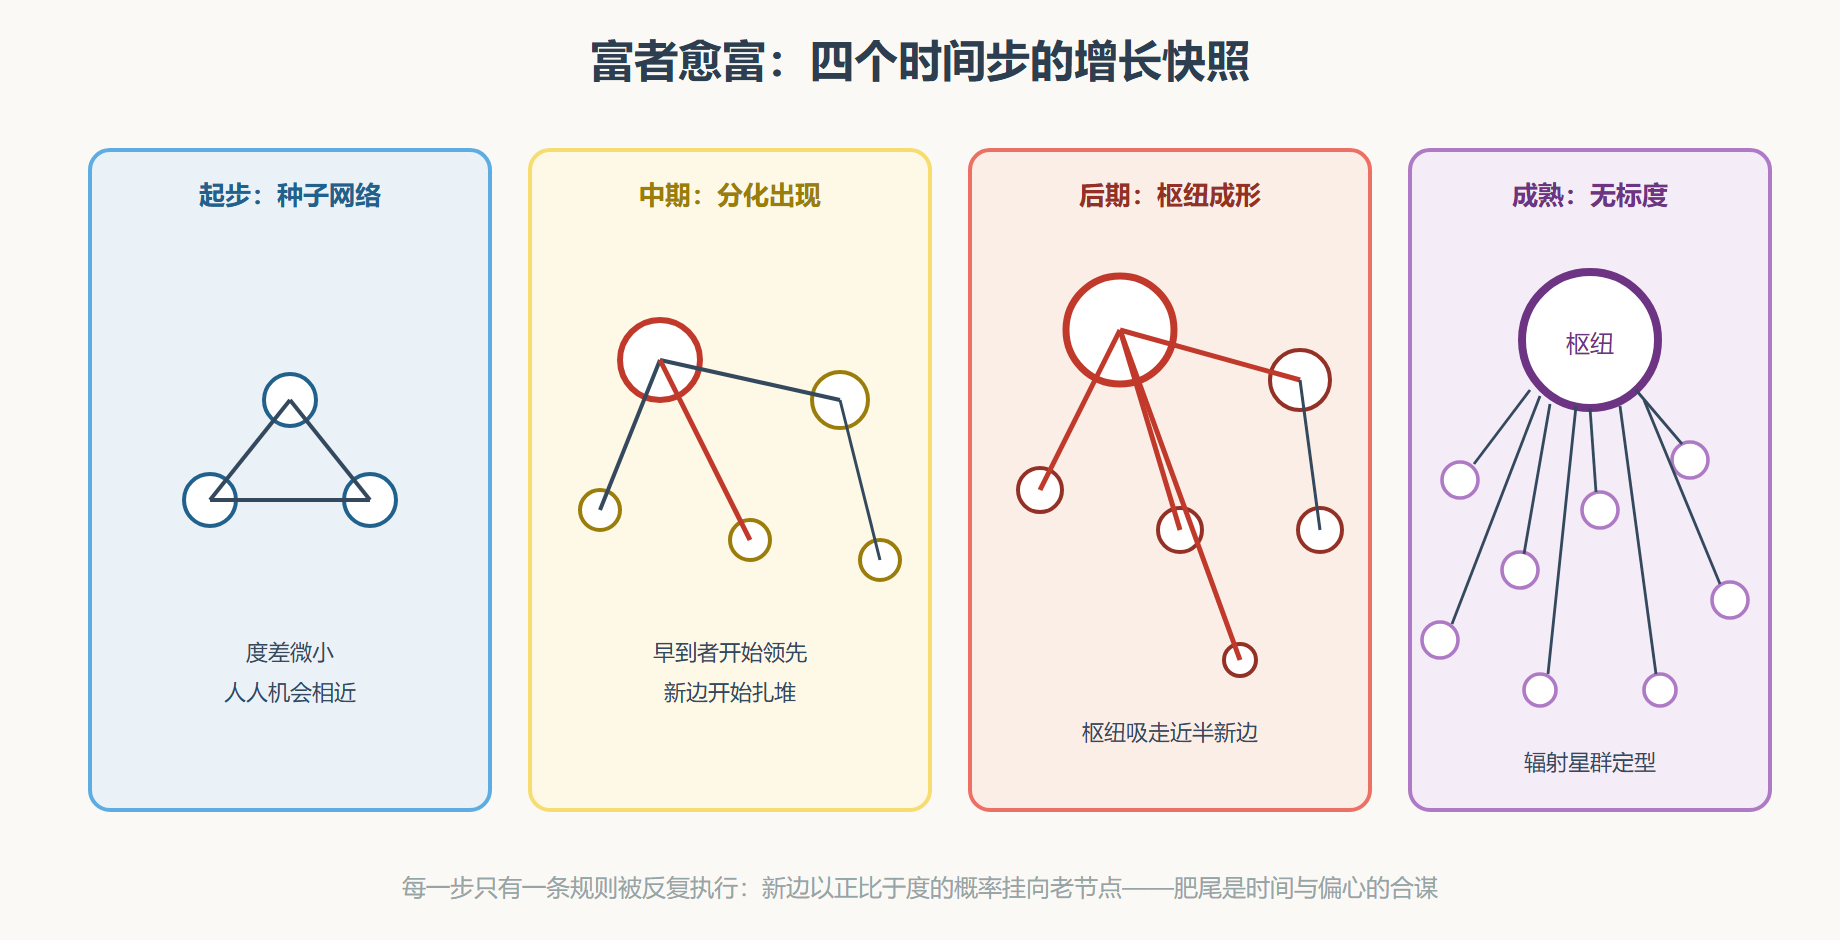
把两条线索各换一刀:让网络持续增长,让连接概率正比于目标节点的度——这就是无标度网络的生成机制,以其提出者之名常称 BA 模型。机制的语言极其朴素:增长 + 优先连接,后者还有个广为流传的别名「富者愈富」。新节点像新雪,落在哪里不均等——已经很高的雪堆截住更多飘雪,长得更高;来得早的雪堆享受了更长的积累期,优势按时间复利。
算法与特征:两步手术的精确口径
算法只有两步。初始化一个小种子网络;此后每个时间步加入一个新节点,携带着固定条数的边,逐条「挂」到既有节点上——每条边选择目标时,选中某节点的概率等于该节点当前度与全网总度之比。无自环、无重边的实现细节,实务里用「度列表展开 + 拒绝采样」处理。模型的可调参数极少:新节点带边数,加上种子网络的规模——参数这么少还能长出肥尾,正是机制强解释力的体现。
先登记形态特征(下一节给推导):度分布为幂律、指数精确等于三;平均路径比对数律还要短,属「超小世界」;聚类偏低——这是模型的著名短板,稍后算账。
import networkx as nx import math BA = nx.barabasi_albert_graph(5000, 3, seed=10) degs = [d for _, d in BA.degree()] mean = sum(degs) / len(degs) var = sum((d - mean) ** 2 for d in degs) / len(degs) print(f"平均度 {mean:.2f}(参数决定的理论值约 6=2m)") print(f"方差/均值比 {var/mean:.1f}(远大于1 => 脱离泊松世界)") print(f"最大度 {max(degs)} | 最小度 {min(degs)}(新节点至少带 m 条边)") L = nx.average_shortest_path_length(BA) print(f"平均路径 {L:.2f} | 对数律参考 {math.log(5000) / math.log(mean):.2f}")
读数里「最小度等于参数」暴露了模型的一个雕塑痕迹:BA 网络里没有「一条边都没混到」的孤立者,而真实网络里低到尘埃的节点一抓一把——形态吻合到尾部就露馅,登记在案,变体一节回收。
实验观察一:先来者优势
机制预言了一个时间维的结构性不公:越早入场的节点,度优势越大。这不是玄学,是复利的数学——早到者多享受了每一时间步的优先连接红利。验证方式直白:按入场顺序给节点编号(实现里编号即入场时间),看度的分箱均值。
import networkx as nx BA = nx.barabasi_albert_graph(4000, 3, seed=10) deg = dict(BA.degree()) groups = {"最早的一批(编号前百分之五)": range(0, 200), "中场(编号中段)": range(1800, 2200), "末班车(编号末段)": range(3800, 4000)} for label, rng in groups.items(): avg = sum(deg[i] for i in rng) / len(list(rng)) print(f"{label}: 平均度 {avg:6.1f}")
读数差距悬殊:最早一批的平均度是末班车的好多倍。这条「先来者优势」在真实系统里同样成立——早年注册的账号、奠基论文、老牌枢纽站点享有结构性红利。下一节的推导会把这条经验律写成定理:节点度按入场时间的平方根比例生长。
图 BA模型的增长四快照
实验观察二:缺一刀的对照
机制的裁决实验是「缺一刀」:单独移除任一机制,看幂律是否消失。移除优先连接(新边随机挂)——网络仍增长,但度分布退回泊松型;移除增长(固定规模内按度偏好重连)——网络不再有入场时间差,富者愈富失去时间维,分布同样不再拖幂律尾。两刀缺一不可:增长提供时间纵深,优先连接提供偏心,肥尾是两者的合谋。这组对照实验在家即可复现——把 networkx 的 BA 生成换成「先随机生成再逐步随机加边」的杂合口径,尾巴立刻收拢。
边界与变体:模型的四条账
BA 模型是机制骨架,不是真实网络的等身像,四条局限必须记账。其一,聚类过低:纯优先连接不产三角形,而真实网络高聚类——补丁是引入三角形成步骤的霍尔姆—金模型(新边有一定概率复制邻居关系)。其二,带边数固定:真实节点入场时的「活动量」差异巨大——可引入活动度驱动的变体。其三,全局信息假设:新节点要知道所有人的度才能按比例选择,真实系统里连局部信息都未必齐——局域世界模型把信息半径缩到邻域。其四,适应度缺席:纯 BA 里晚到者永无翻身日,可真实世界有「后发爆红」——适应度模型给节点发放内在吸引力参数,允许后来者逆袭,甚至出现「凝聚相变」(一个超级节点吸走几乎全部后续连接),与玻色—爱因斯坦凝聚的神似让它得了个别名。
💡 关键直觉:BA 的价值不在「真实网络都按它长」,而在「增长与偏好连接这对最小机制足以量产肥尾」。真实系统是在这对机制上叠加各种修正——变体家族的每个补丁,对应野外考察登记的一条形态偏差。
本站收束
- BA 模型 = 增长 + 优先连接(连接概率正比于度),参数极少而解释力极强
- 特征签名:度指数三、超小世界、先来者优势、低聚类(短板)
- 「缺一刀」对照是机制确证的标准操作:任一机制缺席,幂律消失
- 四条局限各对应一个变体方向:三角形成、活动度、局域信息、适应度
- 形态来自机制的结论已立,定量版——指数为什么恰是三——交给下一节的速率方程
解剖刀已证明锋利,下一节把它磨到能切开指数:速率方程将把「富者愈富」翻译成一条精确的幂律,连指数值都算给你看。