7.2 非平稳的教室:多智能体强化学习
7.2 非平稳的教室:多智能体强化学习
摘要:多个学习者共处一室,每个镇民的环境里都装着"正在学习的别人",转移规律天天变——单智能体学习的收敛前提被连根拔掉。本节讲马尔可夫博弈的形式框架、独立 Q 学习的钝感与侥幸、集中训练分散执行(CTDE)的工程主流、信用分配难题与差分奖励、竞争场景的自博弈;并用代码复现双人博弈里的追逐振荡。
把两个刚学会 Q 学习的镇民放进同一间教室,麻烦立刻开始:甲把乙当环境,乙也把甲当环境,可"环境"自己每天在变。上一节的收敛定理要求转移规律固定,教室里唯一固定的就是"一切都在变"。本节是学堂的主课,也顺带收编旧教程"协作学习与竞争学习"一讲的内容——合作的信用怎么算、对抗的对手怎么陪练,都在非平稳这个大前提下展开。
形式框架:从 MDP 到马尔可夫博弈
单智能体的 MDP 把"动作"升级成"联合动作"就成了马尔可夫博弈:状态转移与奖励取决于所有镇民同时选的动作;纯合作场景大家共享一个奖励函数,纯竞争场景奖励互为镜像(零和),中间地带各拿各的。第 6 章的静态博弈是它的"无状态特例"——状态只有一个、走一步就结束。于是均衡概念原样搬进来:多智能体强化学习的理论目标,常被表述为"学习动力学收敛到(某种精炼的)均衡"——这也是本章与会馆的正式接口:上一章说过,某些学习算法与复制者动态在数学上同构,学来学去,终点仍是均衡。
独立 Q 学习:天真者的钝感力
最省事的多智能体方案是装傻:每个镇民原封不动跑单智能体 Q 学习,把其他镇民的行为统统当作环境噪声——这就是独立 Q 学习(IQL)。它的工程美德是可扩展、零通信、天生并行;它的理论罪名是没有收敛保证:你学我、我学你,Q 值互相追逐,可能永远不落定。有趣的是实践常常宽恕天真:环境里镇民一多,单个对手的变动被平均成近似平稳的背景噪声,IQL 反而能学出像样的策略——"钝感"在嘈杂的教室里是美德。但要精细配合(外科手术式协作)时它就露馅了。
代码实验一:双人追逐的振荡
用一个最小例子看清非平稳的危害。猜硬币博弈:甲乙同时出正反面,甲想凑成相同、乙想凑成相反。两个 epsilon 贪婪的 Q 学习者对打,追踪双方策略的演化。
import random def q_learn_duel(episodes=6000, alpha=0.1, gamma=0.95, eps=0.1, seed=3): random.seed(seed) Q1 = {"正": 0.0, "反": 0.0} # 甲的 Q 表(简化:无状态版) Q2 = {"正": 0.0, "反": 0.0} # 乙的 Q 表 stats = [] for t in range(episodes): a1 = random.choice(list(Q1)) if random.random() < eps \ else max(Q1, key=Q1.get) a2 = random.choice(list(Q2)) if random.random() < eps \ else max(Q2, key=Q2.get) # 甲想相同(相同得一分),乙想相反(相反得一分) r1 = 1.0 if a1 == a2 else -1.0 r2 = -r1 Q1[a1] += alpha * (r1 + gamma * max(Q1.values()) - Q1[a1]) Q2[a2] += alpha * (r2 + gamma * max(Q2.values()) - Q2[a2]) if t % 1000 == 0 or t == episodes - 1: p1 = "正" if Q1["正"] >= Q1["反"] else "反" p2 = "正" if Q2["正"] >= Q2["反"] else "反" stats.append((t, p1, p2)) return stats for row in q_learn_duel(): print(f"第{row[0]:5d} 回合: 甲惯出{row[1]} 乙惯出{row[2]}")
观察输出:双方的主策略会轮流翻转——甲锁定"正",乙学会出"反",甲又改学"正不对、换反",乙再跟上……两条 Q 表互相追逐,永不落定(理论均衡是各半随机的混合策略,贪婪学习者只能围着它转圈)。这就是非平稳的显微镜图像:每个人都在解一个"昨天的问题",而问题已被对方的学习改写。
CTDE:训练时看全局,上场只看本地
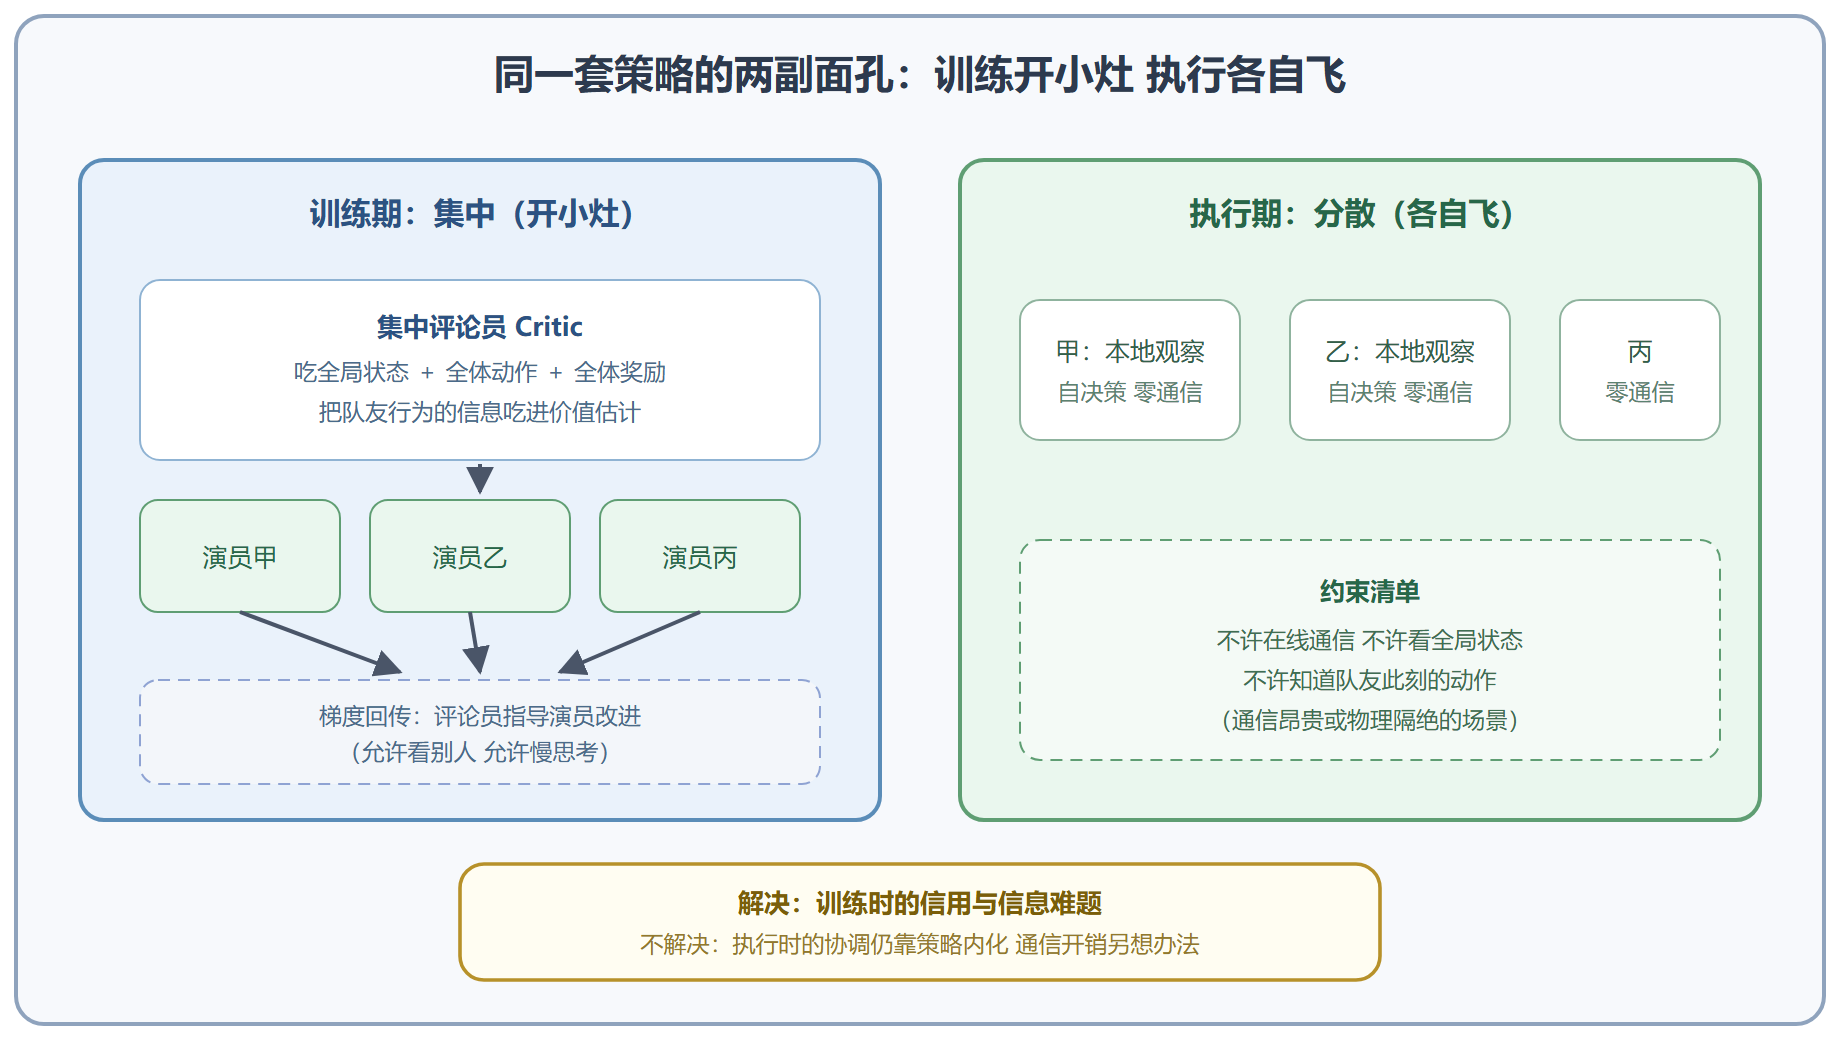
要精细配合又不违背"分散自治"的底线,工程主流是集中训练、分散执行(Centralized Training with Decentralized Execution)。训练期开小灶:评论员(critic)拿得到全局状态与所有人的动作,把"队友会怎么动"的信息吃进价值估计;执行期各上各的场:每个镇民的演员(actor)只用自己的本地观察决策,不依赖任何全局信息或在线通信。MADDPG 是这族的代表:每个镇民配一个"懂所有人"的集中评论员与一个"只懂自己"的分散演员。价值分解路线(QMIX 一族)是另一种实现:把团队总价值拆成各镇民价值的混合,保证"各自贪心=团队最优"。
图 7-1 CTDE:训练期与执行期的两副面孔
信用分配:团队赢了,功劳记谁头上
合作场景的奖励常常只有一份团队总分——捕到猎物全队吃肉,谁的那一步最关键?信用分配难题:共享奖励让每个镇民都看不清自己的行为与总分的因果关系,学出来的策略互相拖后腿(另一个极端是"懒惰镇民":躺平等队友 Carry)。经典缓解手段是差分奖励:某镇民的信用取"团队总分"减去"假如换成默认动作后的团队总分"——多出来的部分才是你的贡献。它要求能反事实地重演"没有你会怎样",仿真环境里可行(第 8 章工坊的仿真闭环正好供料),真实系统里只能近似。
代码实验二:差分奖励对共享奖励
玩具生产线:镇民甲的开关决定基础产出(不按得一分、按得五分),队友乙的行为每轮随机给总分加上正负二十的大波动。甲分别用共享奖励(直接吃团队总分)与差分奖励(总分减去"假如我没按"的总分)学习,看谁的信号干净。
import random BASE = {0: 1, 1: 5} # 我的动作对产出的基础贡献 OFFSET = 20 # 队友行为带来的大起大落(正负随机) def team_output(a1, noise): return BASE[a1] + noise def train(mode, episodes=4000, alpha=0.2, eps=0.15, seed=9): random.seed(seed) Q = [0.0, 0.0] flips, last_best = 0, None for _ in range(episodes): a1 = random.randint(0, 1) if random.random() < eps \ else Q.index(max(Q)) noise = random.choice([-OFFSET, OFFSET]) # 队友的随机行为 total = team_output(a1, noise) if mode == "shared": r = total # 平分总分(含队友噪声) else: r = total - team_output(0, noise) # 差分:扣掉默认动作的产出 Q[a1] += alpha * (r + 0.9 * max(Q) - Q[a1]) best = Q.index(max(Q)) if last_best is not None and best != last_best: flips += 1 last_best = best return best, flips for mode in ("shared", "diff"): results = [train(mode, seed=s) for s in range(5)] finals = [r[0] for r in results] flip_avg = sum(r[1] for r in results) / len(results) print(f"{mode:6s}: 各种子终局 {finals} 平均策略翻转 {flip_avg:.1f} 次")
对比结果一目了然:两种方式最终都能摸到正确开关,但共享奖励下的策略在训练全程翻转了数百次——队友的噪声把 Q 值搅得反复横跳;差分奖励几乎零翻转——反事实扣减把队友的贡献从我的成绩单里划掉了,剩下的才是"我"的信号。信用分配的本质,就是把团队的成绩单改写成个人的成绩单;代价是要能重演"没有我会怎样",这笔反事实账只有在仿真环境里才算得起。
⚠️ 常见坑:以为 CTDE 解决了一切。集中评论员让训练吃到了全局信息,但学到的协调全靠策略"内化"——环境一换(队友换了、对手变了)就要重训;对手是非平稳学习者时,评估也是坑:今天的胜率不代表明天的胜率,跑分必须注明对手版本与快照日期。
💡 关键直觉:竞争场景的自博弈是"非平稳"的创造性用法——故意让对手是自己(或自己的历史版本池),在军备竞赛里互相抬升。棋类智能体的封神之路(从自我对弈里超越人类棋谱)用的正是这招:没有老师,就把自己拆成两个互相较劲的学生。
沙盘推演小结
大教室的月考成绩单贴出来了:钝感的独立学习者们在嘈杂中各自及格,开小灶的 CTDE 小组拿下了需要精细配合的团体项目,差分奖励把躺平的懒惰镇民揪了出来。学堂还剩最后一门选修课:有一种学习不需要奖励函数,也不需要对手——盯着老师的手艺看就行。