8.2 沙盘预演:建模、仿真与评估
8.2 沙盘预演:建模、仿真与评估
摘要:仿真方法论的核心不是让模型跑起来,而是让跑出来的数字可信。本节讲建模循环(问题、实体、规则、调度、指标)、两种时间调度与激活次序的门道、校核与验证的分野(建对了吗与建对东西了吗)、以及性能评估的统计纪律——多种子、对照组、置信区间。全程用谢林隔离模型示范。
经济学家谢林某天在餐巾纸上摆弄硬币:黑白两色在棋盘上随机撒开,只加一条"邻居里同色不到三成就想搬家"的温和偏好,再让不满意的硬币随机挪窝。几轮之后,棋盘上赫然浮现大片纯色聚居区——没有人想要隔离,隔离却自己长了出来。这个后来拿了诺贝尔奖的餐巾纸实验,是多智能体仿真最著名的招生广告:简单个体规则涌现复杂社会图样。工坊第二课讲怎么把这类沙盘实验做得可信——上一章学堂的算法也要在这里学会"报分数"的正确姿势,本节同时收编旧教程"性能评估与验证"一讲的全部内容。
建模循环:从问题到沙盘的五步
可信的仿真始于克制的提问。第一步界定问题:要回答什么、不要回答什么(谢林模型回答"温和偏好能否涌现隔离",不回答"某城某街区为何隔离")。第二步抽象实体:哪些进模型、哪些砍掉——智能体的属性(颜色)、行为规则(搬家条件)各是什么。第三步设计环境与调度:棋盘、邻域形状(四邻还是八邻)、时间怎么推进。第四步定指标:涌现现象怎么量化(同色邻居占比即隔离指数)。第五步校准与验证:参数从数据或文献来,输出与程式化事实对表。循环往复,每次只动一个假设。
调度与激活次序是多智能体仿真特有的暗坑:同一批智能体,"同步更新"(全体基于上一时刻状态同时决策)与"异步更新"(按序逐个决策,后者看得到前者的新位置)能走出完全不同的动力学;固定顺序的异步调度还会给排前面的智能体系统性优势。标准做法是随机洗牌:每轮打乱激活顺序,把次序偏差平均掉。此外,时间步调度(每 tick 全员动一次,直观)与离散事件调度(只在事件发生时刻推进钟,高效)适合的问题类型不同——交通流常用时间步,排队网络常用离散事件。
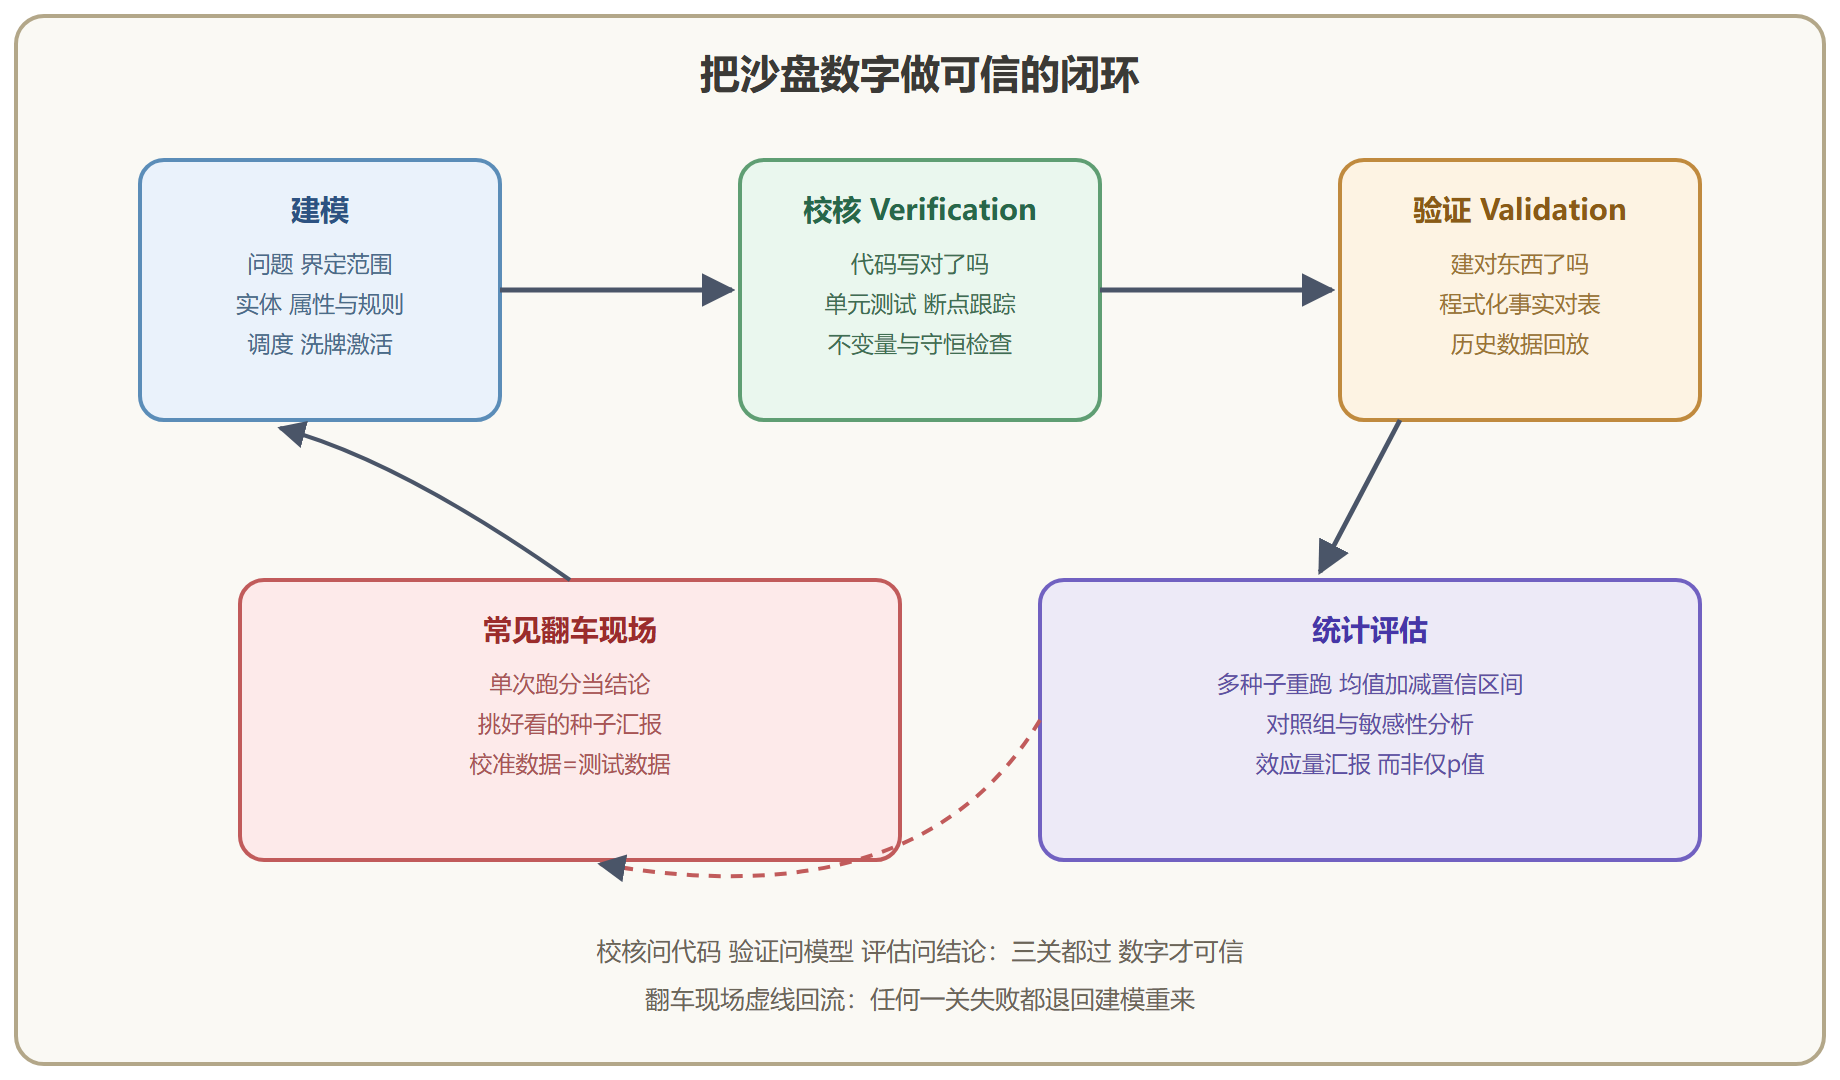
图 8-2 可信沙盘的闭环:建模、校核、验证、评估
校核与验证:两个常被混用的词
**校核(verification)**问的是"代码 faithfully 实现了模型吗":搬家规则写反没有?邻域数错没有?手段是工程老三样——单元测试(每个行为规则配对拍测试)、轨迹跟踪(打印单个智能体的完整决策史人工复查)、不变量检查(智能体总数守恒、状态空间不越界)。**验证(validation)**问的是"模型 faithfully 反映了现实吗":隔离指数的动态像不像真实城市的演化曲线?手段有程式化事实对表(现实中的若干定量规律,模型应复现)、历史数据回放(把过去的初始条件灌进去,看输出对不对得上历史)、专家面审(领域学者看动画找茬)。两问一字之差,答错对象全白干——代码零缺陷的错模型,跑得越快错得越远。
代码实验一:谢林隔离模型
把餐巾纸实验搬进代码。网格上随机撒两色住户,规则只有一条:邻居中同色占比低于容忍阈值就搬家(挪到随机空格)。指标是全体住户的"同色邻居平均占比"。
import random class SchellingTown: def __init__(self, size=20, empty_ratio=0.2, tolerance=0.3, seed=0): self.rng = random.Random(seed) self.size, self.tol = size, tolerance cells = ([1] * int(size*size*(1-empty_ratio)//2) + [2] * int(size*size*(1-empty_ratio)//2) + [0] * (size*size - 2*int(size*size*(1-empty_ratio)//2))) self.rng.shuffle(cells) self.grid = {((i//size, i % size)): cells[i] for i in range(size*size)} self.rounds = 0 def neighbors(self, pos): x, y = pos out = [] for dx in (-1, 0, 1): for dy in (-1, 0, 1): if dx == dy == 0: continue n = (x+dx, y+dy) if n in self.grid and self.grid[n] != 0: out.append(self.grid[n]) return out def unhappy(self, pos): nb = self.neighbors(pos) if not nb: return False same = sum(1 for v in nb if v == self.grid[pos]) return same / len(nb) < self.tol def step(self): """一轮:随机洗牌后逐户检查,不满意的搬去随机空格。""" self.rounds += 1 empties = [p for p, v in self.grid.items() if v == 0] movers = [p for p in self.grid if self.grid[p] != 0 and self.unhappy(p)] self.rng.shuffle(movers) # 洗牌激活 for p in movers: if not empties: break dest = empties.pop(self.rng.randrange(len(empties))) self.grid[dest], self.grid[p] = self.grid[p], 0 empties.append(p) return len(movers) def segregation(self): """同色邻居平均占比:零为彻底混居 一为完全隔离。""" ratios = [] for pos, v in self.grid.items(): if v == 0: continue nb = self.neighbors(pos) if nb: ratios.append(sum(1 for x in nb if x == v) / len(nb)) return sum(ratios) / len(ratios) town = SchellingTown(size=20, tolerance=0.3, seed=3) print(f"初始隔离指数 {town.segregation():.3f}") for _ in range(12): moved = town.step() if moved == 0: break print(f"{town.rounds} 轮后隔离指数 {town.segregation():.3f}")
看数字说话:容忍阈值三成(相当温和的偏好),隔离指数却从五成附近一路爬到八九成——个体只要求"同色别太少",群体却走成了"几乎全同色"。谢林的洞见正在这里:隔离不需要种族主义者,温和偏好加搬家的正反馈就够了。
代码实验二:把评估做诚实
单次跑分不算结论。让同一模型跨种子重复运行,再扫一列容忍阈值,用"均值加减百分之九十五置信区间"汇报。性能评估(第 7 章算法也一样)的统计纪律全在这一段代码里。
import math def run_once(tolerance, seed, steps=12, size=20): town = SchellingTown(size=size, tolerance=tolerance, seed=seed) for _ in range(steps): if town.step() == 0: break return town.segregation() def evaluate(tolerance, n_seeds=30): xs = [run_once(tolerance, seed=s) for s in range(n_seeds)] mean = sum(xs) / n_seeds var = sum((x-mean)**2 for x in xs) / (n_seeds-1) half = 1.96 * math.sqrt(var / n_seeds) # 正态近似置信区间 return mean, half print(f"{'阈值':>4} {'隔离指数(均值±CI)':>22} {'轮内搬家未停':>10}") for tol in (0.1, 0.3, 0.5, 0.7): mean, half = evaluate(tol) print(f"{tol:>4} {mean:11.3f} ± {half:.3f}")
三个看点:其一,置信区间随阈值的变化幅度——若两组的区间重叠严重,"阈值提升隔离"的结论就要谨慎;其二,区间宽度本身是信息——太宽说明方差大,要么加种子数要么承认结论不稳;其三,把 n_seeds 从三十降到一,看看单次跑分离均值能偏多远——那是你差点要汇报的那条数字。这套纪律对第 7 章的学习算法原样适用:训练曲线要跨种子汇报,对照实验要配对比较,调参的分数永远要在没参与调参的种子上复核。
⚠️ 常见坑一:种子樱桃——试跑二十个种子挑最好看的截图汇报。防御:预注册种子集合(比如零到二十九),全部汇报。坑二:校准与验证同源——用同一批历史数据既调参数又验模型,等于开卷考试;必须留出没碰过的数据做最终验证。坑三:把涌现指标当设计目标——你可以调参数让隔离指数下降,但真实世界不归你调参;仿真结论永远是"在该模型假设下",假设清单要随结论一起呈堂。
💡 关键直觉:多智能体仿真的说服力来自它背叛你直觉的方式(温和偏好涌现隔离),而不是它印证你直觉的方式。模型复现常识不算贡献,模型暴露反直觉机制才是——选研究问题时值得记住这一条。
沙盘推演小结
沙盘台的规矩立起来了:先界定问题、再洗牌调度、跑完多种子、报区间不报单点、校核验证分两关过。学徒们把第 7 章的学习算法也搬上了台,成绩单第一次有了像样的误差棒。工坊还剩最后一堵墙要砌——沙盘小镇开在真实世界里,墙外有骗子有扒手,下一章给小镇装上门禁与窗帘。