1.3 大模型不会什么:让它干活卡住的四个缺口
1.3 大模型不会什么:让它干活卡住的四个缺口
本节摘要:上节盘了家底,这节看欠账。让模型从聊天走向干活,卡点可以收敛成四个缺口:没有手(不能行动)、记不住(没有持久状态)、不会拆事(规划不稳)、不知道自己不知道(没有新事实)。每个缺口都有典型翻车现场,也都有对应的工程补法——本节负责把缺口定位准,补法分别在第 2、3、4、6 章展开。
为什么同一个模型,答科普题对答如流,接到真实任务就步步惊心?因为任务一旦离开"纯文本进出",模型就撞上了四面墙。先看一面墙长什么样。
翻车现场:一个查价格的请求
用户问:"现在这个型号的显卡多少钱?"模型滔滔不绝地给出一个具体价格,语气笃定,数字精确到百位。三个问题藏在里面:训练数据里没有今天的价格;它没有可以查询的渠道;它不觉得自己该说"我不知道"。这段回答的每个字都符合语法,整体却是编造——流利度和正确率是两个独立的指标,这是读模型输出时最重要的一条戒律。
# 缺口的直观演示:同一个问题,裸模型 vs 挂了工具的模型 question = "现在这个型号的显卡多少钱?" # 裸模型:只能靠训练记忆作答 —— 输出的价格是历史数据的残影 naked_answer = llm.complete(user=question) # 典型输出:"该型号目前售价约 4999 元。"(无出处、无时间戳、不可信) # 挂上搜索工具后,模型的回答变成两步:先声明要用工具,再基于结果作答 # 行动: search_web(query="该型号显卡 价格") # 观察: [{"title":"电商报价","snippet":"今日 4399 元起","date":"今天"}] # 回答: "今天电商起售价 4399 元(来源:电商报价页)。"
区别不在模型变聪明了,而在信息来源变了:从"记忆残影"换成了"现场取证"。把这件事推广开,就是四个缺口的完整地图。
图:四个缺口与补法对照——每堵墙对应一个工程模块
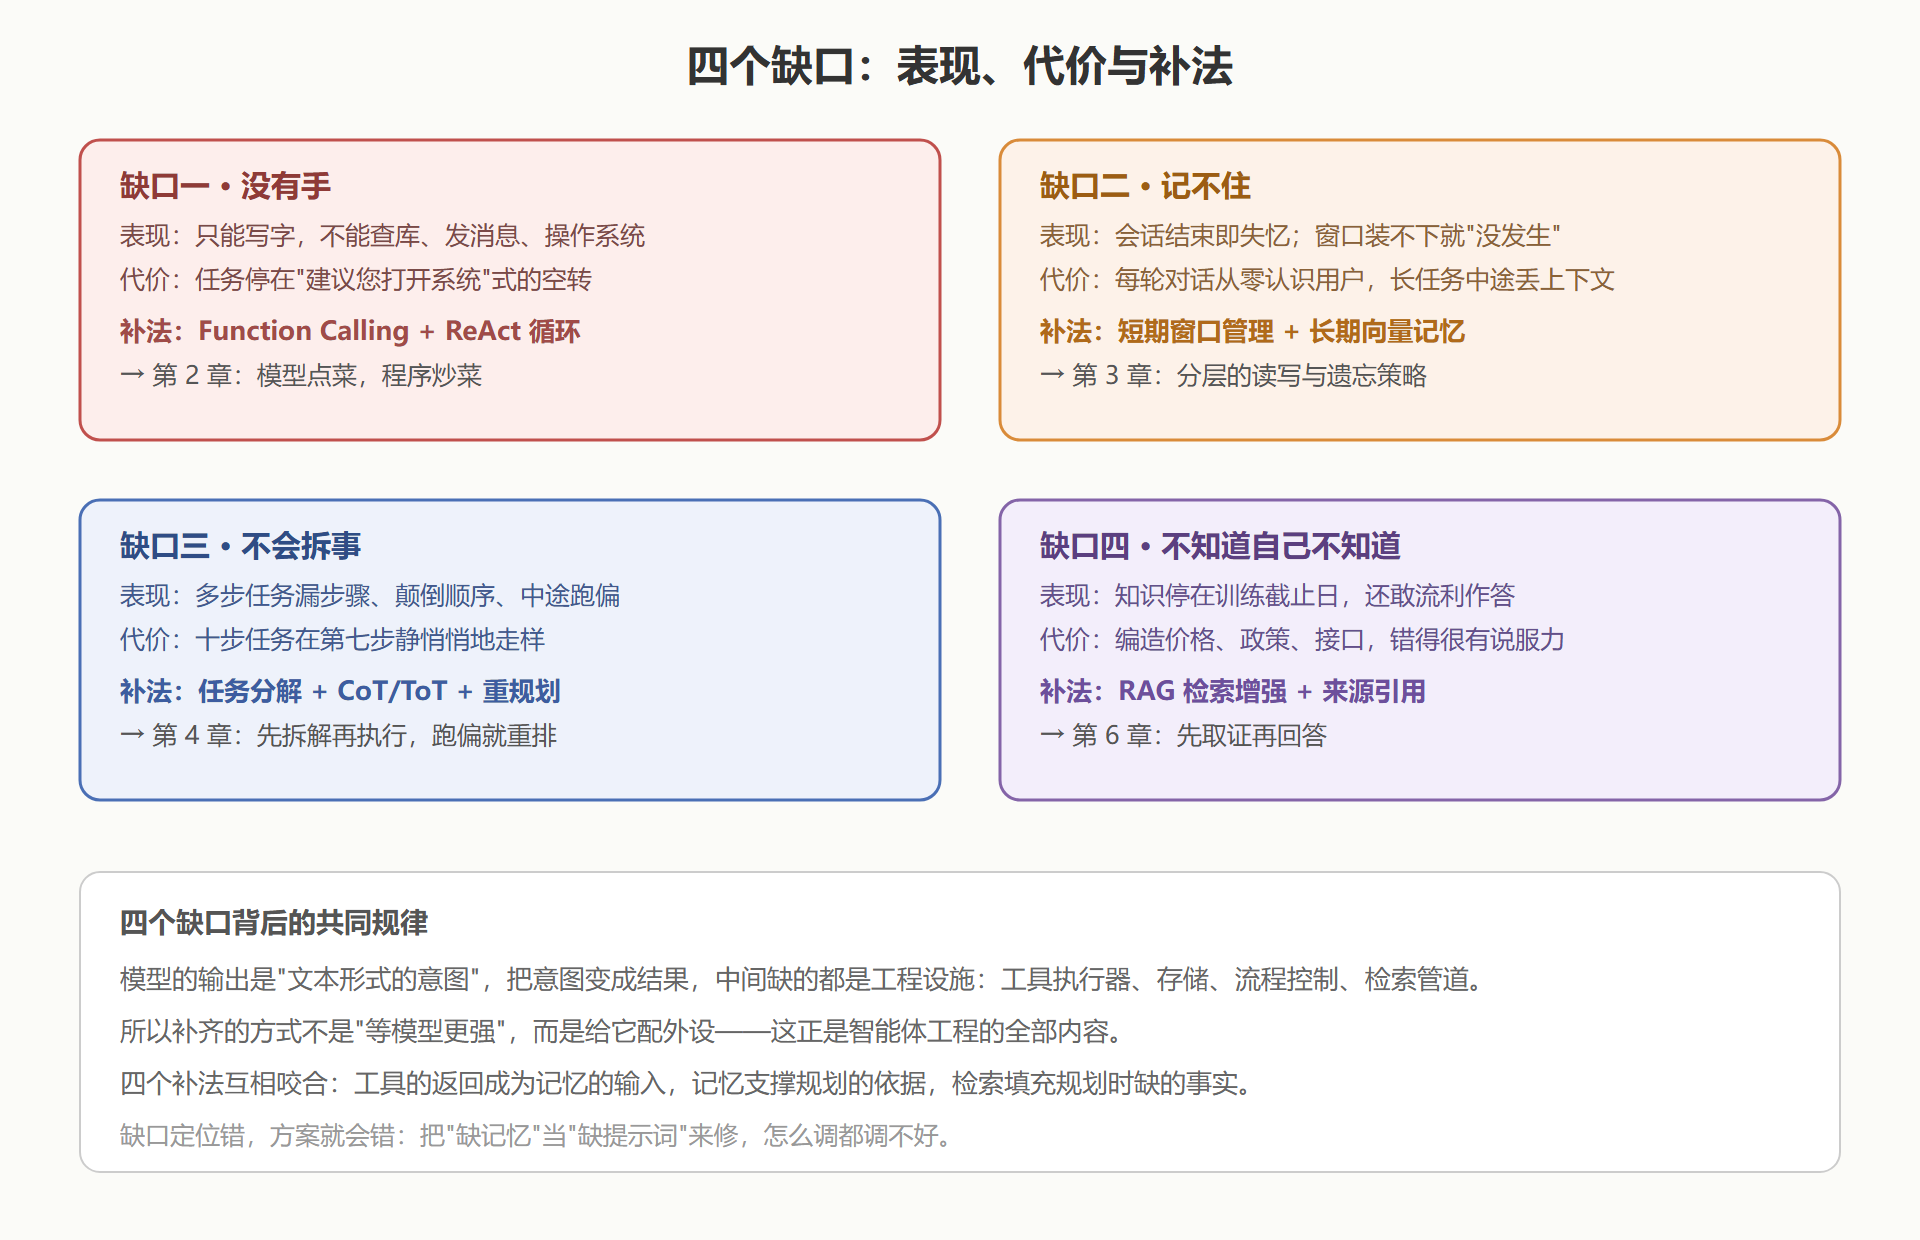
四个缺口的速查表
| 缺口 | 典型表现 | 业务代价 | 补法(章节) |
|---|---|---|---|
| 没有手 | 输出"建议您……"式说明文 | 任务零推进,用户流失 | Function Calling 与 ReAct(第 2 章) |
| 记不住 | 新会话不认识老用户;长任务丢前提 | 重复沟通、任务中断作废 | 窗口管理 + 分层记忆(第 3 章) |
| 不会拆事 | 大任务只做一半或顺序错乱 | 静默出错,返工成本高 | 分解、CoT/ToT、重规划(第 4 章) |
| 不知道自己不知道 | 编造价格、政策、接口文档 | 错误信息流进业务决策 | RAG 与来源引用(第 6 章) |
⚠️ 常见坑:把缺口归因为"提示词没写好"。判断方法很简单——如果是记忆类问题,换更好的提示词毫无改善;如果是表达类问题,改提示词立竿见影。先定位缺口,再选工具。
为什么"等下一代模型"不是答案
有一种流行的侥幸:这些缺口会在下一代模型里自然消失。逐条检验一下。行动能力依赖运行环境——模型再强,也得有你的系统给它开放接口,这是部署问题不是模型问题。持久记忆依赖存储选型——把什么都塞进超长上下文,成本和延迟都会失控,第 3 章会用数字说明。规划能力在进步,但"拆解业务特有的任务"需要的领域知识本来就不在通用模型里。事实时效性更是物理问题:训练永远有截止日。四面墙里只有一面(推理)随模型升级显著变薄,其余三面都要靠工程。
这个判断决定了本册的立场:智能体工程的价值不随模型升级而贬值,反而随模型变强而放大——大脑越好,外设的回报越高。
本节要点回顾
- 四个缺口:没有手、记不住、不会拆事、不知道自己不知道——分别对应工具调用、记忆、规划、检索四个模块。
- 流利不等于正确:编造最危险的地方恰恰是它最有说服力的地方,验真机制必须独立于模型自信度。
- 定位先于开方:提示词能修的是表达问题;行动、记忆、时效问题要换工程模块,不是换话术。
- 缺口互相咬合:工具产出观察,观察写入记忆,记忆支撑规划,检索补齐事实——全册的章节顺序就是这条咬合链。
最后一个问题留给下一节:不走智能体这条路,传统的 RPA 自动化不行吗?为什么行业宁可用更"贵"的模型方案?
缺口定位的三步排错法
实际项目里最值钱的技能,是拿到一个"智能体不行了"的模糊反馈,快速判断它撞在哪面墙上。三步排错法可以直接套用。
第一步,看它该做什么而不是它说了什么。把用户的原始诉求翻译成"理想执行序列":这件事需要查几个事实、做几个动作、跨几轮对话?翻译完对照实际轨迹,缺失的环节就是缺口所在——该查没查是缺工具或没检索,查了没用是记忆或观察出了问题,顺序错乱是规划问题。
第二步,换提示词做对照实验。给同一任务换一版更精确的提示词再跑一次:表现明显改善,说明是表达问题(提示词可治);毫无变化,说明是能力或设施问题(要换模块)。这个五分钟的实验能省掉大量南辕北辙的优化工时。
第三步,查信息有没有到场。把轨迹里每轮决策时模型实际能看到的上下文打印出来逐轮检查——大量"模型很蠢"的案例,真相是决策那一刻关键信息根本不在窗口里:要么没检索、要么被截断、要么工具没返回。信息到场问题,治法在数据链路而不是在模型。
四个缺口的自查清单
| 自查问题 | 若答案为否 | 对应缺口 |
|---|---|---|
| 任务需要的外部事实,模型有渠道拿到吗? | 它只能靠训练记忆瞎猜 | 不知道自己不知道 |
| 任务的动作有对应的工具且已注册吗? | 它只能输出"建议您……" | 没有手 |
| 跨轮次需要的信息,上一轮还在窗口里吗? | 它每轮都像初次见面 | 记不住 |
| 任务超过五步时有计划与核对机制吗? | 它走一步丢一步 | 不会拆事 |
把这张表贴在工位上并不夸张——智能体故障诊断的大部分场景,最终都收敛到这四个格子里。定位准了缺口,再翻到对应章节拿方案,比在提示词里反复试错经济得多。
一个综合案例:四个缺口同时出现的样子
真实项目里四个缺口很少单独出场。一个典型的内测反馈是:"这个数据助手不好用,问它上周的销量它瞎说,让它导出表格它说做了但系统里没有,多问两句它就忘了前面要什么。"翻译成缺口语言:瞎说销量是缺检索(第四缺口),声称导出但系统无记录是没有写入类工具或执行层缺失(第一缺口),多问就忘是窗口被历史挤掉(第二缺口),而三个问题叠在一起,用户感知就是一句"不靠谱"。逐个修才有效:先补工具与执行链(让它真的能导出并回传真凭据),再接检索(销量从库里查不靠记忆),最后上窗口管理(长对话不丢目标)。两周的定向修复,胜过一个月的"全面优化"——因为这个案例里不存在需要"全面优化"的模型,只存在四个各需一周的工程缺口。