2.2 Function Calling:工具调用的标准协议
2.2 Function Calling:工具调用的标准协议
本节摘要:Function Calling 是模型与外部世界之间那份"点菜单"的标准格式:用 JSON Schema 描述工具,模型输出结构化的调用意图,程序校验后执行,再把结果回填。本节走完一轮调用的完整时序,并给出版本落地时最容易踩的参数设计坑。
上一节把契约立在了系统提示词里,本节把契约变成机器可校验的协议。主流模型服务对这套协议的叫法略有差异(工具调用、函数调用),结构却高度一致,学会一套即通吃各家。
协议的三个角色
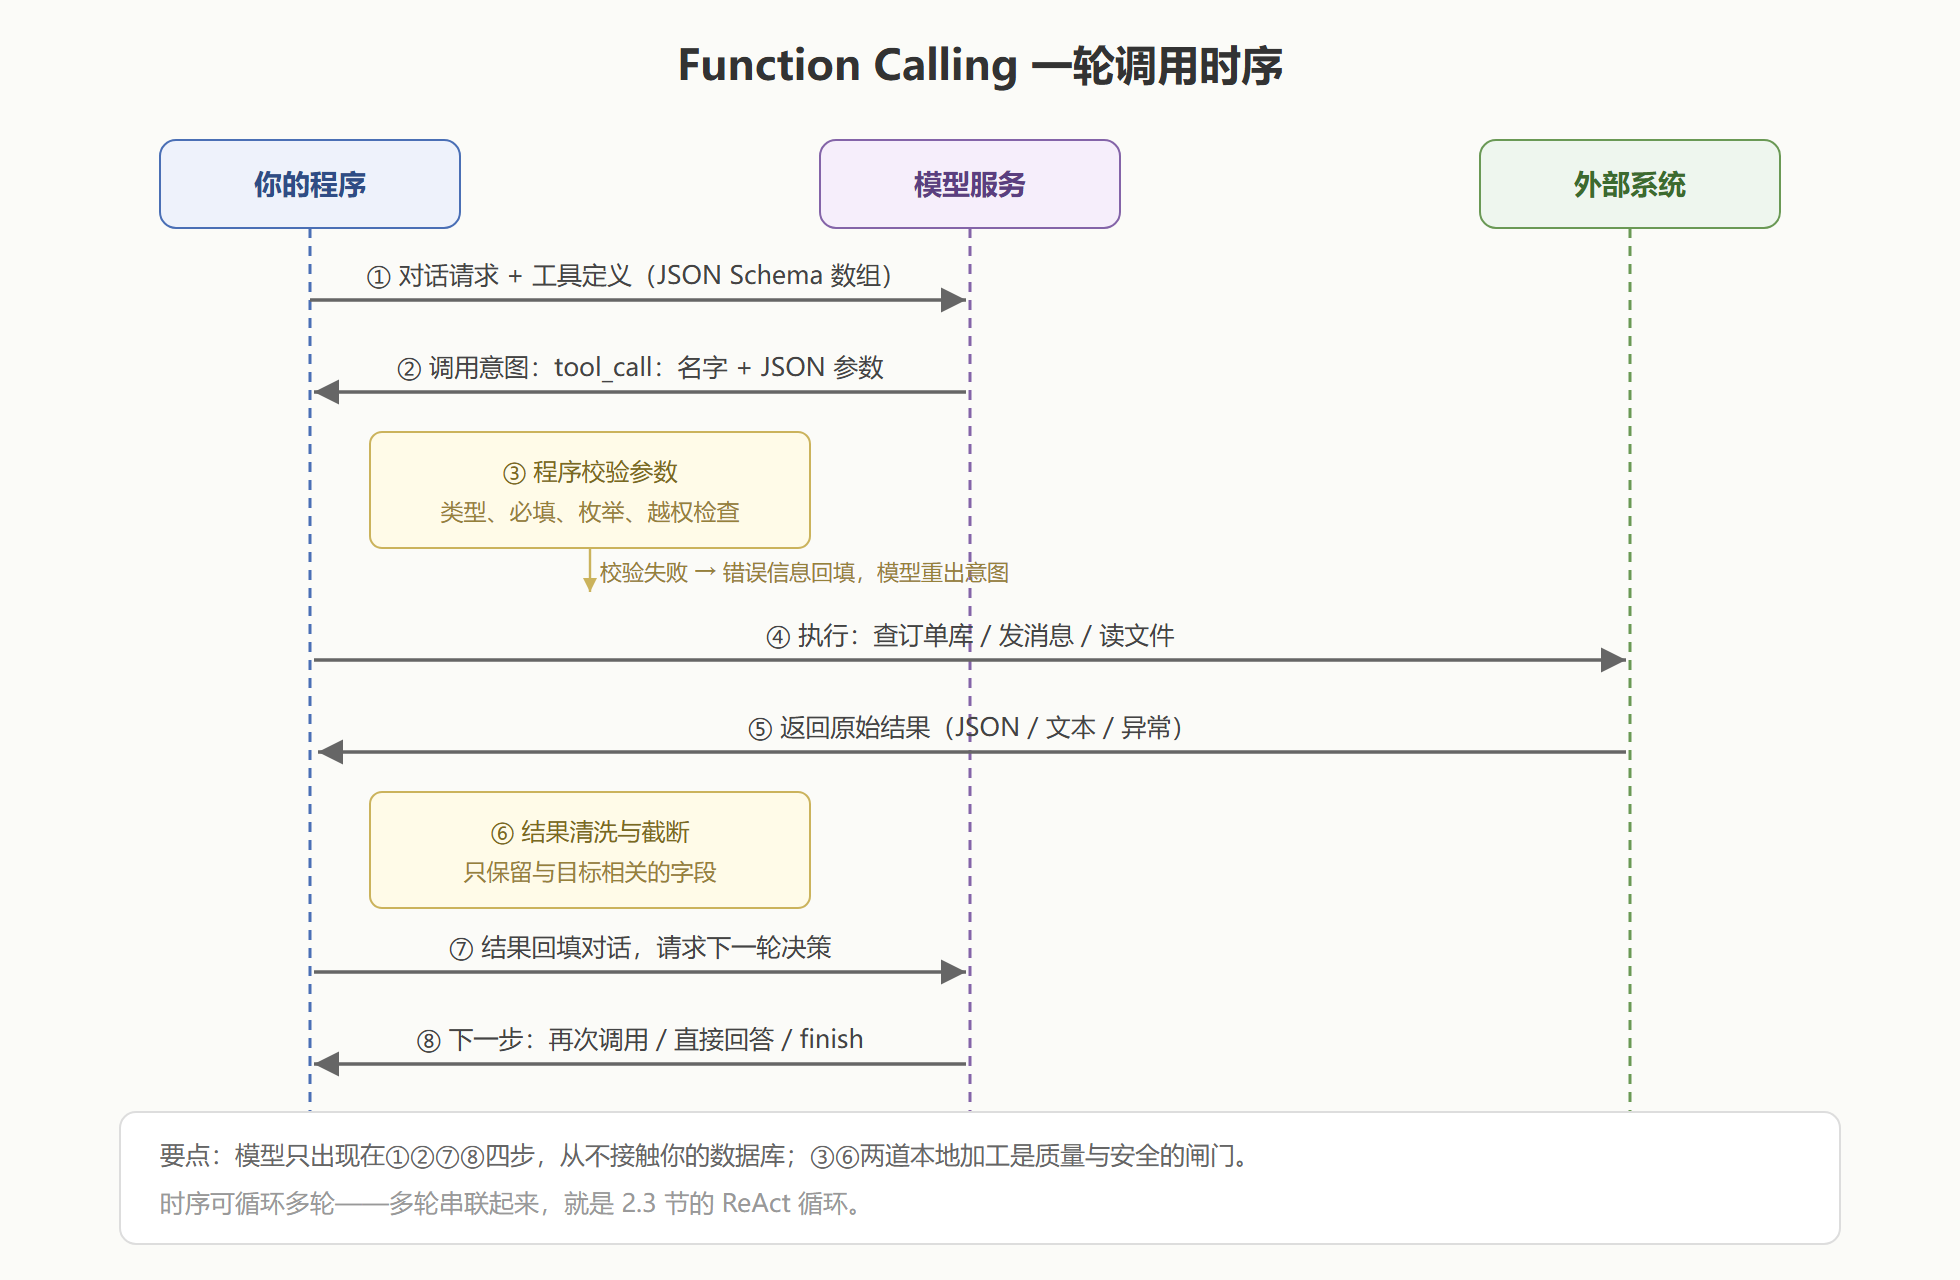
一轮工具调用涉及三份东西:工具定义(程序写给模型看的,JSON Schema 格式)、调用意图(模型回给程序的,结构化 JSON)、执行结果(程序回填给模型的,多为文本或 JSON)。模型从头到尾没有执行任何东西——它只是按 schema 的格式"报菜名",执行权始终在程序手里。理解这一点,安全模型就清晰了:模型是建议者,程序是执行者,护栏拦在两者之间。
图:一轮工具调用的完整时序——从定义到回填
工具定义:schema 怎么写才容易被选对
下面是一个生产级的工具定义,注释标出了每个字段的作用:
{ "type": "function", "function": { "name": "get_order", // 动词+名词,全局唯一,蛇形命名 "description": "按订单号查询订单状态、金额与物流信息。当用户询问订单进度或要求查单时使用。", "parameters": { "type": "object", "properties": { "order_id": { "type": "string", "description": "订单号,形如 ORD-2024-000123,用户消息中的原始编号" }, "include_logistics": { "type": "boolean", "description": "是否附带物流轨迹,默认 false", "default": false } }, "required": ["order_id"] } } }
三个字段最影响选中率。name:动词开头见名知义,get_order 比 handle_data 的选中准确率高一个量级。description:写"什么时候用",而不是重复名字——模型是拿用户的话和这句话做语义匹配的。参数 description:写清格式示例("形如 ORD-2024-000123"),能显著降低模型编造格式外的编号。
调用与回填:程序侧完整代码
tools = [get_order_schema, create_ticket_schema] # 2.1 节契约里的清单 def run_turn(messages): resp = llm.chat(messages, tools=tools) # ① 携带工具定义发问 msg = resp.message if not msg.tool_calls: # 模型决定直接回答 return msg.content for call in msg.tool_calls: # 可能有多个调用 name = call.function.name args = json.loads(call.function.arguments) try: args = validate(name, args) # ③ 参数校验 result = TOOL_IMPLS[name](**args) # ④ 真正执行 obs = slim(result, keep=name2fields[name]) # ⑥ 清洗截断 except ToolError as e: obs = {"error": str(e)} # 失败也回填,不抛给模型 messages.append(tool_msg(call.id, json.dumps(obs, ensure_ascii=False))) return run_turn(messages) # ⑦ 回填后请模型继续
validate 是整套协议里性价比最高的一段代码——模型给出的参数要当作不可信的外部输入对待:
def validate(name, args): spec = TOOL_SPECS[name] missing = set(spec["required"]) - set(args) if missing: raise ToolError(f"缺少必填参数: {missing}") for k, rule in spec["properties"].items(): if k not in args: continue if rule["type"] == "number" and not isinstance(args[k], (int, float)): raise ToolError(f"参数 {k} 应为数字,实际是 {args[k]!r}") if "enum" in rule and args[k] not in rule["enum"]: raise ToolError(f"参数 {k} 取值非法: {args[k]}") return args
案例:一次查单的完整对话流
背景:客服系统接了 get_order 工具,用户发来"我那个 ORD-2024-000123 到哪了"。
操作:程序把对话与工具定义发给模型;模型返回意图 get_order(order_id="ORD-2024-000123");程序校验通过、查库、只保留状态与物流摘要两字段回填;模型基于回填内容回答用户。
结果:回答形如"您的订单已到上海转运中心,预计明天送达"——每个事实都来自工具返回,而非模型记忆。
解读:如果省掉第⑥步清洗、把整张订单表原样回填,会发生两件坏事:窗口被无关字段挤占,模型还可能把用户的手机号、地址一并复述出来——既费钱又泄露隐私。清洗不只是性能优化,是隐私边界。
变式:用户同时问三个订单的进度时,主流协议支持一次返回多个 tool_call,程序并发执行后统一回填,轮次从六轮压到两轮。并行调用是高并发场景最划算的优化,但要确认各调用之间无先后依赖。
⚠️ 常见坑:模型偶尔会"幻觉"出不存在的工具名或编造参数值(比如单号库里根本没有)。处理方式不是恐慌——校验层拦下、错误信息回填,模型大概率会在下一轮改口。真正危险的是对执行成功与否撒谎:务必把工具异常原样回填,绝不让程序层"体贴地"编一个成功结果。
本节要点回顾
- 协议三方:工具定义(schema)、调用意图(模型输出)、执行结果(程序回填);执行权永远在程序。
- 选中率靠文案:name 见名知义、description 写使用时机、参数给格式示例——模型靠这些做语义匹配。
- 参数即外部输入:必填、类型、枚举、越权四类校验是性价比最高的安全代码。
- 回填要清洗:只留相关字段,省窗口也防隐私外泄;工具异常原样回填,模型会自我修正。
下一节把单轮调用串成多步循环——ReAct 模式的完整代码实现,包括让循环不跑飞的全部兜底。