第七章 评测与安全护栏:敢上产线的前提
第七章 · 评测与安全护栏:敢上产线的前提
本章要回答的三个问题:智能体"感觉不太行"怎么变成可度量的指标?幻觉、效率、鲁棒性这些老毛病在多步系统里怎么治?怎么设计拦截机制,让错误动作在造成损失之前被挡住或转给人工?
为什么会有这一章
前六章把能力拼齐了,但能力齐备的系统与可托付的系统之间隔着最后一公里。聊天产品的错误是"说错话",用户笑笑就过;智能体的错误是"做错事"——发错邮件、订错会议室、引用作废制度做决策,每一件都有真实代价。这个量级的风险,靠"上线前多测测"的手感远远不够,需要两套正规军:评测回答"它现在到底几斤几两、每次改动变好还是变坏";护栏回答"它即将犯错的瞬间,谁去拦、怎么拦"。
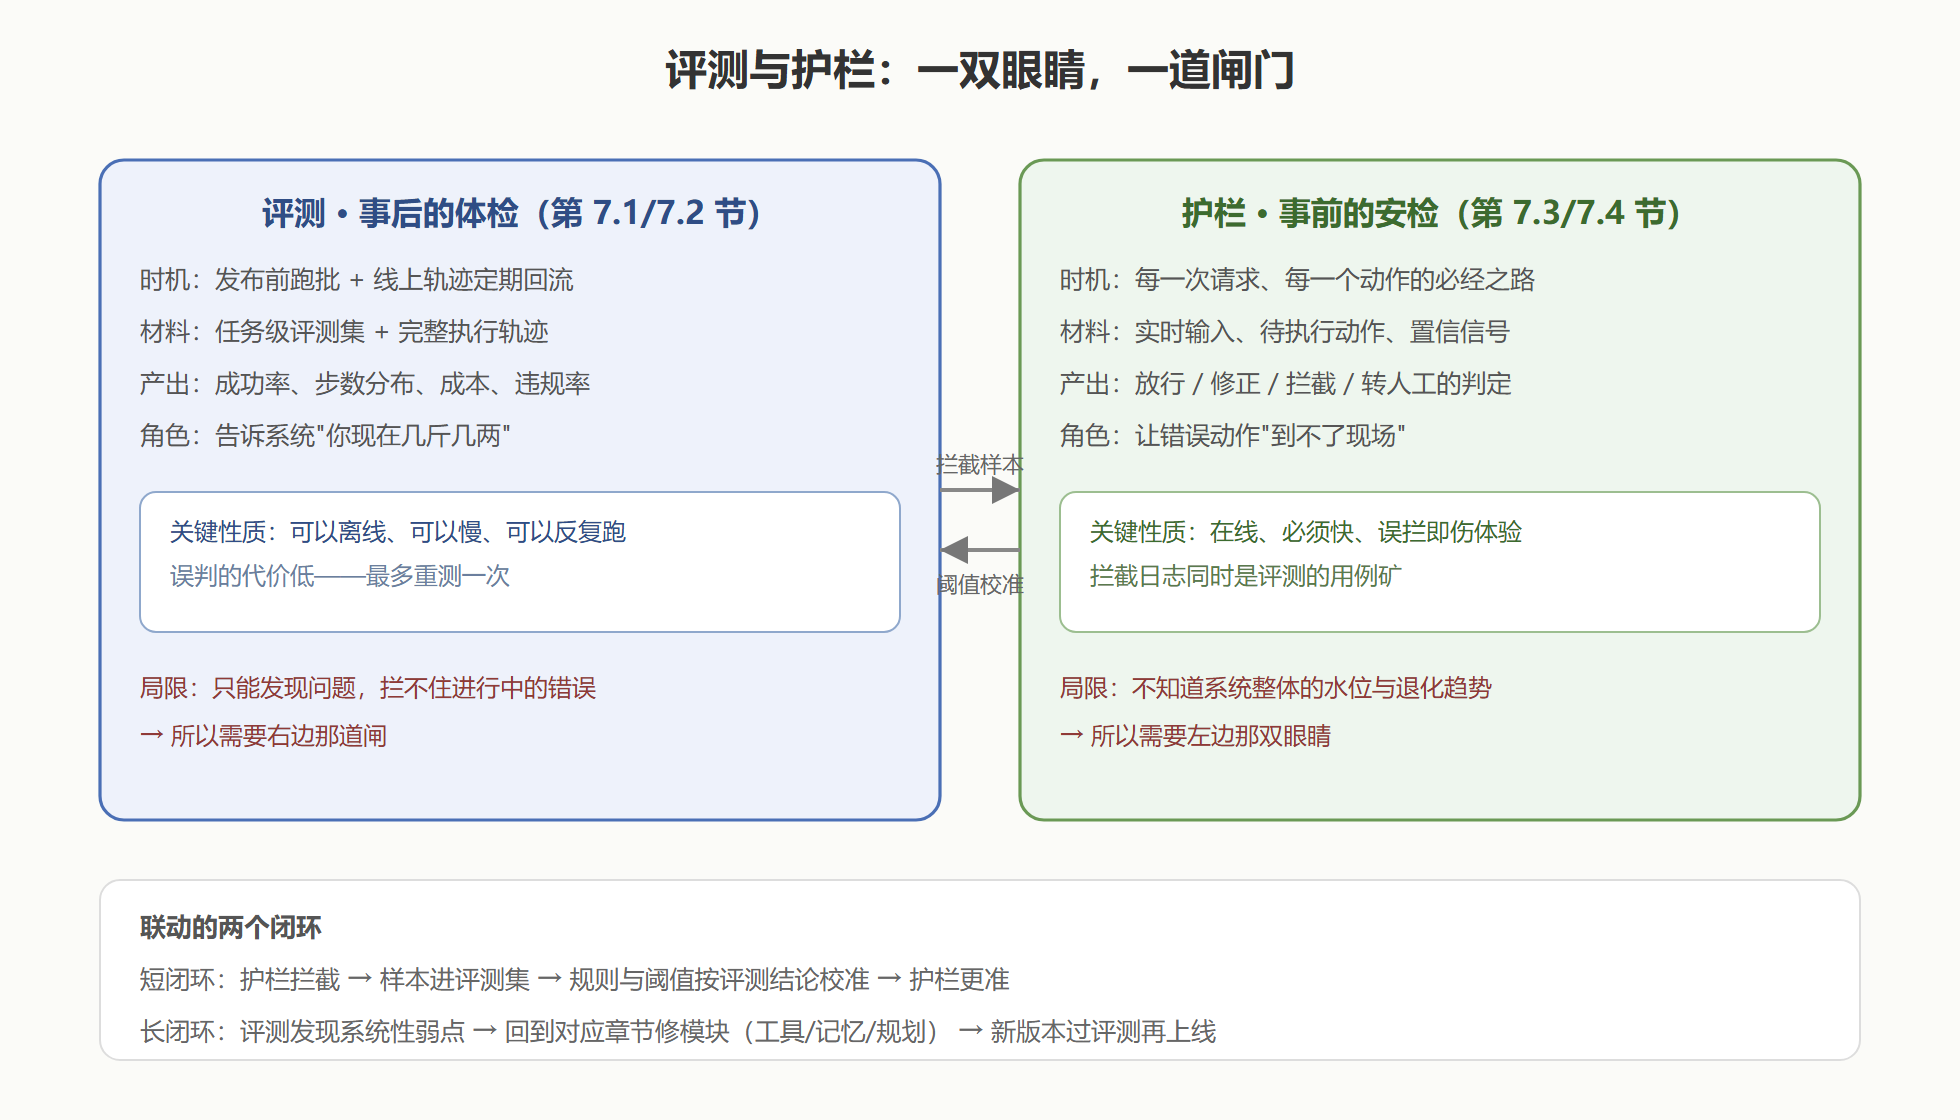
两者的关系值得先说清:评测是事后的体检(发现问题),护栏是事前的安检(拦截问题),互不可替代。没有评测的护栏是盲目的——不知道该在哪设卡;没有护栏的评测是绝望的——明知会错却无从拦截。
本章全景
图:评测与护栏的双闸联动——发现问题与拦截问题各就各位
读完能解决什么
- 能为智能体建一套任务级评测:评测集的结构、指标的定义、判分的自动化。
- 能区分"模型层问题"与"系统层问题",把幻觉、可解释性、效率、鲁棒性四大挑战落到对应的治理手段上。
- 能设计三道闸护栏:输入过滤挡注入与越权,输出校验挡格式与事实错误,人工介入点设在风险与置信度的交叉处。
- 能理解提示注入的攻击面(直接与间接),并为工具调用划定最小权限边界。
各节怎么分工
| 节 | 回答的问题 | 关键产出 |
|---|---|---|
| 7.1 智能体评测 | 怎么度量一个多步系统的好坏 | 评测集结构、指标体系、判分脚本 |
| 7.2 四大技术挑战 | 幻觉等老毛病在新形态下的表现 | 挑战-症状-对策对照 |
| 7.3 护栏三道闸 | 错误动作怎么在发生前被拦住 | 护栏管道代码与介入点设计 |
| 7.4 安全与对齐 | 注入、越权、外泄怎么防 | 攻击面分析与防线配置 |
先决条件
- 读完第 2 章:护栏拦的对象是"即将执行的工具调用",不了解调用机制就没法设计拦截点。
- 读完第 4 章:评测的基本单位是"任务",即一次完整的规划执行过程。
往下走到哪
评测给了底气,护栏给了底线,第八章处理最后一件事:把这套系统以什么形态部署到真实业务里,并在成本、延迟、降级、回滚四个维度上做好生产准备。
指标谈不拢时的一个解法
评测体系建设最常见的卡点不在技术,而在"达标线定多少"——业务方要九成九,工程方敢承诺八成五,会议不欢而散。一个有效的解法是把单一达标线改成成本加权线:给正确任务的价值与错误任务的代价各估一个金额,智能体的"净期望值"为正且高于现有人工流程,即可放行。这条算法把讨论从"它够不够好"转移到"它比现状好在哪",而后者是可计算的。八成五的成功率在低代价场景(内部查询)净值为正,在高代价场景(对外承诺)净值为负——同一套系统在不同风险档位上的放行结论理应不同,成本加权线把这个常识变成了可审计的数字。本章四节给出的所有指标,最终都是为了喂给这类计算。
护栏与评测的启动次序
两套机制的搭建次序有讲究:护栏先行、评测跟上、互相喂养。原因在于顺序颠倒的代价不对称——没有评测就上护栏,介入点靠拍脑袋设,误拦漏拦都无数据可依;没有护栏只有评测,问题只能事后发现,错误动作已经造成了真实损失。推荐的实际次序是:先把 7.3 的三道闸按最小配置立起来(风险清单来自设计阶段的能力-风险对照表),让每笔拦截与放行都有日志;评测集从这些日志里长出来(被拦的、放行的、人工改判的,全是用例素材);评测跑出基线后,再回头校准护栏的阈值与介入点。两套机制以周为单位互相迭代,一个月后就能达到"评测说得清、护栏拦得准"的稳态——稳态之后,第八章的部署才有资格提上日程。