1.6 频率分析与古典密码的陷落
1.6 频率分析与古典密码的陷落
本节摘要:频率分析利用自然语言字母出现频率的稳定性破译替换密码;卡西斯基测试则通过密文重复片段的距离测出维吉尼亚密钥长度,把多表替换打回单表。本节以破译者视角完整走一遍这两套攻击,解释古典密码整体陷落的原因:只要明文自带统计结构,密文就藏不住。
破译者的视角:语言本身就是泄密者
九世纪的阿拉伯学者肯迪在《解码手稿》里写下的方法,今天仍是密码分析课的开篇内容:同一种语言里,字母出现的频率是长期稳定的。英语文本中 E 以约 12.7% 的占比遥遥领先,T 约 9.1%、A 约 8.2%、O 约 7.5%;而 Z、Q、X、J 合计不足半个百分点。双字母组合同样有惯性:TH、HE、AN、IN、ER 出现得最频繁;单词层面 THE 独占鳌头。中文里"的、是、了、一"的排序同样常年稳定。这些统计量不是密码学家发明的,是语言本身自带的"指纹"。
图:英语字母出现频率分布(百分比)
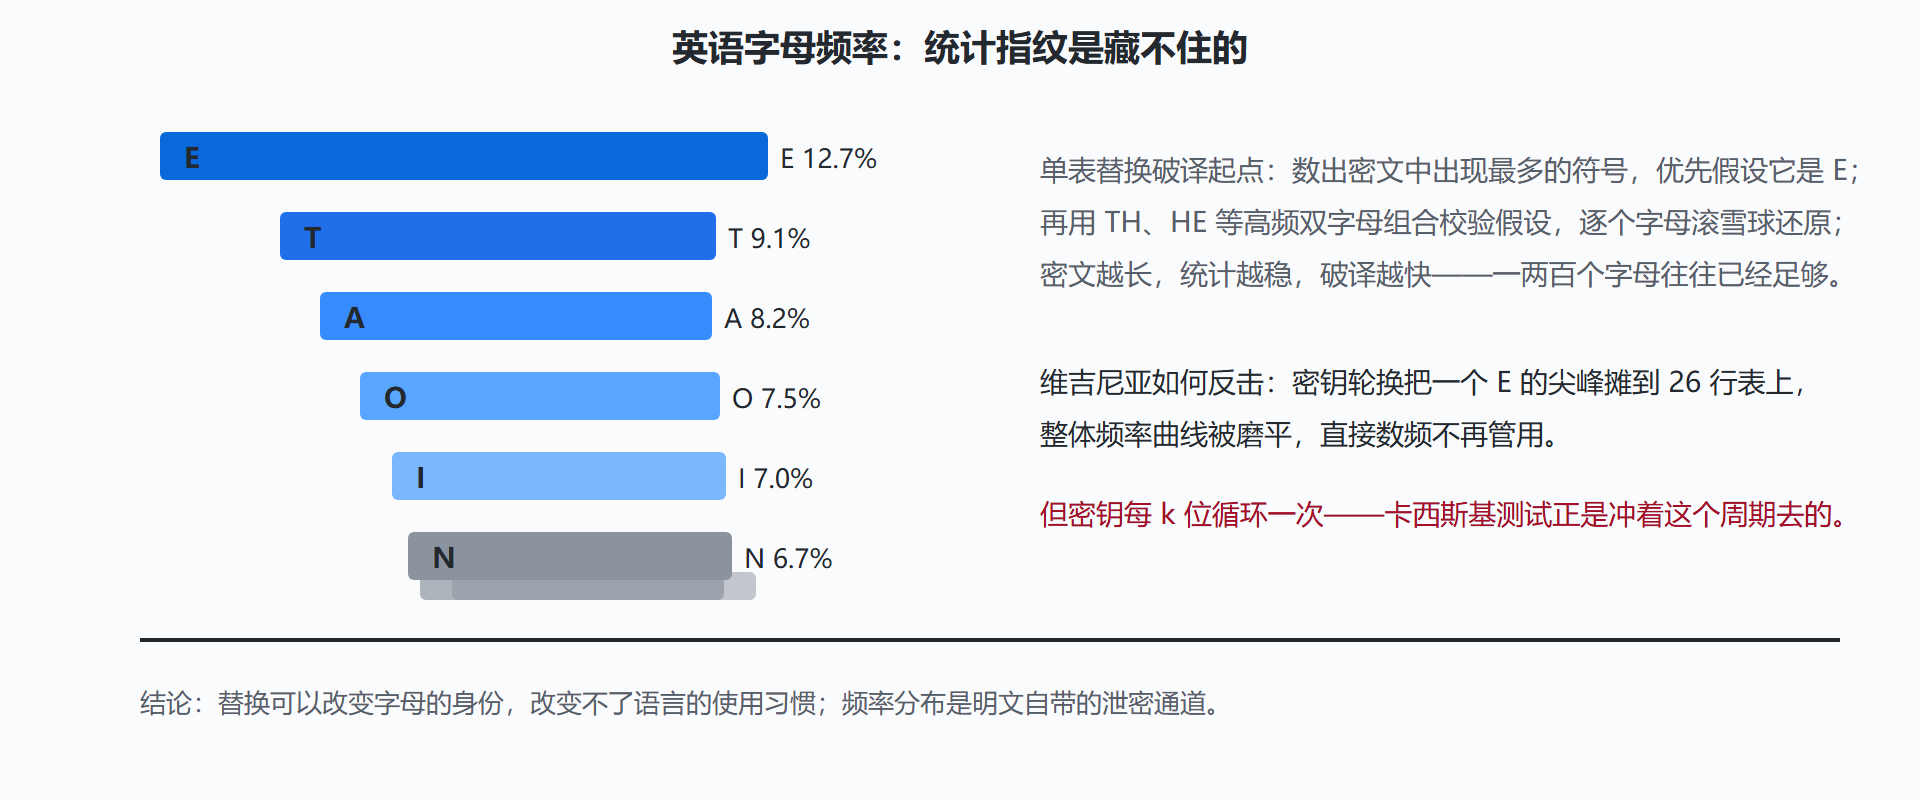
对单表替换,攻击流程标准化为四步:数频、假设、代入、滚雪球。先数出密文里出现最多的符号,假设它对应 E;再找三字母组里孤立出现最多的,假设是 THE;代入后观察哪些词形浮现(比如 _OO_ 大概率是 FOOT 或 LOOK),逐个字母修正。熟练的分析者破一段几百字母的单表密文只需几十分钟——十九世纪的报务房里这是日常手艺。
二、卡西斯基测试:给密钥周期量一次脉搏
维吉尼亚把频率摊平了,但密钥是循环使用的。普鲁士军官卡西斯基在 1863 年出版的《密码与破译艺术》里发表了针对它的完整方法(巴贝奇更早得出同样的结论,因战争敏感从未公开)。核心观察:**当明文中同一段字母恰好两次都对齐在密钥的同一相位上时,两处密文完全相同。**这样的重复片段在长密文里几乎必然出现——THE、AND、TION 这类高频组合就是现成的"对齐触发器"。
测出两处重复片段起点之间的距离后,该距离必为密钥长度的整数倍。收集多组重复距离,取其公因数中出现次数最多者,密钥长度 k 便浮出水面。k 一旦确定,攻击瞬间降维:把密文按位置模 k 分成 k 组,每一组的加密密钥恒定——每一组都是一张凯撒移位表。对每组做一次频率匹配(E 假设、频差平方和打分均可),k 个移位量凑齐,明文整段还原。
用 Python 把整个流程骨架写出来:
from math import gcd from collections import Counter def kasiski(ct, n_len=3, top=5): """找重复片段并统计片段间距的公因数""" pos = {} dists = [] for i in range(len(ct) - n_len + 1): seg = ct[i:i + n_len] pos.setdefault(seg, []).append(i) for seg, ps in pos.items(): for a in ps: for b in ps: if b - a > 2: dists.append(b - a) # 重复片段的距离 votes = Counter() for d in dists: for f in range(2, d + 1): if d % f == 0: votes[f] += 1 # 距离的因数各得一分 return votes.most_common(top) ENGLISH = {'E':12.7,'T':9.1,'A':8.2,'O':7.5,'I':7.0,'N':6.7,'S':6.3,'H':6.1,'R':6.0} def score_shift(column, shift): """把一组密文按移位量还原后,与英语频率表算匹配分""" plain = [chr((ord(c) - 65 - shift) % 26 + 65) for c in column] cnt, total = Counter(plain), len(plain) return sum((cnt[ch] / total) * p for ch, p in ENGLISH.items()) def break_vigenere(ct, k): """已知密钥长度 k,逐列挑出匹配分最高的移位量""" key = [] for r in range(k): col = ct[r::k] # 位置模 k 相同的列 best = max(range(26), key=lambda s: score_shift(col, s)) key.append(best) return "".join(chr(65 + s) for s in key) # ct 为密文字母串时:先 kasiski(ct) 估密钥长度,再 break_vigenere(ct, k) 还原密钥
这段代码在几 KB 的密文上就能稳定工作:kasiski 给出候选长度,break_vigenere 输出密钥词。十九世纪破译员用手与纸做同样的事,只是慢得多。
三、陷落的完整复盘与历史回响
把本章的攻防线收拢成一张胜负表:凯撒死于穷举(25 次尝试);单表替换死于频率分析(密钥空间 4×10²⁶ 形同虚设);换位死于频率分布原样暴露;维吉尼亚死于周期性(卡西斯基测试降维回单表)。四案并读,指向同一条根因——古典密码只是对字母做置换游戏,而语言自身的统计结构渗透进任何保持字母——位置局部对应关系的变换里。
这场陷落的回响很长远。其一,它逼出了"密码强度必须有客观度量"的诉求,这个诉求在 1949 年由香农给出第一个严格答案(完善保密性,见第 2 章)。其二,"多表轮换"作为对抗统计的思想并没有死:维吉尼亚是"用短密钥流给明文逐位加掩码"的雏形,把密钥流换成密码学安全的伪随机序列,它就进化成了流密码(第 3 章);把轮换规则升级成机械转子,它就变成了恩尼格玛(第 2 章)。古典密码的尸体上,站着现代密码的祖先。
💡 关键直觉:频率分析攻的从来不是算法,是语言。破译者利用的每一条线索——字母频率、双字母组合、重复片段——都是明文自带的信息。真正安全的密码必须做到:密文在统计上与随机噪声无法区分。
本节要点回顾
- 频率分析以字母频率的稳定性为支点,按"数频、假设、代入、滚雪球"四步破开一切单表替换;
- 卡西斯基测试用重复片段距离的公因数估计密钥长度 k,把维吉尼亚切成 k 张凯撒表逐个击破;
- 共同根因:明文的统计结构会渗入任何局部映射型密码,这是古典时代集体陷落的原因;
- 思想遗产:多表轮换进化为流密码与转子机,"密文应与随机不可区分"成为现代设计的公理。
古典密码的落幕不是终点。下一章镜头转向二十世纪上半叶:机电转子机把多表替换推上机械复杂度的巅峰,战争把密码学变成国家工程,而图灵与香农将分别从"破"与"立"两侧给这门学科装上数学的引擎。