4.2 RSA 算法:大整数分解的赌注
4.2 RSA 算法:大整数分解的赌注
本节摘要:RSA 把安全性押在一句人尽皆知、却无人能做到的话上:把两个大素数相乘很容易,把乘积分解回这两个素数极难。本节走完密钥生成、加密、解密的全流程,解释欧拉定理如何保证加解密互逆、2048 与 3072 位模长如何随算力演进、教科书 RSA 的三宗罪,以及它作为签名算法的第二次生命。
素数相乘容易,分解很难
1977 年,麻省理工学院的 Ron Rivest、Adi Shamir 与 Leonard Adleman 读到 Diffie-Hellman 的论文后,着手补上"陷门"这个缺口。他们的答案藏在两百年前的数论里:找两个大素数 p 与 q,乘积 n = pq 公开,则凡知道 p 与 q 的人都能轻松算出 n 的欧拉函数 φ(n) = (p-1)(q-1),而不知道的人想算 φ(n) 等价于分解 n。私钥的全部秘密就是这两个素数——大整数分解的难度,就是 RSA 的安全边际。
完整流程只需四步,先用教学级小参数走一遍:
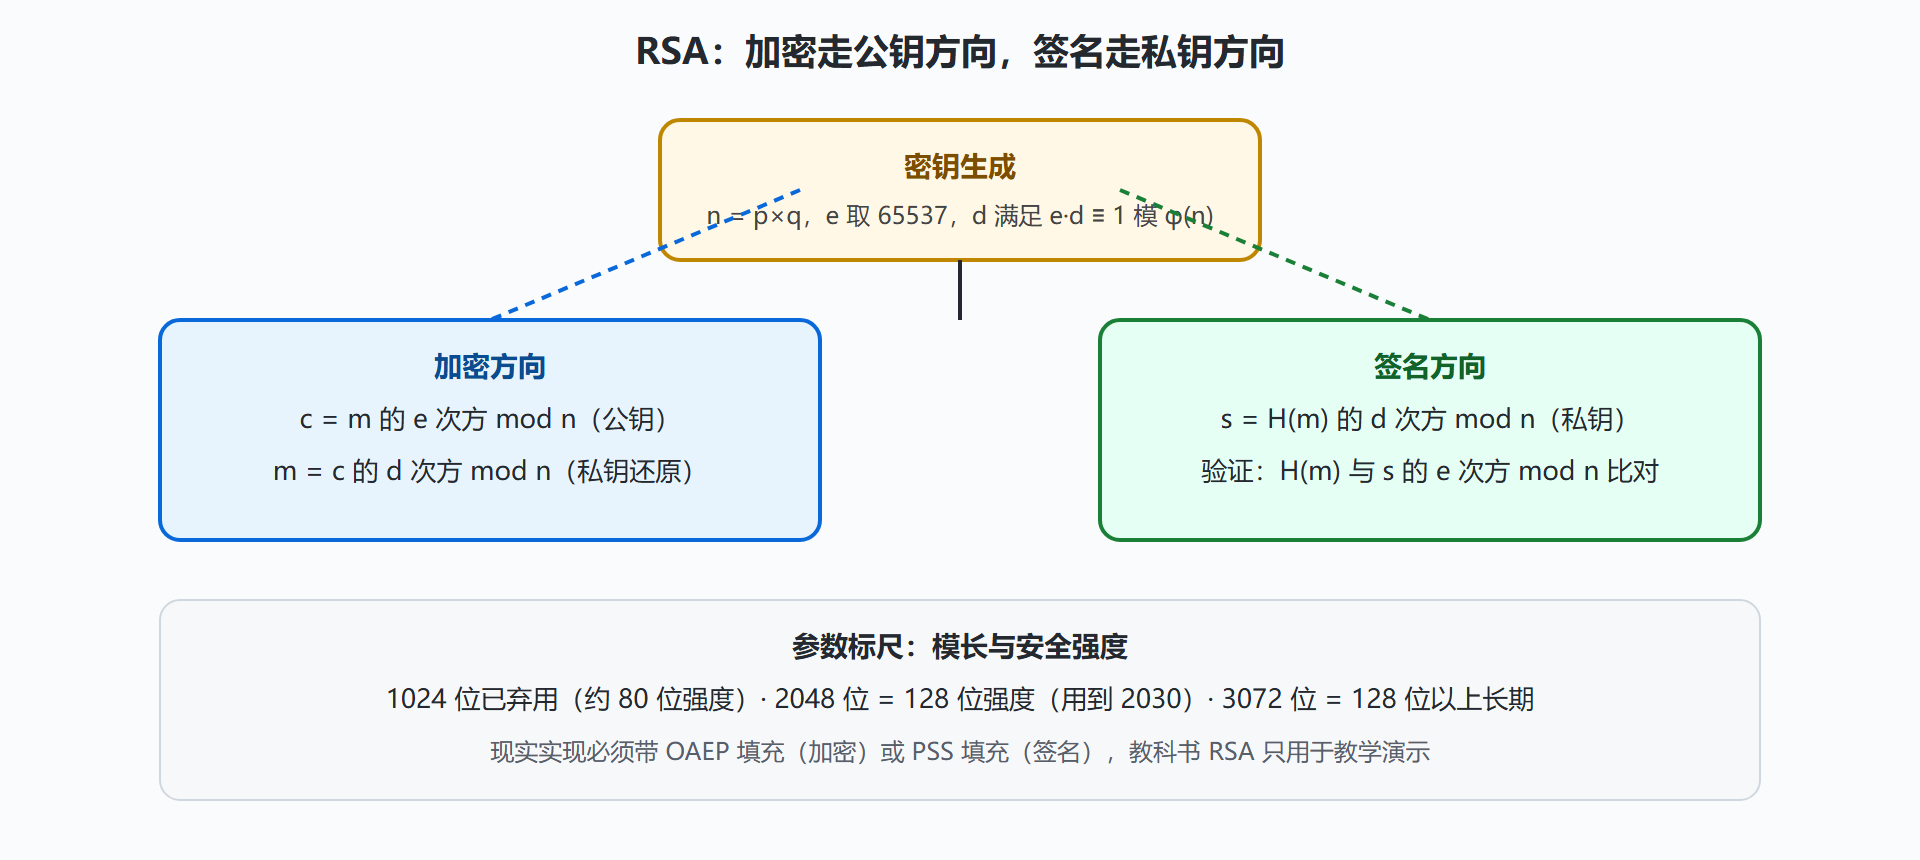
- 选钥:取素数 p、q(真实场景各为 1024 位以上);算 n = pq 与 φ(n) = (p-1)(q-1);选公钥指数 e(常取 65537,与 φ(n) 互素);求私钥指数 d,满足 e·d ≡ 1 (mod φ(n));
- 公开:公钥 = (n, e),私钥 = (n, d),p、q、φ(n) 用完即毁;
- 加密:密文 c = m^e mod n;
- 解密:明文 m = c^d mod n。由欧拉定理 m^(e·d) ≡ m (mod n),互逆性由数论保证,而非电路技巧。
# 教学版 RSA:数字仅两位量级,真实密钥为 2048/3072 位 from math import gcd def make_keys(p, q, e=65537): n, phi = p * q, (p - 1) * (q - 1) d = pow(e, -1, phi) # 求 e 模 phi 的逆元 return (n, e), (n, d) def rsa(msg_int, key): n, k = key return pow(msg_int, k, n) # 加密用 e,解密用 d pub, pri = make_keys(61, 53) # n = 3233 print(pub) # -> (3233, 65537),e 需与 phi 互素(此处恰好成立) m = 65 # 字母 A c = rsa(m, pub) print(c, rsa(c, pri)) # 加密再解密,还原 65
小参数下 d 用扩展欧几里得或内置逆元一步求出;真实实现里 p、q 由密码学安全随机数在大区间内筛出,整个密钥生成在毫秒级完成——生成容易、破解无望,天平的倾斜全在分解难度上。
二、模长竞赛:512 到 2048 再到 3072
RSA 的密钥长度指的是模数 n 的二进制位数,而"安全"的参照物始终是分解算法的进步。1990 年代 512 位模长被逐步逼近,1999 年 RSA-155(512 位)被分解成功,互联网界仓促迁移;2010 年 RSA-768 沦陷(约两千 CPU 年的计算);行业共识随之落定为 2048 位起步。NIST 的现行指引给出时间表:2048 位可支撑到 2030 年前后,长期机密应迁移到 3072 位。参照系是 NIST 的安全强度分级:2048 位 RSA 与 128 位对称安全强度相当——记住这个"约 16 倍换 1"的兑换率,4.4 节对比 ECC 时它就是标尺。
分解难度的另一个变量是算法本身:普通数域筛(GNFS)让分解难度以亚指数速度下降,这也是 RSA 模长必须持续加宽的原因。而 1994 年 Shor 提出的量子算法将在多项式时间内完成分解——这把悬在 RSA 头上的剑,第 7 章再郑重出鞘。
图:RSA 一次完整加解密的数据流与签名方向
三、教科书 RSA 的三宗罪
用上面的四步公式直接上线,会死得很利索。工程规范(PKCS#1)为此定义了两套填充方案,三宗罪也各有对应解法:
- 确定性加密:同一明文永远得到同一密文,语义安全为零(回想 3.3 节的企鹅)。解法是 OAEP 填充——加密前先混入随机数,让每次密文不同;
- 可塑性:RSA 的乘法同态让攻击者可以构造 c×e' 的密文,解密后得到被篡改的明文。OAEP 同样封住此路;
- 密钥选用的随意:过小的 e(如 3)配合不填充会直接遭低指数攻击;公钥指数固定 65537、签名用 PSS 填充,都是把数学风险前置到规范里消化。
此外还有一条工程常识:RSA 慢且单次只能处理小于模数的数据块(2048 位模数约 245 字节),所以它从不直接加密文件或报文——数据交给 AES,RSA 只负责加密那把 AES 会话密钥(混合加密),或对消息的 SHA-256 摘要签名。签名走"哈希再签"两步,也让任意长度消息的签名成本恒定。
⚠️ 常见坑:把教科书公式当成生产代码。真实场景必须使用经过审计的密码库,并检查填充方案与模长——RSA 的事故几乎全是"自己实现、忘了填充"造成的,而不是数学被攻破。
三个问答
问:公钥指数为什么固定 65537?它是 2 的 16 次方加 1,二进制里只有两个 1,模幂最快;又足够大以避开低指数攻击的历史坑。在正确填充之后,指数的选择不再影响安全性,65537 是性能与稳健的折中。
问:旧版填充为什么被 OAEP 取代?1998 年布莱肯巴赫演示了逐字节恢复明文的选择密文攻击——解密服务对填充错误的响应差异成了预言机。OAEP 从构造上切断了这条信道,新系统一律应使用 OAEP。
问:RSA 的签名与验证速度为什么不对称?公钥指数小,验签远快于签名;私钥运算借中国剩余定理还能再加速约四倍。这些工程细节决定了 RSA 在证书签名场景依然常见,而在握手加密里早已退场。
本节要点回顾
- 数学骨架:n = pq 公开、φ(n) = (p-1)(q-1) 保密,ed ≡ 1 (mod φ(n)),加密 m 的 e 次方、解密 c 的 d 次方,欧拉定理保证互逆;
- 参数标尺:2048 位模长支撑至 2030 年,3072 位用于长期机密;1024 位已弃用;
- 三宗罪与解法:确定性、可塑性、低指数攻击均由 OAEP/PSS 填充规范解决,自实现 RSA 是事故重灾区;
- 角色定位:RSA 从不加密大数据,现实身份是"会话密钥的信封"与"哈希的签名者"。
RSA 解决了"送信",Diffie-Hellman 则在另一条战线上解决"见面"。下一节看密钥交换的原始魔术:双方从未谋面,如何在众目睽睽下算出同一个秘密。