3.2 航路搜索:状态空间搜索与决策算法
3.2 航路搜索:状态空间搜索与决策算法
本节摘要:搜索是规划舱的算法底座:把找路形式化为状态空间上的系统探索。本节给出状态空间的建模四件套,对比无信息搜索与启发式搜索的分野,重点拆解 A 星算法——代价加启发、可纳性保最优、加权变体换速度,并交付一份可直接套用的 A 星实现与联调基准。
在电子领航出现之前,跨洋航线是领航员用纸图、计算尺和天文表一笔一笔算出来的:已知起点与终点,中间每一步的航向都要人工推演,遇到气流还要从头再来。今天的导航计算机干的是同一件事,只是把"推演"交给了系统化的搜索——在状态空间里,从初始状态出发,沿着后继关系系统性地展开,直到触达目标。上一节的任务单给出了起点与终点,本节负责把中间的路填实。
状态空间:建模四件套
一切搜索算法共享的形式骨架是四件套:状态(对局面的完整描述——拓扑层的当前节点,或几何层的当前格)、后继函数(从状态能到哪些状态、代价多少)、目标测试(3.1 节的验收谓词在这里复用)、初始状态。建模质量直接决定搜索成败:状态定义得太粗,解不存在;太细,空间爆炸。第 2 章分层航图的真正回报在这里兑现——全局问题在拓扑层搜(百级节点),局部问题在几何层搜(万级格),同一套算法跑两种粒度。
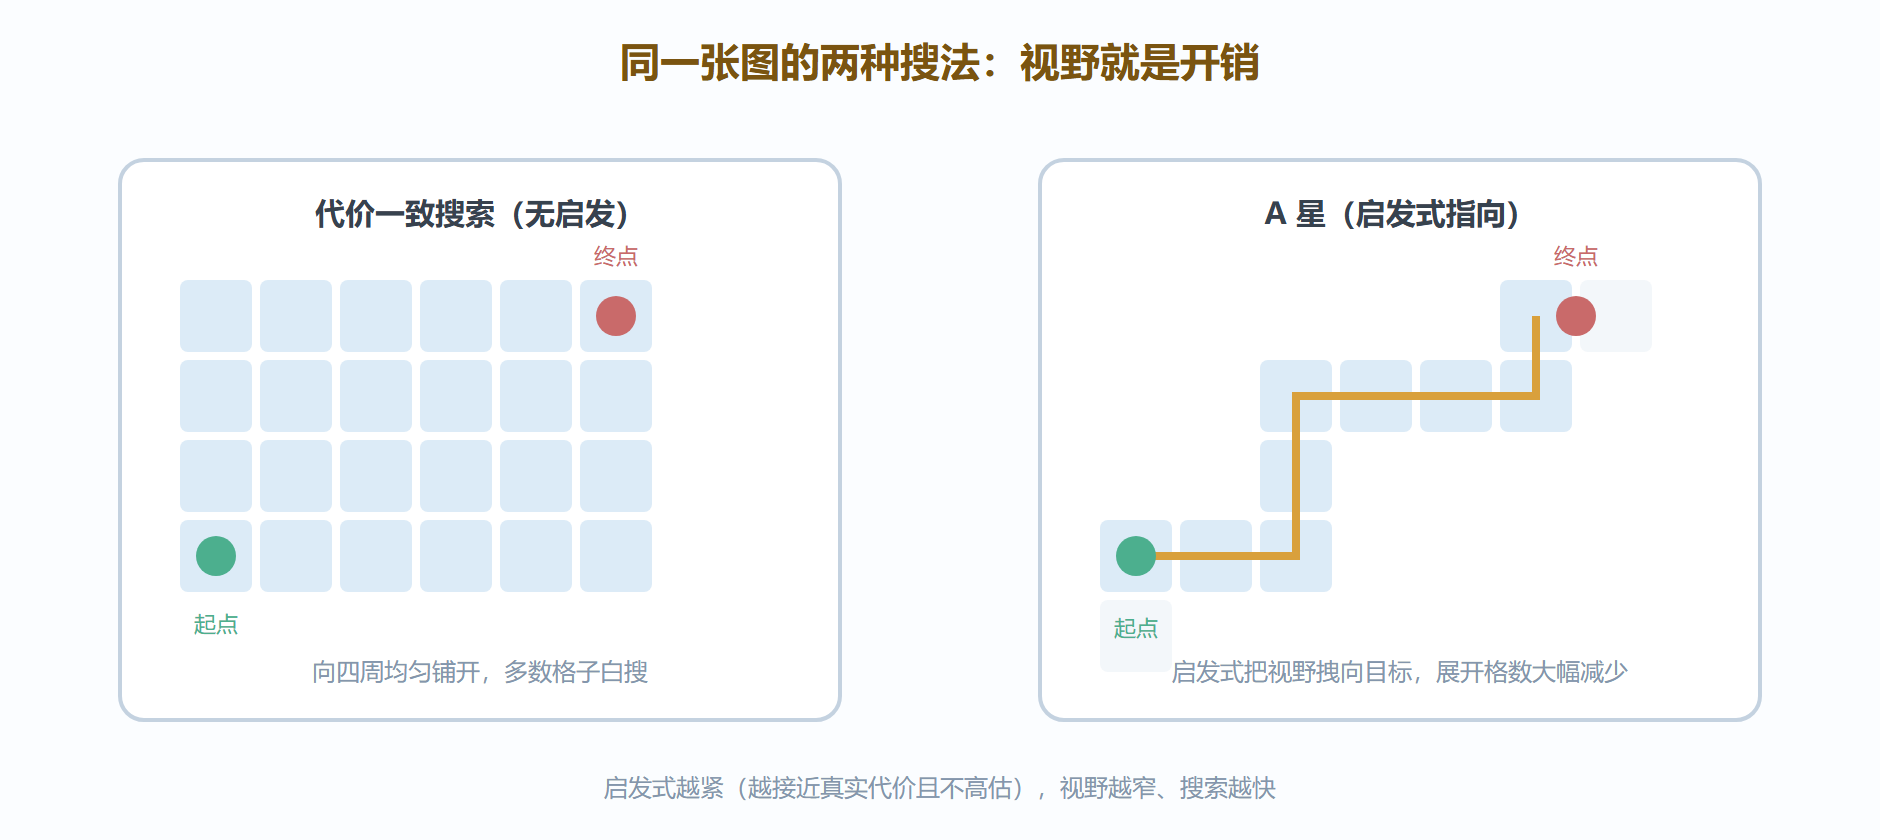
无信息搜索(广度优先、深度优先、代价一致)分不清目标远近,只知道盲目展开,小空间可用、大空间失速。工程主力是启发式搜索:给每个状态估一个"离目标还有多远"的直觉分,让搜索朝看起来更近的方向倾斜。
A 星:代价加直觉
A 星的评价函数是一行小学算术:f(n) = g(n) + h(n)。g 是从起点到当前状态的实际代价,h 是当前状态到目标的估计代价(启发式)。每次从开放列表里取 f 最小的状态展开——既不忽视已花掉的代价(这是贪心最佳优先的错误),又不忽视剩余的估计(这是代价一致的低效)。
A 星的精华在启发式的设计纪律。可纳性(启发式从不高估真实剩余代价)保证找到的路径最优;一致性(启发式满足三角不等式)保证每个状态第一次被展开时就已经最优,无需反复松弛。网格上常用欧氏距离(可纳但保守)或对角距离(更紧更快),拓扑图上用预计算的节点间下界。启发式越紧搜索越快,但越过真实代价的瞬间,最优性作废——这是一条不许越界抢跑的赛道。
实战中还有两个高频变体。加权 A 星给 h 乘一个大于一的系数,刻意高估剩余代价,搜索明显变快、路径最多差一个加权因子倍——动态空域里"快而略次优"常常优于"最优但迟到"。增量式重规划(D 星一类)在环境小变化时只修补受影响的搜索结果而不从零重算,是 3.4 节触发式重规划的算法支撑。
import heapq def astar(start, goal_test, successors, h): """通用 A 星:状态任意,只要提供后继与启发式。 successors(s) -> [(next_s, cost), ...] h(s) -> 剩余代价估计(须可纳) """ open_heap = [(h(start), 0.0, start)] # (f, g, 状态) came = {start: None} # 回溯指针 best_g = {start: 0.0} closed = set() while open_heap: f, g, s = heapq.heappop(open_heap) if s in closed: continue # 过期条目跳过 if goal_test(s): return reconstruct(came, s), g # 路径与总代价 closed.add(s) for ns, cost in successors(s): ng = g + cost if ns in best_g and ng >= best_g[ns]: continue # 不是更优的入场券 best_g[ns] = ng came[ns] = s heapq.heappush(open_heap, (ng + h(ns), ng, ns)) return None, float("inf") # 目标不可达 def reconstruct(came, s): path = [] while s is not None: path.append(s) s = came[s] return path[::-1] # 拓扑层调用示例:全局路由跑在百级节点上 # route, cost = astar( # start="dock_in", # goal_test=lambda n: n == "loading_bay", # successors=lambda n: cabin_map.topo_neighbors(n), # h=lambda n: cabin_map.topo_heuristic(n, "loading_bay"), # )
实现里有三处工程细节值得画重点:开放列表用堆而非线性扫描(状态量大时的生死项);best_g 重复入堆、弹出时用 closed 过期作废——这是延迟删除的标准写法,比在堆里改键简单得多;返回值带总代价,供任务单的效用函数与日志审计使用。
加权变体与启发式构造各给一段,方便按空域换挡:
def heuristic_grid(goal, name="diagonal"): """网格启发式:欧氏保守,对角更紧。""" def euclid(s): return ((s.x - goal.x) ** 2 + (s.y - goal.y) ** 2) ** 0.5 def diagonal(s): dx, dy = abs(s.x - goal.x), abs(s.y - goal.y) return (dx + dy) + (2 ** 0.5 - 2) * min(dx, dy) return {"euclid": euclid, "diagonal": diagonal}[name] def weighted_astar(start, goal_test, successors, h, eps=2.0): """加权 A 星:eps 倍高估剩余代价,换搜索速度。 保证:路径代价不超过最优的 eps 倍。 """ open_heap = [(eps * h(start), 0.0, start)] best_g, came, closed = {start: 0.0}, {start: None}, set() while open_heap: _, g, s = heapq.heappop(open_heap) if s in closed: continue if goal_test(s): return reconstruct(came, s), g closed.add(s) for ns, cost in successors(s): ng = g + cost if ns not in best_g or ng < best_g[ns]: best_g[ns] = ng came[ns] = s heapq.heappush(open_heap, (ng + eps * h(ns), ng, ns)) return None, float("inf")
图:搜索视野对比——Dijkstra 蛮力铺开与 A 星定向生长
联调测试与故障排查
搜索的联调用基准图法:准备有标准答案的测试图(手工验证过的最短路),回归比对路径代价与展开节点数;再加对抗图——迷宫、对称陷阱、动态增删边,专测边界条件。性能基准记录展开节点数与耗时曲线,作为后续优化的对照组。
按症状排查:路径明显绕远先查启发式是否高估(可纳性被破),再查边的代价口径是否一致(几何层距离与拓扑层折算混用是惯犯);搜索超时先看状态空间是否该换层(全局问题别在几何层跑),再收紧启发式或上加权变体;找不到已知存在的路查目标测试与后继函数的口径差(目标在障碍内、后继漏了某类移动);内存膨胀是开放列表堆积,检查过期条目清理与状态哈希的实现。
💡 关键直觉:搜索快不快,一半在算法一半在表征。同一张 A 星实现,跑在百节点的拓扑层与百万格的几何层是两种人生——先问"这个问题在哪层搜",再谈调参。
本节要点回顾
- 建模四件套:状态、后继、目标测试、初始状态;分层航图让同一套算法跑全局与局部两种粒度。
- A 星 = g + h:不忽视已花的代价,也不忽视剩余的估计;可纳启发式保最优,一致性保一次展开即最优。
- 变体选型:加权 A 星用次优换速度,增量重规划用修补换响应,都是工程允许的正规操作。
- 实现细节:堆做开放列表、延迟删除、总代价随路径返回,三处细节在状态量大时决定生死。
- 基准纪律:标准图回归加对抗图加性能曲线,搜索改动必须过基准。
搜索解决了"这条路怎么走",但每个任务都从头搜索既慢又脆。下一节把领域知识预制成飞行程序库:HTN 方法展开与行为树执行,让常用套路不必每次重新发明。