3.4 气象绕飞:不确定性下的规划与推理
3.4 气象绕飞:不确定性下的规划与推理
本节摘要:感知有误差、执行有偏差、环境会变脸——确定性计划天生是脆的。本节把不确定性的三个来源拆开定量,给出应对的三件武器:触发式重规划(改航线)、策略式规划(预答所有局面,马尔可夫决策过程与值迭代)、预案式规划(关键分叉备支线),并以蒙特卡洛推演作为联调与选型的统一标尺。
航空史的早期,气象情报靠站台的人工观测加电报接力,航路天气对机组而言是一张几小时前的旧照片——绕飞决策全凭机长对云形的经验。今天的气象雷达让"边飞边看"成为可能,但绕飞的本质问题没变:你必须在信息不全时做出还会影响很久的决定。规划舱的处境一模一样:2.3 节的信念带着置信度,执行会有偏差,空域里还有别的运动物体。前三节的所有算法都默认一个安静的世界,本节把风请回来。
不确定性的三个来源与定价
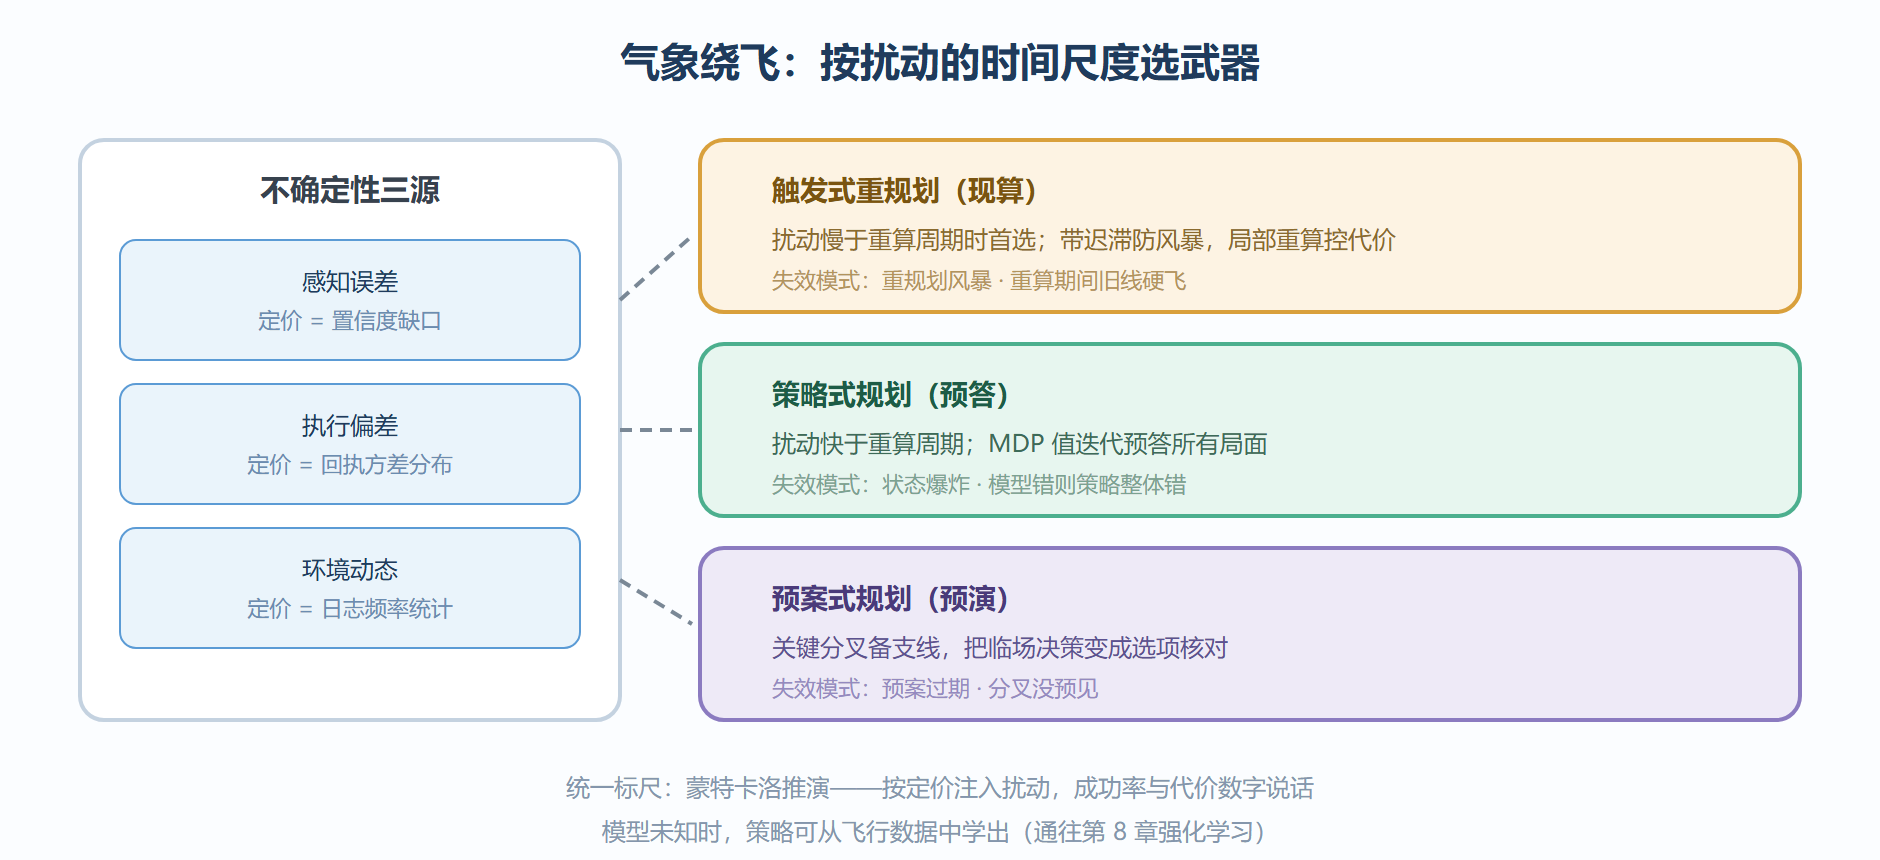
先定量再谈武器。感知误差:信念的置信度是现成的定价——置信度零点八的障碍位置,绕飞余量就得按零点二的误差概率放大。执行误差:行动舱的回执统计(第 4 章)给出偏差分布——指令"前进一米"实际落点服从某个方差,路径两侧的余量据此加宽。环境动态:他机轨迹、门的开合、任务插单,这类不完全可预测的变化只能按频率建模——历史日志统计出"每小时被插单的次数",就是它的价格标签。三样加总,规划舱面对的从来不是一张地图,而是一团带方差的可能世界。
应对武器按响应速度排成三档,选型判据是扰动的时间尺度:扰动快于重算周期就必须预答(策略),慢于重算周期可以现算(重规划),介于两者之间的关键分叉值得预演(预案)。
武器一:触发式重规划
最直觉的一档:航线带过期条件(第 1.2 节埋的契约),感知发现航线上出现新障碍、或执行偏差超出走廊宽度,触发重算。工程要点有三:触发条件要带迟滞(障碍刚探头就重算、移开又恢复,会引发重规划风暴——触发与解除各留缓冲带);重算要限定范围(局部绕飞从偏离点重搜,别全图重来;3.2 节的增量式搜索在这里兑现价值);重算期间要有降级行为(减速、悬停等待,旧航线不能硬飞)。重规划不是失败,是闭环的正常呼吸——但呼吸频率失控就是病。
武器二:策略式规划——预答所有局面
如果扰动快得来不及重算,就得在起飞前回答所有可能局面:每个状态该做什么,这份完整答案叫策略。马尔可夫决策过程(MDP)是它的数学骨架:状态、动作、转移概率(动作后世界怎么变的概率分布)、奖励(每步的得失),求解目标是找到最大化长期累计奖励的策略。值迭代是可运行的最小解法:反复"用后继状态的价值更新当前状态的价值",收敛后每个格子上的最优动作连成策略。它的精神与 A 星互补——A 星答"这一条路怎么走",值迭代答"所有局面分别怎么走"。
def value_iteration(states, actions, trans, reward, gamma=0.95, theta=1e-4, max_iter=1000): """小型 MDP 值迭代:网格世界级规模。 trans(s, a) -> [(next_s, prob), ...] 转移概率 reward(s, a) -> float 即时奖励(负数即代价) """ V = {s: 0.0 for s in states} for _ in range(max_iter): delta = 0.0 for s in states: best = max( sum(p * V[ns] for ns, p in trans(s, a)) + reward(s, a) for a in actions(s) ) delta = max(delta, abs(best - V[s])) V[s] = best if delta < theta: # 价值不再明显变动即收敛 break # 从价值函数抽取策略:每格选期望价值最高的动作 policy = {} for s in states: policy[s] = max( actions(s), key=lambda a: sum(p * V[ns] for ns, p in trans(s, a)) + reward(s, a), ) return V, policy
策略式规划的适用边界要划清:状态空间随维度指数膨胀,千百格的网格世界可行,连续高维任务只能靠近似(这也是第 8 章强化学习的入口——当模型本身未知时,用飞行数据学出价值或策略)。工程上最常见的混合用法:关键区段用策略兜底,长程骨架用程序与搜索——舱口、坡道、会车区这类高频扰动点预答好,主干航线照常规划。
武器三:预案式规划与蒙特卡洛推演
介于两档之间的是预案:不为所有局面预答,只为可预见的关键分叉备好支线——"主航线被占用则改走备用走廊""充电桩满则先去待命位"。预案的价值在于把临场决策变成选项核对,人的监督与干预(第 4.4 节塔台频道)也因此有了清晰的抓手。
三件武器的联调统一交给蒙特卡洛推演:把感知噪声、执行偏差、环境扰动按定价注入仿真,成百次随机推演计划或策略的完整执行,统计成功率、平均代价与最坏情形。推演是选型的标尺——哪档武器把成功率托到验收线以上、代价增加多少,数字说话;推演也是回归的标尺——任何规划改动都要重跑同一组种子,防止"修好一处、踩坏别处"。
触发式重规划的核心是带迟滞的触发器,骨架如下:
class ReplanTrigger: """重规划触发器:迟滞带宽防风暴,冷却期防震荡。""" def __init__(self, board, enter=0.6, exit=0.3, cooldown_s=2.0): self.board = board self.enter, self.exit = enter, exit # 进入/解除阈值不对称 self.cooldown = cooldown_s self.active = False self._last_fire = 0.0 def feed(self, obstacle_ratio, now): """obstacle_ratio:当前航线上新障碍的占比。""" if now - self._last_fire < self.cooldown: return False # 冷却期内不重算 if not self.active and obstacle_ratio > self.enter: self.active = True # 越进入线才触发 self._last_fire = now return True if self.active and obstacle_ratio < self.exit: self.active = False # 越解除线才复位 return False def replan_local(board, search, from_offset=2): """局部重算:从偏离点重搜到下一航点,不全图重来。""" pos = board.read("pose").value dest = board.read("route").value.nearest_waypoint( ahead_of=from_offset) segment, cost = search.query(pos, dest) board.read("route").value.splice(segment) # 只换这段 return cost
图:不确定性三源与三件武器的对位
联调测试与故障排查
本节联调已并入蒙特卡洛推演,补充的是扰动注入的纪律:噪声参数要与 2.3 节的一致性检验结果、第 4 章的回执统计对账——注入的分布与真实分布不符,推演出的成功率就是自欺。每季用真实日志校一次扰动定价,推演结论才有保鲜期。
按症状排查:重规划风暴(重算频率失控)查触发条件有无迟滞、迟滞带宽是否小于扰动抖动幅度;策略在仿真里完美、实机拉胯是建模与现实失配——转移概率或奖励写错,先回放真实数据验模型;预案从不被触发要么分叉预判错了(该备的没备),要么触发条件太苛(备了用不上),推演日志里看预案触发率;推演通过率虚高查随机种子多样性——同一组种子跑到底会错过小概率绝境。
💡 关键直觉:不确定性规划的功夫不在算法里,在定价里。置信度、方差、频率三本账记得准,三件武器怎么选都是顺水推舟;账目失真,再漂亮的值迭代也只是在错误的世界里求最优。
本节要点回顾
- 先定价再应对:感知误差看置信度、执行偏差看回执方差、环境动态看频率统计,三本账决定一切选型。
- 触发式重规划:扰动慢于重算周期时首选;迟滞防风暴、局部重算控代价、降级行为兜底等待期。
- 策略式规划:MDP 与值迭代预答所有局面,适用高频扰动区段;状态爆炸与模型失配是边界。
- 预案式规划:关键分叉备支线,为临场决策与人工监督留抓手。
- 蒙特卡洛推演:选型与回归的统一标尺,扰动定价必须与真实分布对账。
航线终于带上了绕飞预案与过期条件,可以交付执行了。下一章行动舱接舵:指令怎么变成动作、偏差怎么被监控、失败怎么变成复飞而不是坠机。