4.2 报文字段、消息类型与Token
4.2 报文字段、消息类型与 Token
本节摘要:把 CoAP 报文头部逐字段拆开(版本、类型、Token 长度、Code、消息 ID),讲清 CON/NON/ACK/RST 四类消息的语义,以及 Token 与 Message ID 在请求响应对齐里各唱什么角色。承接 4.1 资源模型,通往 4.3 的方法与观察。
CoAP 的报文头很短,字段精巧到"每比特都有话说"。看懂这些字段,你就能理解 UDP 上那套"没连接也要认出来回是谁"的机制。
头部四字段,一张图说清
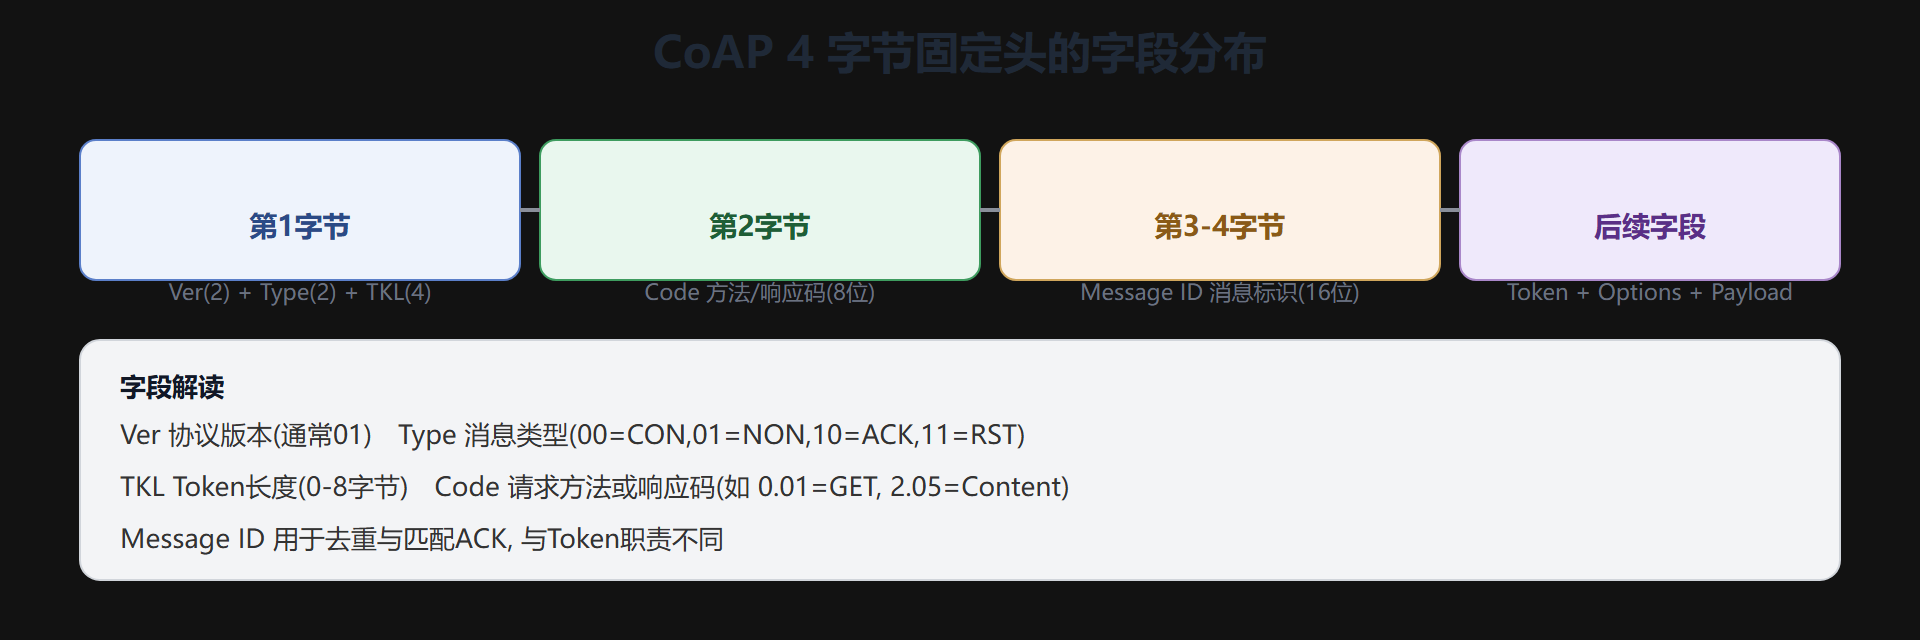
CoAP 的默认为 4 字节固定头,随后是可选 0~8 字节的 Token、选项链表与载荷。报文结构如下:
四类消息:CoAP 在 UDP 上造出的"半可靠"
CoAP 没有 TCP 那种"连接",却靠四类消息把可靠的骨架撑起来:
- CON(可确认):发送方要对方回 ACK;超时未回则重发,直到报错。用于必须确认的操作。
- NON(不可确认):发了就完,不要求应答,适合丢得起的数据。
- ACK(确认):对 CON 的应承;也可顺带携带响应数据(piggyback)。
- RST(拒绝):收到不合要求的消息时回它,表示"这个我不收"。
# 四类消息用途速记 CON → 必须回 ACK, 超时重传 # 可靠通道 NON → 无需应答 # 高速/可丢 ACK → 应承 CON, 可捎带响应 # 回执 RST → 拒收, 协议处理不了
Code:方法还是响应码
第二字节用"类.细节"编码:请求时它是方法(0.01 GET、0.02 POST、0.03 PUT、0.04 DELETE),响应时它是状态(2.01 Created、2.04 Changed、2.05 Content、4.04 Not Found、4.05 Method Not Allowed、5.00 Internal Server Error)。高 3 位是"类"(2 表示成功、4 表示客户端错误、5 表示服务端错误),低 5 位是细节。这种紧凑表示让常用状态一字节搞定,省下的空间留给载荷。
Token 与 Message ID,别搞混
这是 CoAP 新手最绕的点。两个标识各有分工:
- Message ID:位于固定头,用于消息级去重与 ACK 匹配(能唯一标识"这一次传输")。它对应网络层。
- Token:随请求由客户端选、响应原样带回,用于请求-响应语义对齐(能唯一标识"这笔事务")。它对应应用逻辑层。
一句话:Message ID 管"这一帧别重复",Token 管"这笔业务回应的是哪次"。
| 标识 | 位置 | 职责 | 谁生成 |
|---|---|---|---|
| Message ID | 固定头 16 位 | 去重、ACK 匹配 | 发送方生成 |
| Token | 头后 TKL 字节 | 匹配响应与请求 | 客户端生成 |
头部字段比特级过一次
把图中那 4 字节拆到比特级,逐一记账(供抓包对照,不必死记):
- Ver(2 位):版本,当前为 1。
- Type(2 位):消息类型,即上文的 CON/NON/ACK/RST。
- TKL(4 位):Token 长度(0~8 字节),告诉接收方"随后的头还有几个 Token 字节"。
- Code(8 位):请求方法或响应码(下详)。
- Message ID(16 位):帧级标识。
看到 TKL 你就能理解"头可长可短":无 Token 时 TKL=0,报文即刻瘦成 4 字节;要区分并发事务时带上 Token,头部随之加长。读懂这 4 字节,等于拿到了解读所有 CoAP 交互的钥匙。
选项与载荷:报文剩余的部分
固定头 + Token 只是前半场,后半场是选项(Options)与载荷(Payload)。选项用"编号 + 长度 + 值"紧凑编码,常见的有 Uri-Path(资源路径)、Content-Format(载荷格式)、Max-Age(缓存时长)、Observe(观察开关)等。载荷则跟在一个值为 0xFF 的载荷标记之后。用一次 GET 拆包示意它的完整构成:
固定头 + Token 选项 Ver=1 Type=CON ... MID=200 | Uri-Path:/temperature | 0xFF | 25.6 # ^固定头 ^资源路径选项 ^载荷标记 ^载荷
一次"读温度"的请求,在线上往往就这十几个字节——比 HTTP 动辄上百字节的头部省出太多,这正是受限节点能用它活下去的经济基础。
一次重发的 CON,怎么用 Message ID 去重
澄清 Message ID 去重的关键场景:客户端发 CON 后超时没等到 ACK,于是重发同样的请求。此时它复用同一个 Message ID,服务器靠这个"见过"的 MID 立即丢弃重复、不重复处理。对比之下,Token 保持一致则保证"哪怕换了 MID,客户端也知道这是对上次那笔事务的回应"。所以 Message ID 与 Token 一管"帧重复"、一管"业务配对",缺一不可。
一种直观记忆:Message ID 是"这封信的密码",保证同一封信不会被拆两次;Token 是"这笔生意的回执号",保证回执物归原主。 两者配合,UDP 上也能做到既去重又配对。
用一次 CON + 响应看懂字段配合
客户端读一次温度,虚线是它要走的字段路线:
客户端 → CoAP 服务器: GET Code=0.01 MID=1234 Token=A7 (CON) 服务器 → 客户端: 2.05 MID=1235 Token=A7 Payload=25.6 (ACK, 中文Token对齐) # MID 变了(回应新帧), Token 不变(仍是A7) —— 所以响应认得是"读温度"这笔
本节要点回顾
- 要点一:CoAP 固定头 4 字节,含 Ver/Type/TKL/Code/Message ID 五个信息面。
- 要点二:四类消息 CON/NON/ACK/RST 在无连接 UDP 上撑起半可靠通道。
- 要点三:Code 一字节双用——请求当方法、响应当状态码。
- 要点四:Message ID 管帧级去重与 ACK 匹配,Token 管事务级响应对齐。
- 要点五:Token 由客户端定并在响应中原样带回,是请求响应配对的钥匙。
字段认识了,4.3 把那四个方法(GET/POST/PUT/DELETE)和更上层的 Observe 观察机制串起来。