8.1 边缘计算与算力下沉
8.1 边缘计算与算力下沉
本节摘要:云端的算力不一定最快,因为数据过去有往返时延。本节讲清"算力下沉"是怎么回事——边缘计算、雾计算、云计算三层各管一块,再对比"数据上云处理"与"就地处理"两种路线,最后落到你该怎么选择算力落点。承接第 7 章安全基础设施,通往 8.2 的智能与互操作。
前面的章节默认"数据往上送、云端来算"。但现实里这条路不一定是最优解:一个工厂的产线设备,告警要毫秒级响应,把数据绕到云端再传回来,一来一回就慢了。物联网演进的第一大动作,就是把算力从云端往下挪,挪到离数据近的地方。
云、雾、边缘:三层算力各有各的主场
算力下沉不是"一刀切全下放",而是沿"云端→雾→边缘"分成三层,各自承接不同节奏的任务:
| 层级 | 位置 | 典型时延 | 干什么合适 |
|---|---|---|---|
| 云计算 | 中心机房 | 百毫秒级 | 全局汇聚、训练、大数据存储 |
| 雾计算 | 网络中间(网关/汇聚) | 几十毫秒级 | 局部汇聚、规则过滤、低时延决策 |
| 边缘计算 | 设备旁 / 本地网关 | 毫秒级 | 即时响应、断网自治、隐私保护 |
💡 关键直觉:地图越大、离数据越远,能想得越全但响应越慢;地图越小、离数据越近,反应越快但只能管住眼前一小块。算力下沉就是在这两种能力之间找平衡。
上云 vs 就地:两条路线怎么剪
同一件事,放云端还是放边缘,各有取舍,用一张对比看清楚:
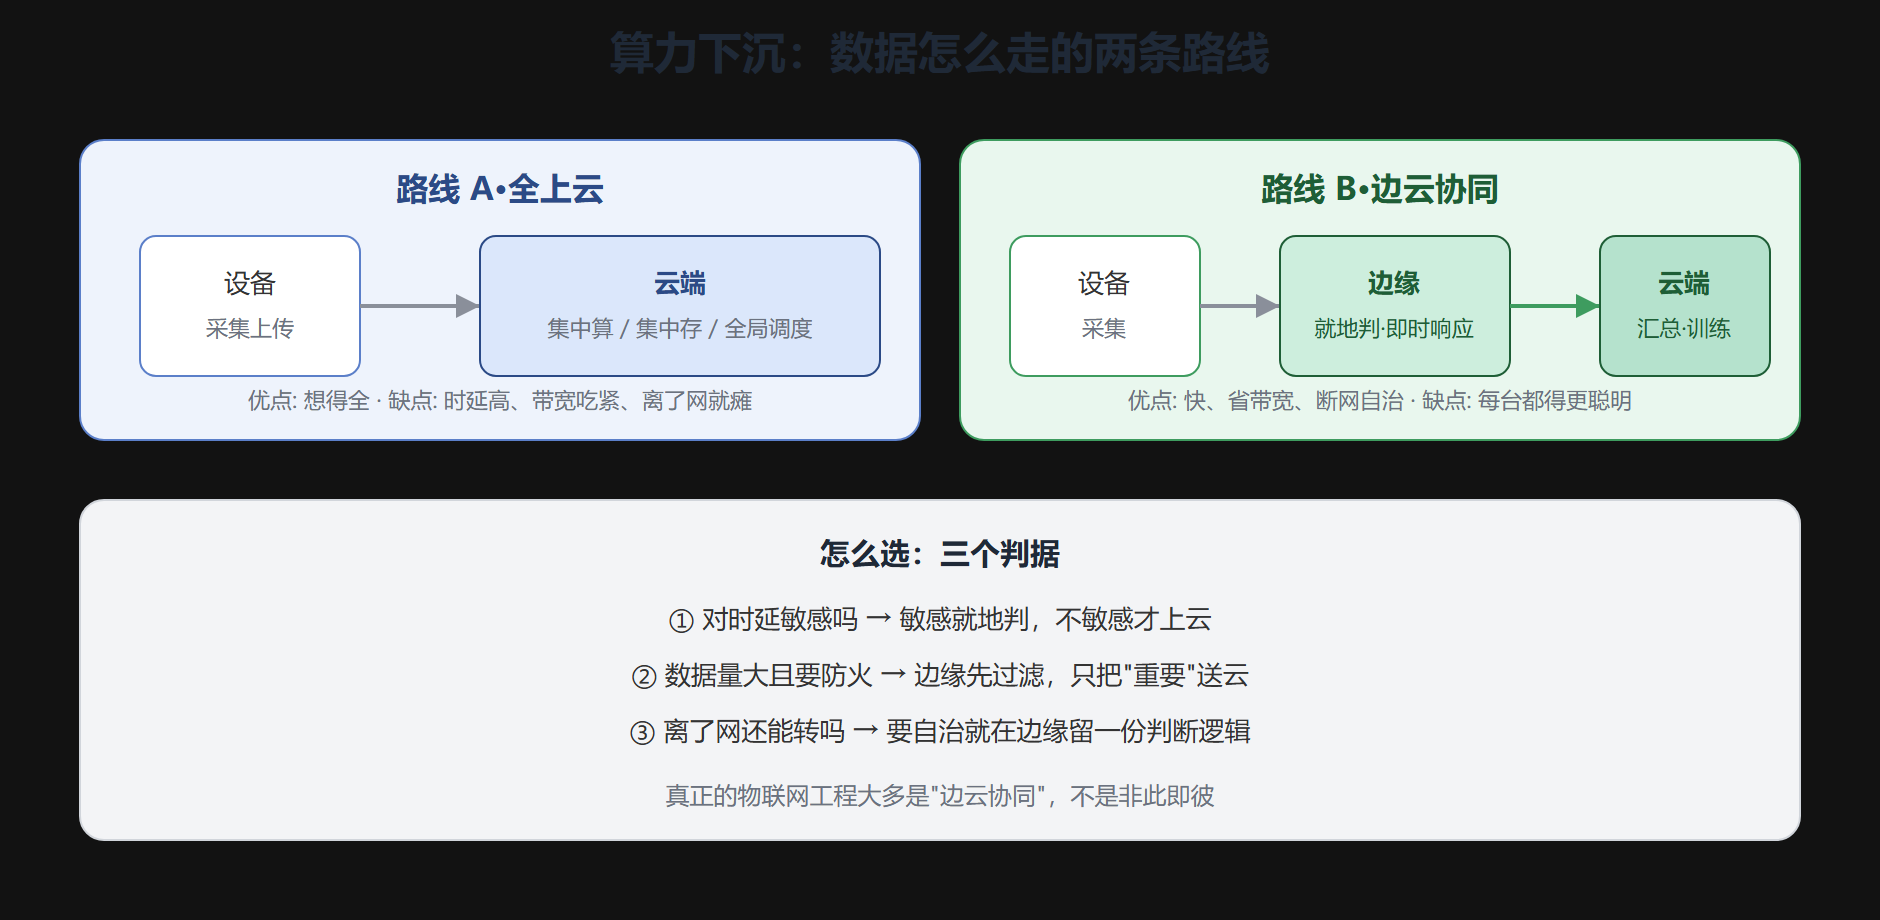
三个判据,决定一件"事"放几层
前面说三层算力各管一段,但具体一件业务该放哪一层,用三个判据就能落定:
- 时延要求:毫秒级(产线安全联锁)→ 必须边缘;可容忍秒级 → 可上雾/云。
- 数据量:海量高频原始数据全上云又贵又慢 → 边缘先做过滤/降采样,只上结果或摘要。
- 断网自治:随时可能断网的野外 → 边缘必须能独立决策;长期在线 → 可更依赖云端。
把这三条对一件具体业务逐条打分,多半能在"云、雾、边"里找到落点。最典型的是"异常检测":监测告警不能等往返,放边缘实时判;而模型的"全局校准"和"长期统计"仍回云端做——正是边云协同的分工样板。
一个产线例子的落位
用一个常见设备故障预警走一遍落位,把抽象讲实:某工厂的振动传感检测到异常。
- 若坚持全上云:传感数据经 MQTT 送云,模型在云端判异常、再回传告警,往返至少百毫秒。产线某台车床要在几十毫秒内紧急停机,等不起这一个来回。
- 若放边缘:本地网关或机床控制器内置一个轻量模型,在设备旁即时判出"振动超标、建议停机"并立刻联动停机;同时把"这段异常波形 + 摘要"异步上云,供云端大数据进一步做预防性维护分析。
对比可见:"即时响应"交给边缘,"全局学习"留给云端。这也是 8.1 最常被引用的一个道理——边缘不是代替云,而是接住云来不及管的那部分。
下沉之后,安全结构跟着换位
算力一往下沉,第 7 章的防线也要跟着调整:边缘节点会持有更多密钥、做更多就地决策,它自己就成了一个"可信边界"。因此:
- 边缘要能独立验证:即使断云,边缘本地也要有设备身份与校验能力,不能一离云就全裸奔。
- 边云之间仍要加密:下沉的是算力,不是信任——边缘传给云的数据仍走 TLS/DTLS。
- 密钥分级跟层级走:边缘用本地会话钥处理就近数据,根/签发级密钥仍留在更可靠的云端保管。
⚠️ 常见坑:把算力下沉误当成"安全也下沉",结果边缘节点既没加密也没密钥保护,反而成了新的单点。下沉算力的同时,必须把防线的边界画清楚。
边缘对协议提出了哪些新的"本地诉求"
算力虽然下沉,协议依然是连接设备的那条血脉,只是新增了几条本地诉求。其一,边缘要有"离线可用"的缓冲——断云时边缘本地要能继续收数据、做决策,不能因为云端连不上就整个趴窝,这要求边缘端有一套本地队列与本地模型兜底。其二,往返不再是唯一靠山——很多判断在边缘就地出结果,上行只送摘要与异常,那么链路带宽、占空比、电量都被显著收窄,第 2 到第 5 章的"省电与省流"考量在边缘架构里反而更值钱。其三,边缘同样要有协议安全——边缘节点持本地会话钥、走 TLS/DTLS 与云互通,正是第 7 章纵深防线在"边"这一环的延伸。看懂这三条"本地诉求",就能明白为什么说"算力下沉不是把云端搬到这,而是协议、数据、安全在边缘共同换了一张脸"。
一张三层算力放哪的速查表
把抽象的三层字样收成一张能对着业务快速落位的速查表:
| 业务类型 | 建议落点 | 靠哪条判据 |
|---|---|---|
| 产线安全联锁、实时告警 | 边缘 | 时延毫秒级 |
| 局部接入过滤、区域规则 | 雾/网关 | 数据量 + 低时延 |
| 全局训练、历史统计、报表 | 云 | 要全量、可容忍秒级 |
| 野外断网设备 | 边缘优先 | 断网自治 |
这张表只是把三个判据落到常见类型上,并不取代逐条打分——遇到新业务,仍是把那三问"时延、数据量、断网自治"再走一遍更稳。
边缘不是云端的缩写版,而是目的不同的另一层
最容易犯的误解是把边缘当成"放在现场的缩小版云端",于是把云端那套重依赖、大而全的组件照搬过来,结果边缘常常带不动。边缘的任务本质是"在断连、低算力、省带宽的前提下,把最急的事办掉"——它像是哨兵,只看眼前这一小片、只做该做的判断,把该传给后方的摘要递上去就行,而不是非要拖一整套云端全家桶。理解这层"分工而非降级"的定位,才不会被"边缘怎么不如云端全"这样的伪问题带偏。
怎么向项目学这套取舍
判断一家物联网方案是否跟上演进,可以问三条:
- 急的事能不能就地办?(边缘自治)
- 方向性决策是不是汇总到云端?(全局协同)
- 下沉的算力有没有同步配安全?(边界清晰)
三条都回答得合理,说明这套云边端架构是真的设计过,而不是字面上堆了"边缘"二字。
本节要点回顾
- 要点一:算力分云、雾、边三层,越近数据反应越快、但管得越局部。
- 要点二:上云重"全局全",边缘重"快和自治";真工程通常是边云协同。
- 要点三:三个判据——时延、数据量、断网自治,决定算力落点。
- 要点四:算力下沉要同步重画安全边界,边缘也是可信边界而非裸奔区。
- 要点五:密钥分级随层级走,根钥留云端,边缘只持就近会话钥。
回到大主题,算力挪下来了,数据就有望被喂给更聪明的系统——8.2 看 AI、数字孪生与互操作怎么把这些数据变成决策与镜像。