2.1 扩散过程与马尔可夫链
2.1 扩散过程与马尔可夫链
前向扩散逐步向图像掺入高斯噪声,直到图像完全变成随机噪声,且每一步只依赖上一步的状态,构成一条马尔可夫链。本节给出加噪递推式与噪声调度曲线,解释调度参数怎样控制"多快把画稿泡没"。
这一节只做半件事:把"加噪"这半程讲透。很多人读扩散原理卡住,卡法高度一致——他们想一口气同时吃掉加噪与去噪,结果一半人先被公式劝退。我的建议是反过来,先只盯加噪,把它当作一道纯粹的"破坏性工序"来理解:你有张干净画稿,现在按节奏往上面洒墨、加颗粒,直到它面目全非。至于怎么捞回来,那是下一节的事。搞懂"破坏"这道工序,等于给"恢复"那道工序铺好了对称的地基——破坏是均匀的、可记录的,恢复才有迹可循。
前向过程的递推招式
设清晰图像为 x0。前向过程想构造一批越来越糊的中间态 x1, x2, ..., xT。最简单也最常用的构造方式,是在每一步按固定比例把上一状态往标准噪声方向推一点,写成递推式:
x_{t} = sqrt(1 - beta_t) * x_{t-1} + sqrt(beta_t) * eps_t
其中 beta_t 是一个随步数变化的调度参数,eps_t 是标准正态噪声。注意两个系数:sqrt(1 - beta_t) 负责把上一状态的"信号"略为衰减,sqrt(beta_t) 负责注入"噪声分量"。beta_t 越大,这一步往里灌的噪声越多、信号被压得越狠。调度一般取递增,比如线性从 0.0001 升到 0.02,也就是越到后面,越是在已糊的画稿上继续糊。当 t 足够大(比如 1000 步),信号衰减到接近零,x_T 就几乎只剩噪声。
这串递推最漂亮的性质,是它"只看前一步"——当前状态 x_t 由 x_{t-1} 和一个随机噪声决定,不依赖更早的历史。这正是一个马尔可夫过程。换句话说,噪声怎么糊成的这盘账,只跟它的上一版有关,左边整段历史都可以不管。这个性质让前向过程极其简单可控,也让训练时能"跳步"采样本(下面会看到)。
噪声调度曲线长什么样
为了直观感受"多快泡没",把调度画成曲线最清楚:
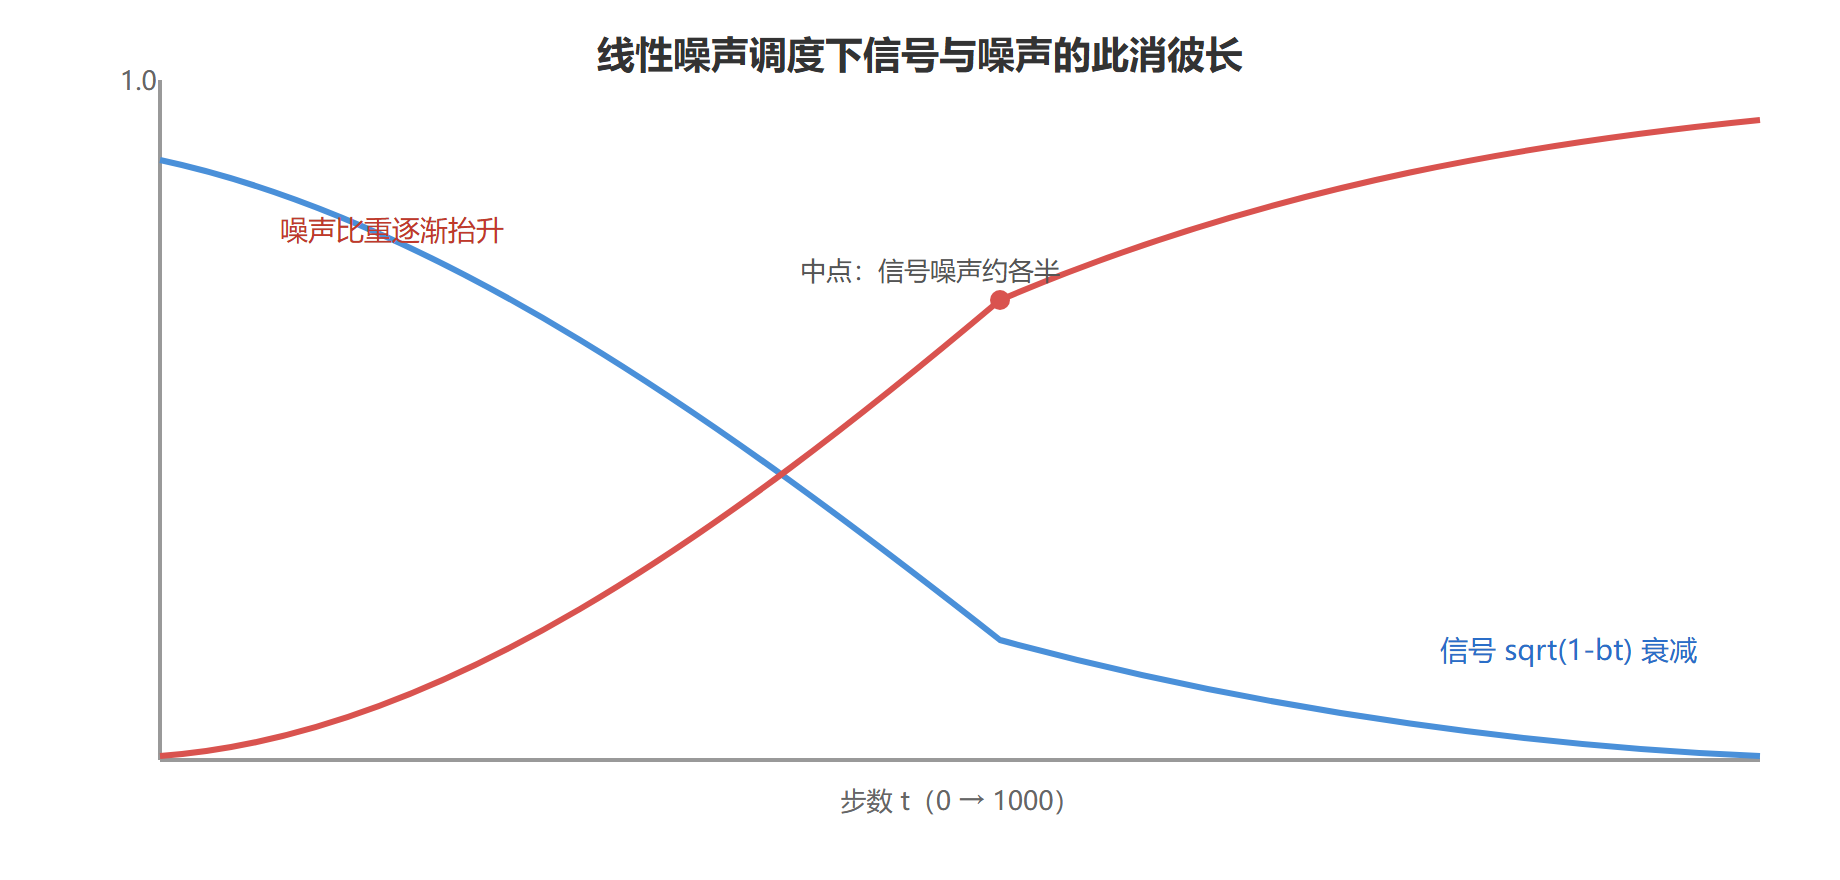
图标题:线性噪声调度的信号与噪声曲线
红色曲线代表注入噪声的权重,随步数走高;蓝色曲线代表保留信号的权重,随步数衰减。两条线在约中段交错——这意味着调度设计得越"缓",画稿支撑得越久;升得越陡,泡得越快。第三章谈一致性模型时的"时间步信息",就跟这条曲线的形状(方根、余弦等)直接挂钩,不同形状决定模型感知"现在糊到什么程度"的依据。
训练为何要"跳步"
到这里有个聪明的地方:因为递推只看前一步,我们可以只用一个公式把任意 x_t 直接从 x0 算出来,而不必真的从 x0 一步一步加噪到 x_t。也就是给定 x0 和总的累计噪声,x_t 有个闭式表达式。这意味着训练时不必生成整条链,只需随机抽一步 t、按闭式算出一个"半糊"样本,就能当合法输入喂给网络去学"怎么在这步去噪"。这一步不要小看:它把训练成本从"必须整条链仿真"降成"抽一步就算",是扩散能被广泛训练的前提。它的本质,就是吃了马尔可夫"只看前一步"的便宜。
一个很容易翻车的认知点是:调度参数 beta_t 是事先定死的"艺术决定",不是训练得出来的。它决定把画稿泡多快、泡多均匀,你换调度等于换一种"破坏节奏";后面一致性模型甚至直接改变这条曲线的形状来换取更少步数。
一张手算的"泡墨"样例
为了把公式落到纸面,我们做一个极简的数值演练。设画稿的某一点亮度信号为 x0 = 1.0,选择 beta_t = 0.9,则 sqrt(1 - beta_t) ≈ 0.316,sqrt(beta_t) ≈ 0.949。代入递推式:
| 符号 | 含义 | 本例取值 |
|---|---|---|
| sqrt(1 − beta) | 保留上一状态的信号比例 | ≈ 0.316 |
| sqrt(beta) | 注入噪声的比例 | ≈ 0.949 |
| eps | 标准正态噪声 | 假设取 +0.5 |
| 结果 x1 | 0.316×1.0 + 0.949×0.5 | ≈ 0.79 |
对比一下:若把 beta 降到 0.1,sqrt(1−beta) ≈ 0.949、sqrt(beta) ≈ 0.316,同样喂 1.0 和 0.5,结果 ≈ 1.11,信号几乎被原样保留,只掺了一点点噪声。这就是"高 beta 泡得快、低 beta 泡得慢"的直观来源。工程里因此会把调度设计成"前面几大步衰减快、越靠近纯噪声步越细",让中间态分布得足够细腻,才好让逆向网络有平滑的路径可以学。
调度形状的三个可选代表
要是以为调度曲线只有一条直线,那你会错过一大半的"手感"。实践中常见的是三条家族——线性(beta 随步数均匀递增)、余弦、方根式。它们的差异集中在中间段"泡墨"的快慢:余弦曲线在中段明显更平缓,意味着模型在信息还多的那一段能分出更多分辨率去学细节,因此如今不少实现用余弦替换线性,换取整体采样质量的稳定;方根式则把高噪声端拉得更满,直接服务于"更少步数也保得住结构"的一致性模型。读懂这个差异,你就明白为什么同一次模型、只换一个调度文件,成图的观感都会不同——你实际换的是"把画稿泡到纯噪声的分寸感",而这分寸感恰恰决定了逆向网络每一步能学到的信号密度。
为什么"只看前一步"这么值钱
把马尔可夫性再放大一点:它不是数学上的漂亮标签,而是整个模型能被工程化的杠杆。因为它只看前一步,前向链可以被折叠成一个闭式采样式;也因为它只看前一步,采样加速(第二章后半)可以设计"不那么死板地走满每一步"的等距稀疏路径。可以说,扩散之后那些又粗又快的高级采样器,全部建立在"前向本来就不必一格一格实地走"这个直觉之上。看懂它,你读 2.4 节的 DDIM 会轻松很多。
⚠️ 常见坑:把 beta 当作可学习参数——它是一份固定超参,参与定义前向过程,而不参与反向网络参数的优化。
💡 关键直觉:前向过程其实是"照本宣科地破坏",真正有学习负担的是下一节的逆向;先让破坏服服帖帖,恢复才有章法可循。
本节要点回顾
- 前向递推式:当前态由上一态按 sqrt(1-bt) 衰减信号、sqrt(bt) 加噪声构成。
- 马尔可夫性:当前状态只看前一步,是跳步采样与闭式计算的前提。
- 调度曲线:beta 随步数递增,信号衰减与噪声抬升在曲线中段交汇。
- 闭式一步到位:指定 x0 可直接算出任意 x_t,训练时才做得到逐批采样。
- 与后续接口:曲线形状影响时间步编码,也奠定第三章一致性模型改变曲线形状以压缩步数的依据。
下一节接棒:我们把"破坏"翻过来,看逆向过程如何用一个神经网络一步步把噪点擦净。