5.3 个性化与微调
5.3 个性化与微调
想让模型记住"我那只黑白猫"或"我公司的 logo 风格",纯粹靠提示词不够用。个性化微调(LoRA、DreamBooth 等)通过少量样本注册一个专属概念,让模型以后能稳定把它约出来。本节对比提示词与微调,讲清 LoRA 的低秩增量原理与微调边界。
你大概也遇到过这种挫败:提示词写一万遍"这只是英短银渐层、胸口一片白",模型的猫总差一口气——不是品种不对,就是花纹凭空乱跳。原因很朴素:它训练时见过的猫太多,却从没见过"你这一只"。要让扩散模型真正记住一个具体的眼角、一道花纹、一个 logo,就得给它"补一堂关于你的小课"。这就是本节要说的个性化与微调。它会让你从一个只用提示词的"使唤模型的人",升级成能自己长按某个概念的"掌控模型的人"。
为什么提示词有时救不了你
提示词很强,但有天花板。它受限于既有词汇与训练数据的"命名空间":叫"银渐层"可以,但你说不出"我家那只右耳缺一小口的",因为它没有对应语义内置。要注册这类"训练时没见过"的具体概念,只能靠微调补课。而且,即便语义能描述的东西(如公司 logo 的配色),靠提示词它也不会一天借你十万次不出错——因为每次都是靠概率赌运气。微调则是把"这个概念"焊进模型参数里,让它在未来各出图里稳定可复现。
LoRA:给大模型"贴一张便利贴"
直接对整个底座模型做全量微调成本高、易灾难性遗忘。LoRA(Low-Rank Adaptation)提供了一个优雅的中间档:它不重训所有权重,而是给关键层的权重矩阵加一撮"低秩增量"——一个由低秩矩阵相乘构成的小补丁。训练时只更新这个小补丁,底座权重保持不动。效果是:用一张复合卡大小的参数量,就可以把对于一个角色/风格"长驻"进模型,随时装上拆下,还不污染底座在其他领域的表现。
来个直觉类比:底座模型是一部庞大的百科,LoRA 是在某几页上贴了几张便利贴,既有新记忆又不改动原书内容。对这个技巧的精准确认,来自它是当下"喂少量素材 + 长驻一个角色"性价比最高的方式,也是很多产品自定义形象的底层技术。
把"便利贴"这句话落成一张图——未必动全书、只在个别权重层加增量:
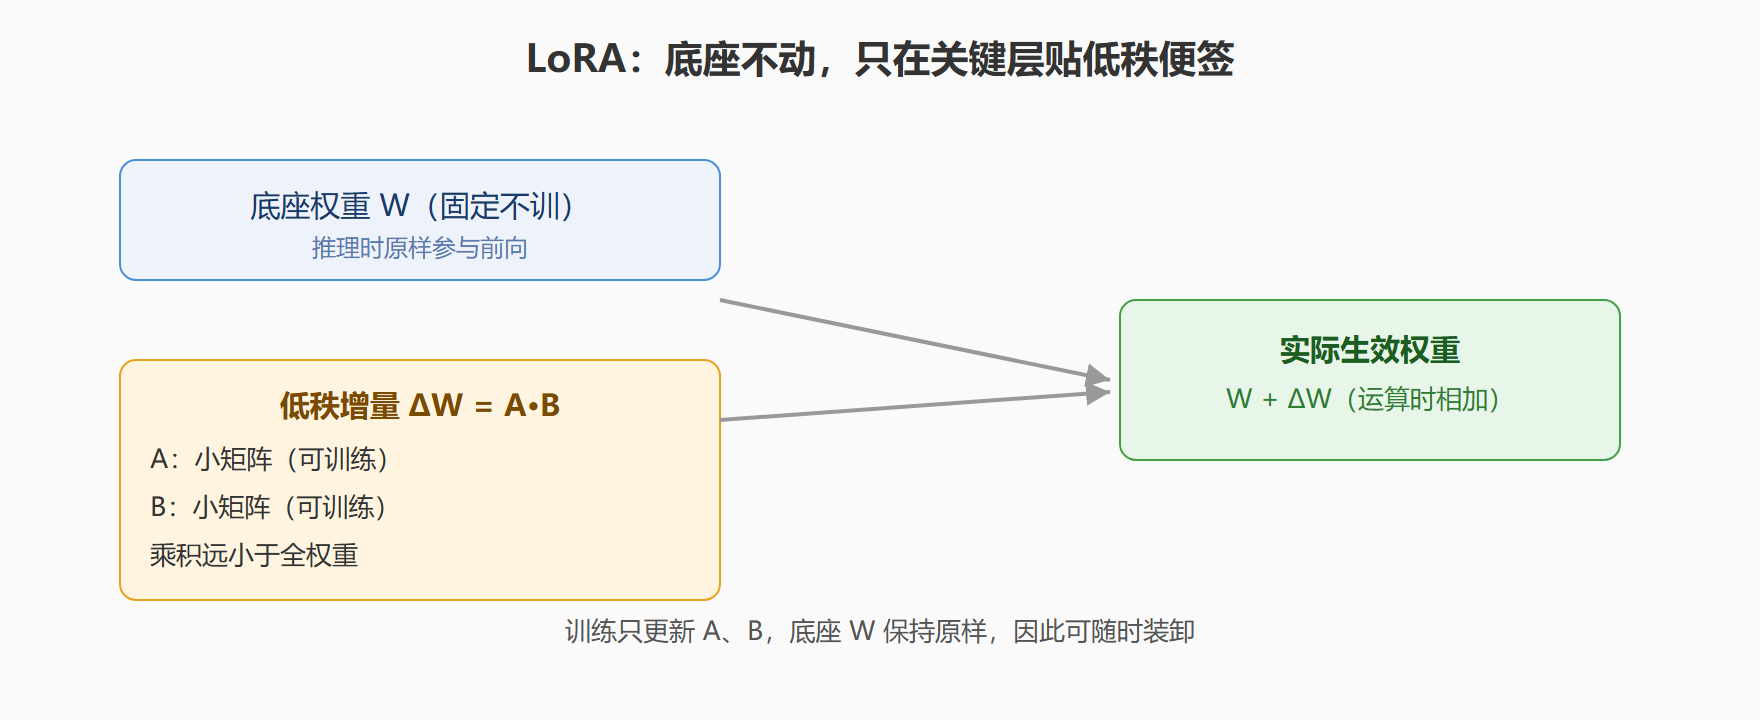
图 5-3:LoRA 的低秩便签
这张图的核心一句话:训练时只动 ΔW(也就是 A、B 两个小矩阵),底座 W 永远不变。于是你既能享受"贴了便签的定制版",又能随时拆下便签回到通用模型,完美绕开全量微调的两宗罪——贵与灾难性遗忘。
把"全量微调 vs LoRA vs 纯提示词"放一张纸上比:
| 方案 | 改动范围 | 需要素材 | 训练成本 | 风险 |
|---|---|---|---|---|
| 纯提示词 | 无训练 | 0 | 无 | 不够贴切、随机 |
| LoRA | 低秩增量 | 少量(十几张) | 低 | 需挑触发词 |
| 全量微调 | 整底座 | 较大 | 高 | 灾难性遗忘 |
素材质量的隐藏等高线
谈到微调,素材质量才是那条经常被忽略的"隐藏等高线"。几十张三心二意、风格杂乱的图,效果往往不如五六张干净一致、主体居中、背景统一的好图。光线一致、主体姿态多样的样例集,能让 LoRA 学到的"概念"更纯粹、不易混入背景。素材里如果混进了半张其他东西,模型就会在训出来之后莫名其妙地把那半张也当作"这个角色的一部分"。
同时要配一个触发词(trigger word),一个特别字母组合(避免与常见词撞车),调用时只要在提示词里带上它,就能把这个概念"叫醒"。选好触发词、素材纯净、denoise 适度,是微调成功的三件套。
素材的文字标注(caption)同样决定训练方向:每张样例附的说明词,既负责把"这是角色本体"的信息喂给模型,也负责隐式告诉它"遮挡、光线、姿态"这些非概念信息别学进去。caption 写得越准、越克制,LoRA 学到的就越纯粹;反之,一张写着"把猫放在沙发上"的素材,可能连沙发也一并被当成了这个角色的一部分。素材与标注从来不是可选项,而是微调真正的成败面。
一个角色不够用:怎么"叠 LoRA"
做个性化到后期,你手里往往不止一张"便签"——一个角色、一种画风、一套制服各一个 LoRA。把它们叠加是常见需求:把多个 LoRA 一起加载,各按一个权重比例混合,就能让"穿着这套制服的我的角色"同时成立。叠加看似简单,实际的坑却很具体:一是权重打架——两个 LoRA 都想抢同一个方向的表征时,结果会偏向其中一方甚至互相抵消,通常做法是逐个调低冲突项的权重;二是顺序与版本——不同底座研制的 LoRA 混搭前,先确认它们都匹配同一底座,否则会出现风格与主体双双漂移;三是别贪多——叠的位数越多,可控性越差,一般推荐从一个角色 + 一种风格开始,跑通后再增量往上加。记住这个心法:LoRA 是"可装卸的零件",但零件装多了,机器也就更难摸清是你还是它在说话。
版本与生态的兼容成本
微调还有个常被低估的隐性成本——"锁版本"。一个训练好的 LoRA,通常只对训练它的那个底座版本最稳:换一个底座版本,皮肤、风格甚至主体识别都可能漂移,用户最怕的主体会"变样"。所以个人化生产总会尽量坚持一套固定的底座与配套版本,而不是频繁升级。同理,若你打算让 LoRA 与 ControlNet 等其它插件协同,还要确认它们与这个底座的兼容情况,否则叠加起来行为会不可预期。一句话:LoRA 让你贴了便签,但也意味着你要为这本"书"长期不换版负点责任。
什么时候不该微调
反过来说也有明确的不该微调场景。想临时改一次某个细节——用提示词与局域掩码就够了,不值得付出微调做一张便利贴。素材不足或杂乱——硬调只会污染底座。以及,你希望结果完全可复现、无缝融入当前模型生态(比如还要配 ControlNet)时,也要考虑狭义的 LoRA 与特定版本匹配问题。判断准则就一条:这个"概念"我接下来还要反复用吗?要,就微调;只在这一次,就用提示词。
⚠️ 常见坑:素材太少又太杂,微调出来的角色会"无中生有"配出不属于它的像素;先整理素材、再动手微调。
💡 关键直觉:LoRA 是"贴便签"而非"重写书",边界清晰、增量可控,是个人化最稳的落点。
本节要点回顾
- 提示词天花板:训练时没见过的具体概念,语义无解,只能补课。
- LoRA 原理:低秩增量贴便签,只更新小补丁、不污染底座。
- 素材质量优先:少而精、构图统一、主体纯,比多而杂更可靠。
- 触发词:特殊字母组合,负责在下次调用时把这个概念"叫醒"。
- 微调边界:反复要用的概念才值得微调;一次性需求走提示词。
从"怎么让模型记住你的猫"谈到怎么大规模地"控制到底要怎么画"——下一章进入控制增强,ControlNet 把姿态、边缘、深度接进扩散,真正握稳方向盘。