9.1 开源框架与主流模型
9.1 开源框架与主流模型
Diffusers 是当前最主流的开源扩散框架,以"加载模型-调 pipeline-出图"三步上手;Stable Diffusion、DALL-E、Midjourney 三家按开源可控 / 文本跟随 / 画感优先各有分工。本节讲清框架用法与三模型的选型差异。
一切原理到了"我想自己跑通一张图"这一步,都要回答两个问题:用哪个框架写、用哪个模型画。这一节就把这两问一次说清。第一个答案几乎不用争:Diffusers 是主流开源选项,生态最全、从加载到出图只要三步;第二个问题要看胃口:不同模型对你的场景适配差别很大,搞清楚三家脾气,你才不会浪费时间在不对路的模型上硬磨。
Diffusers 三步上路
Diffusers 最基本的玩法,是从模型仓库加载一个预训练扩散管道(pipeline),然后喂进提示词就得到图。它的抽象做得很贴心——把"文本编码、去噪网络、调度、解码"整套链路封装成一个对象,你只要对四个部件有印象:从模型仓库取一个 stable-diffusion 系列的管道;明确几步去噪(调度步数);给一个提示词与空提示(供 CFG 用);调一下种子与 cfg 拿到确定可复现的结果。
from diffusers import StableDiffusionPipeline pipeline = StableDiffusionPipeline.from_pretrained("sd15-family-checkpoint") prompt = "一只戴小帽的橘猫,午后窗边,写实摄影" image = pipeline(prompt, num_inference_steps=30, guidance_scale=7.5, seed=1).images[0]
这份极简代码没空演任何魔法,你稍加查文档就会往里面加:不同的 scheduler(把 DDIM/DPM 换上去跑不同加速策略)、不同的组件(换更强的文本编码器)、image2image 接口(喂输入图 + denoise)。也就是说从跑通一张,到换成你要的采样器与条件,都在这浅三层里。
三大家模型彼此的分工
- Stable Diffusion(SD):开源可控是它的镇牌之宝。你拥有全部权重,可本地跑、可任意微调、可挂 ControlNet/LoRA,社区的丰富插件都是冲它来的开源自由度。代价是默认画感偏"中性",精细风格往往要靠微调与提示词打磨。
- DALL-E:它的强项是文本跟随——对"描述里的物与空间关系"理解更主动,省去很多把想说的翻译成"模型行话"的功夫。它是闭源的,你在它能给的范围外用得很爽,但想改内核就没门了。
- Midjourney:主打"画感优先"。它不免费开源,但生成结果常有更高的美学完成度与氛围感,特别适合要"好看、氛围感"的作品、封面与概念图。代价是可控性相对更靠提示词与它的外部命令体系,换内部结构也轮不到你。
| 模型 | 灵魂 | 开放性 | 适用场景 | 短板 |
|---|---|---|---|---|
| Stable Diffusion | 开源可控 | 全开源 | 微调、插件、编辑生态 | 默认画感中性 |
| DALL-E | 文本跟随 | 闭源 API | 想要"我描述它就画" | 改内核难 |
| Midjourney | 画感优先 | 闭源 | 高完成度作品 | 可控性弱 |
选型与上手建议
建议别三选一起来比谁赢,先是按你的任务定:要深度可控与个性化(编辑、微调、结构控制),选 Stable Diffusion;要"我说得够清楚它就好好画"的省力体验,先试 DALL-E 的 API;要追求作品级的氛围与完成度,Midjourney 更合适。多数工程师的第一站是 SD——因为它开源、可控、生态大,一旦跑通,你前面学的控制与微调都有地方玩。
易错点与提示
第一,别把"用 API 生成的"和"本地跑通"混为一谈想当然——前者是配好感在走远路,后者才是你研究和微调的基地。第二,一定等弹到的 release 再升级,别追新潮,因为控制网络与模型版本耦合很深,SD 的新版本可能弄坏旧的插件。第三,讲究"可复现",先固定 seed 再做对比,否则每一步改动都像掷骰子。
从单张 demo 到批量化作业
跑通单张只是起点,多数真实场景要的是"批量 + 可控 + 可复现"。成功的进阶通常把 pipeline 参数洗干净:把提示词、负面提示、步数、cfg、种子全部收纳成一组可组合的"配方"(prompt template + seed 策略),同一配方下批量出图、微调误差。此时你能再做几件稳定的事:固定种子复现失败样例方便排查;按不同的 scheduler 横向扫描,挑出又快又稳的那一组;把常用对象封装成函数,避免每条提示词都是一次手写。别小看这个"把偶然性变成确定性"的过程——很多 demo 我跑得通的产品,产出的本质瑕疵往往来自这一层的参数不统一,而不是模型本身。
画一张"从配方到批量出图"的流水线示意图:
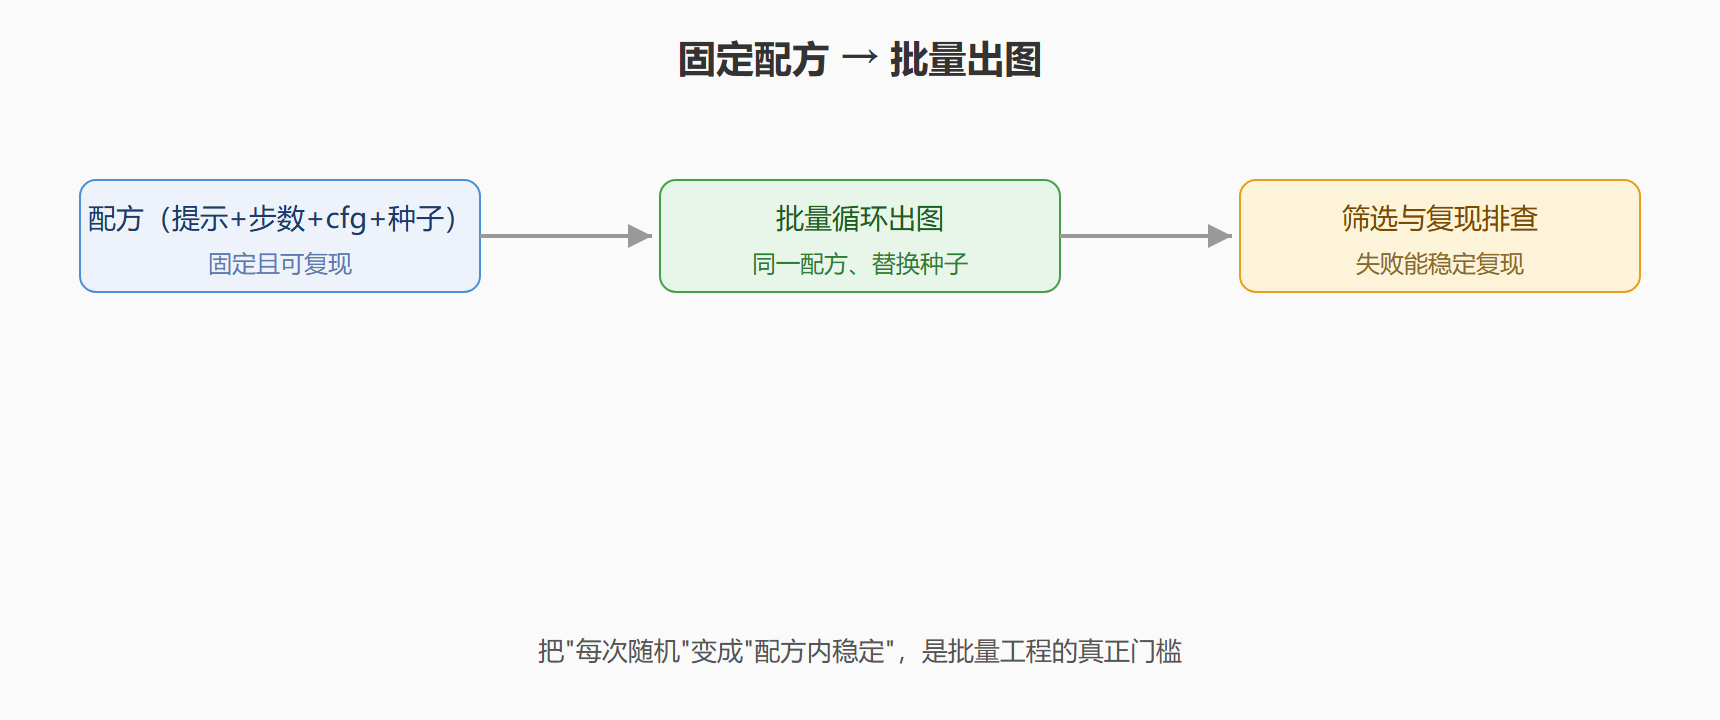
图 9-1:固定配方 → 批量出图
这条流水线提醒你:框架上手不难,难的是让批量结果一致、可排查。把所有随机性统一塞进"种子"这一个变量,其余全部固定,最小的产品级工程就成立了。
⚠️ 常见坑:拿 Midjourney 的高完成度去要求 SD 的默认输出,会误以为"SD 不行"。它们的目标函数不同,选对你的那一种,别拿 A 的强项逼 B。
💡 关键直觉:框架(Diffusers)解决"怎么写、怎么跑",模型(SD/DALL-E/MJ)解决"画成什么样、能不能改"——两者各司其职,先定句要什么再放到并选。
本节要点回顾
- Diffusers 三步:加载管道、给提示词、出图;内部四件套封装成 pipeline。
- SD 开源可控:全开源,适合微调与编辑生态,画感需打磨。
- DALL-E 文本跟随:闭源 API,语义理解主动,改内核受限。
- Midjourney 画感:高完成度氛围,可控性弱。
- 上手建议:多数从 SD 起步,再按任务横向铺开。
框架与模型挑好了,下一个实际问题就是"在哪儿跑"——下一节算本地部署与云平台的账,帮你把钱花在合适的地方。