3.1 脉冲神经网络:尖峰即记录
3.1 脉冲神经网络:尖峰即记录
本节摘要:本节把第 2 章的生物尖峰翻译成一种可训练的网络范式——脉冲神经网络。读完你能画出 SNN 的一次前向流水(输入→膜电位→放电→传出),并说清它与普通神经网络在"账本"上的本质差:离散、稀疏、时间敏感。
前两章铺垫完毕,从这里真正进入"可算的账"。本节在知识地图上是第 3 章的总图——第 3.2 到 3.5 节的所有方程与规则,都挂在"一个脉冲神经网络长什么样"下面。读它前最好重读第 2.1 节神经元的四步记账,因为 SNN 就是把那句"累积-越过-放电-复位"原样搬进不可训练的网络里。
一、SNN 与传统网络的账本差
传统深度网络(CNN/RNN)里,神经元的输出是连续值,这层算完把连续值喂给下一层,每层全量激活、层间全量传输,信息密集但动不动就空转。脉冲神经网络换了一个记账约定:神经元的输出是一次离散的脉冲(尖峰,往往只在越阈的瞬间发),信息靠尖峰的时间与频率承载。 神经元多数时候是"静默的"——不发尖峰就没有输出,也因此成了天然的稀疏、事件驱动网络。
这个差异带来三笔实打实的账:①省能量,静默神经元不耗账,天然契合第 1 章那套"无事不耗"的尺子;②表达能力,尖峰序列比单一连续值多一个时间维度——同一条输入在不同的放电时刻表现不同,天然吃掉时间信息;③代价,离散尖峰让"怎么算梯度"变难,这直接埋到第 3.5 节。
这里值得把"多一个时间维度"再抠细一点,因为它常被误解。普通网络的一个神经元在一次前向里只输出一个标量,信息量是"这个数多大";SNN 的同一神经元在一个推理窗口里可以放多次尖峰,每一发都带"时刻"信息——于是同样一个神经元能表达的,是"它在这一瞬说没说、又说得有多急"。所以严格说,SNN 不是"把连续值打碎成 0/1",而是把表达从静态标量扩展成带时间轴的脉冲串。这个区别决定了训练、编码、硬件三条线都要为"时间"额外做账,也是本教程后面读第 4、5 章时反复要回扣的底层设定。
二、一次前向流水账
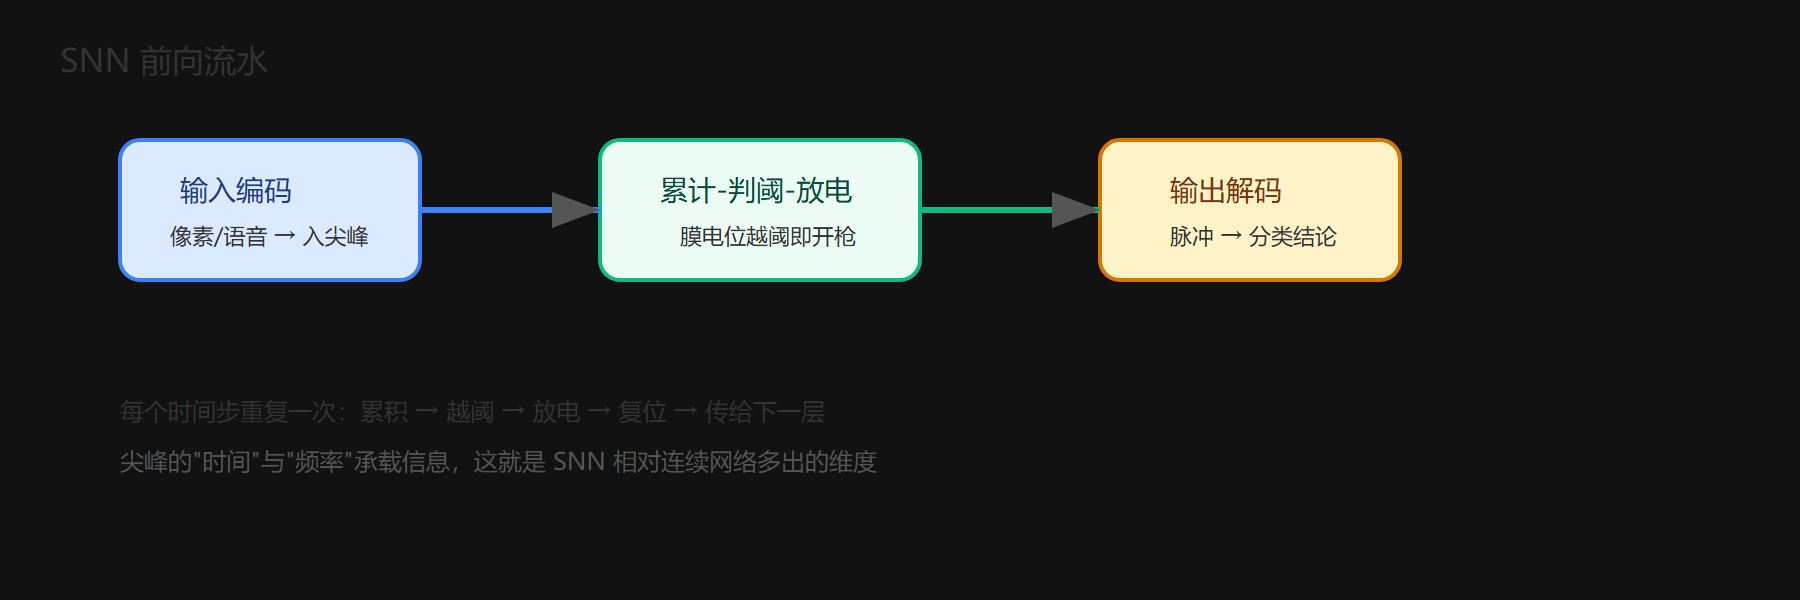
把一次推理摊开成 SNN 的前向流水,每一步都能对回生物动作:
- 输入编码:外部数据(图像像素、语音帧)先被转成一串入尖峰,喂进输入层。
- 膜电位累积:下游神经元把收到的尖峰按突触权重加权累加进自己的膜电位(对应第 2.1 节累积)。
- 越阈放电:膜电位越过阈值即发尖峰(对应越过+放电)。
- 传出与复位:尖峰经突触传给下一层,发出者复位(对应复位与不应期)。
- 输出解码:最后一层的脉冲,按频率或时机解码成分类结论。
三、用代码塞一颗尖峰神经元
概念上用一段最简伪代码,把一个脉冲神经元的"一个时间步"写出来。这不值得看懂每个细节,只需要看到:每个时间步它都在做"累加 + 判阈 + 发不发 + 复位",跟第 2.1 节的四步一一对应:
v = 0.0 # 膜电位,初值复位 threshold = 1.0 leak = 0.1 # 漏电系数(useful: 让电位缓缓回落) for ts in range(T): # 遍历每个时间步 v = v * (1 - leak) + current_in[ts] # 累积输入,同时漏电 if v >= threshold: # 越过阈值? spike[ts] = 1 # 放电:记一笔尖峰 v = 0.0 # 复位归零 else: spike[ts] = 0
读这段时注意三处:v * (1-leak) 是"漏电",让不放尖峰时电位缓缓回落,避免了永远累积;threshold 是可调的判断线;spike[ts]=1 是离散事件本体。这就是后面 LIF 方程(3.2 节)的最朴素形态——加法、判据、事件、复位,四处缺一不可。
四、一张前向流水大图
把上面每一段连起来画成一张 SNN 前向流水图——从输入编码、逐层放电,到输出解码,你能看到尖峰在每一个时间步里是如何"从输入走向结论"的:
五、一笔实打实的省账:多静默,少白烧
把"静默神经元不耗账"落成一笔具体账,你会更服气。假设一层有一万个神经元、输入稀疏,一个时间窗里真正越阈放电的可能只有几百个,其余九成多的神经元在那个瞬间既不累积也不放电。在事件驱动硬件上,这几千个静默神经元几乎不耗电——它们只需要"待着、不动作"。换成传统连续网络,这一层每一格都要做一次乘加并向后传递一个值,同窗口下是"全员上岗",能量照花。
把这层推理放大到一个完整推理链,就能理解 SNN 的省电为什么常被描述成"与输入稀疏度成正比":数据越空闲,省得越狠。反过来,如果输入稠密到每个神经元每个时间步都在越阈(这在视觉上很罕见),SNN 的省电优势会明显收窄,甚至因为离散表达反而更贵——这也是为什么第 6 章反复强调"神经形态挑稀疏、实时的任务",而不是任何计算通吃。省账从来不写在芯片名号上,而写在它面对的那类数据里。
六、实践的直觉
⚠️ 最容易掉坑的点:把 SNN 当成"普通网络再套个量化"。区别不止于输出变成 0/1——SNN 引入时间维度,同一层神经元会跨多个时间步放电,你得决定"跑 T 个时间步、怎么累加一个脉冲贡献"。不处理好时间轴,SNN 不是更省,反而更慢。
💡 关键直觉:把 SNN 想成"一群只在必要时才出声的记账员"。真话在于——它不关心每个神经元时刻都说,而在乎"什么时候谁说了话"。这个"什么时候"就是 SNN 的时间维度,也是它比连续网络多出来的表达自由。
七、把它放回你应该选它的那几格
理解了 SNN 的优势与代价,回到最实用的"该在什么时候用"上。SNN 不是万能算法,它赢的场景画得相当清楚:
- 输入天然带时间:语音、动作、事件流——信息随时间顺序到达的,SNN 能直接把"时间窗"当算法的一部分吃掉,比需要人工拼时序特征的传统模型自然。
- 稀疏是常态而非特例:传感器上报本来就稀稀拉拉、绝大多数时刻"无事发生"。SNN 的事件驱动会在"无事"时报零功耗,这是它和连续网络分道的最优处。
- 端侧、电池、实时、低功耗四者凑齐:机器人、边缘安防、可穿戴这类"没插座、要即刻反应、还得耐耗"的设备,正是 SNN 的账本主场。
反过来,一旦输入是"每帧都满载、又要极高精度"的稠密任务(如静态高清图像、大模型),SNN 的稀疏优势就失效,低精度反而拖后腿——那是连续网络的地盘。把这几格记下来,你在第 6 章读应用时,能一眼判定某个场景该不该用神经形态,而不必等整个教程读完才恍然大悟。
顺带把一个最常见的"伪直觉"拆掉:很多人以为"SNN 的省电 = 把网络做小"。这是误会——SNN 的省电来自'稀疏与事件驱动',而不是来自'网络更小'。 同样是千万参数的网络,SNN 之所以历时更省,是它在每个时间步里有大量神经元静默、只有少数尖峰在走,而连续网络每一层、每一步都在全员满载地做乘加。理解这一点,你才会去关心"输入空不空闲、编码亏不亏",而不是单纯去削网络尺寸来装省电——方向对了,后面读能耗账才读得动。
本节要点回顾
- SNN 输出是离散尖峰,天然稀疏事件驱动,省能量。
- 信息靠时间与频率承载,天然多吃时间信息,代价是离散不可导。
- 一次前向流水:输入编码→膜电位累积→越阈放电→传出复位→输出解码。
- 最小实现四要素:累加、判据、事件、复位。