3.3 神经编码与解码:速率与时间戳
3.3 神经编码与解码:速率与时间戳
本节摘要:本节回答"尖峰怎么携带信息"——介绍速率编码的简单稳健与时间戳编码的省尖峰,以及解码侧怎么把脉冲变成结论。读完你能为一类数据选对编码方案,并说出背景活动与脉冲计数取舍。
上一节你把单个神经元写进了方程,本节问更高一层的问题:这一串尖峰到底"算什么"。编码是 SNN 的进出口——它决定外部世界(像素、声音)进来变成什么脉冲,也决定芯片吐出的脉冲能怎么读回结论。本节在全册的位置接 LIF 方程,给第 3.4(学习)与第 4/5 章的硬件与部署提供"信号长什么样"的设定。
一、两种主流编码的账
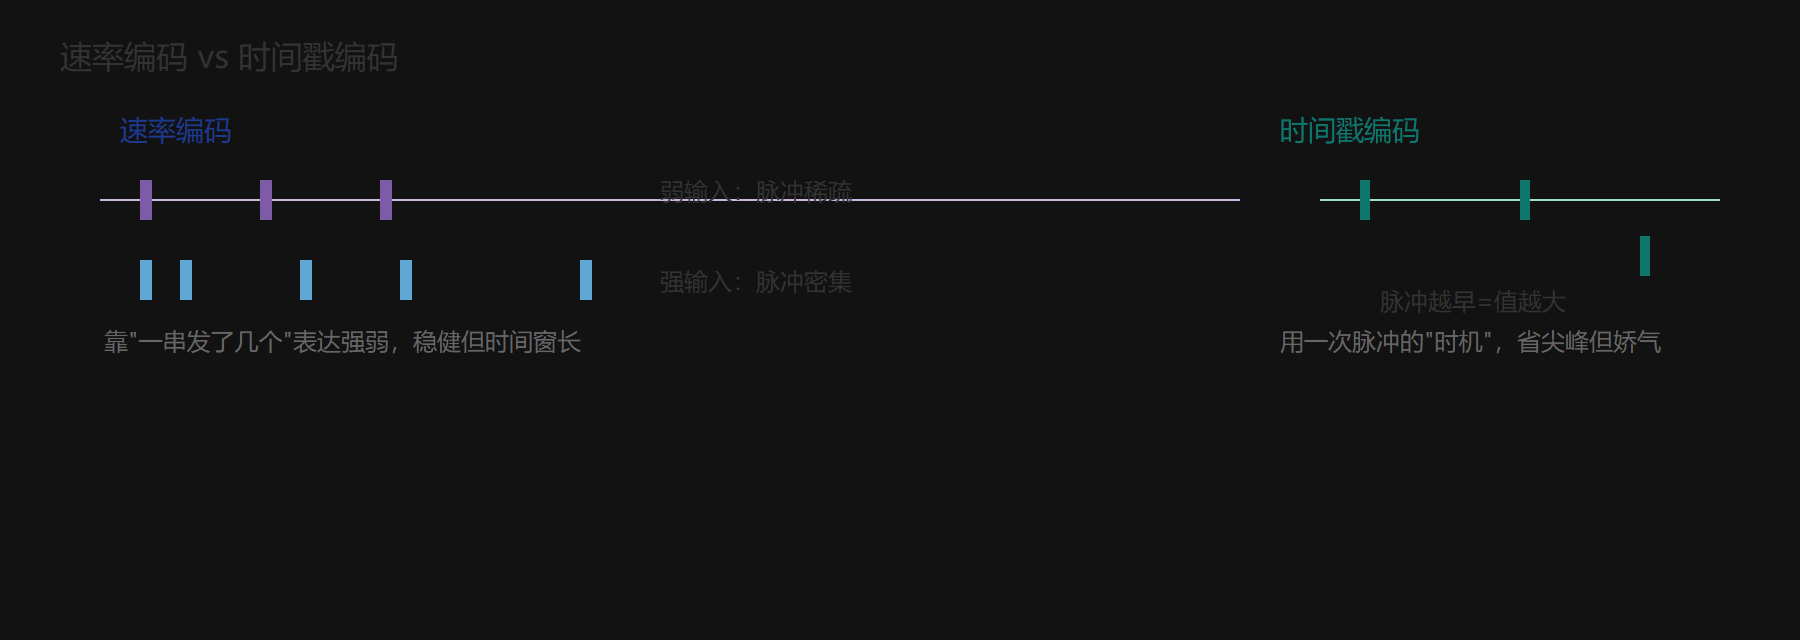
速率编码(rate coding):用单位时间内的脉冲次数表达强弱。尖峰越密,数值越大;越稀,数值越小。它简单、稳健,抗噪——频率是对许多单发的统计,单发抖动影响不大。代价是慢:要数出稳定的频率,得等足够多的时间窗,天然延迟大、且要发很多尖峰、费能量。
时间戳编码(temporal coding):用单发尖峰的具体时机表达信息。一个脉冲早到晚到、彼此相对错开多少,都能携带值。它省尖峰(可能一笔脉冲就带一个数)、速度快(不用等窗口),是节能账上的王牌——正合神经形态"少尖峰省能量"的追求。但代价是娇气:对时序与噪声极敏感,一个脉冲被抖动就丢信息,编码解码都更复杂。
二、把两种编码摆到同一张图上
左边一路是速率编码:同样一股输入,强弱不同时脉冲密疏不同,看的是"一串里发了几个"。右边一路是时间戳编码:脉冲一次到位,信息在"它什么时候发的"。两者在能耗与鲁棒上正好互扇耳光。
三、decode 侧:把脉冲读回结论
编码是入口,解码是出口。常用的解码方式有三条:
频率读出——数最后一层每个神经元在窗口内的脉冲数,谁多谁就是答案;最简单,常配速率编码。
首脉冲时间读出——取最后一层最先放电的神经元为答案;快、能跟时间戳编码配合,但噪声时率先发者未必可靠。
加权计数/膜电位读出——把最后时刻的膜电位拿来当置信度;折中,工程里常见。
选 decode 取决于"答案要在多快出、噪声多大"。读时序敏感的(如要跟真实世界高速交互)会更倾向首脉冲读出,牺牲一点鲁棒换延迟。
放一个具体例子帮分账:假设要识别"值是否超过 5"。用速率编码,刺激强度越高、10 毫秒窗口里脉冲发得越密,解码端数到足够窗宽的脉冲总数再比大小;用时间戳编码,则给一个"越值越大、越早发"的映射——值高的那路神经元先放枪,解码端只需看谁先响就出答案。前者要等窗口攒计数(慢但抗抖),后者几毫秒就有结论(快但怕噪声把顺序打乱)。把这个例子里的"多少 vs 多早"记下来,你再遇到任何编码问题,都能立刻定位它卡在哪一端的预算上。
四、对信号与硬件评价的账
给编码选型的尺子,其实还是第 1 章那把"稀疏性+能量"的尺子:
- 输入天然稀疏、时间敏感(事件相机、动作、语音流)→ 时间戳编码吃香,省尖峰、匹配事件驱动硬件。
- 输入稠密、稳定(静止图像)→ 速率编码更稳更简单,代价是被窗口拖慢,也更能抗各类扰动。
在芯片上,速率编码依赖大量尖峰累积,往往会推高能耗,抵消神经形态的省电;这正是许多实际部署宁可牺牲精度也要用时间戳/事件式编码的原因。第 6 章边缘感知那一节,你会再次看到这股"少发尖峰"的执念。
⚠️ 常见坑:速率编码的"时间窗"不是免费的——窗口拉长意味着累计输入要占更长的时域,硬件里意味着要等定长窗口,实时性打折扣。别以为速率编码只是"简单委婉",它藏着延迟与能耗的隐形账。
💡 关键直觉:编码的选择本质是"噪声预算 vs 尖峰预算"——怕噪声选频率,怕费电选时机。神经形态偏偏两者都想要,于是催生了大量混合/改进编码。
五、编码不止两种:谱系里还有折中
速率与时间戳只是谱系两端,现实里大量编码落在两者之间,你至少该认识三种常用变体。群体编码(population coding):不用一个神经元表达数值,而是让一群神经元各按自己喜欢的"调性"放电,数值由整个群体发放模式的联合决定。它牺牲了一些尖峰预算,换来极高的鲁棒——个别神经元的抖动不影响整体读数,这正是大脑视觉皮层真实采取的路径。顺序编码(rank-order coding):只记录一群神经元放电的先后次序,而不是精确到毫秒的时间差——第一批先放电的神经元代表"最强特征"。它极其省(往往一轮就够),尤其适合事件相机这类"谁先动、谁重要"的信号。相位编码(phase coding):把意义绑在一条背景振荡(脑波)的相位上,脉冲落在波的哪个位置就编码多少,同时背着全局时钟,适合周期性行为。
这三种变体共同揭示一条规律:编码不是在"数频率"和"报时刻"里二选一,而是在鲁棒、省尖峰、简单、可部署之间做连续权衡。 你会看它们对第 4 章硬件的影响更深——群体/顺序编码往往配合"大量廉价小神经元",而精确时间戳编码则要求硬件时钟与脉冲误差足够低。选型时不必纠结"哪种才是标准",而要问:数据稀疏度多少、噪声多大、硬件的脉冲时序精度多少、能在窗口内攒出多少尖峰。四个问号答完,编码自然落位。
最后补一句让"接口思维"立住的话:编码与解码是一对互为镜像的账——入口用的编码,几乎决定了出口该用哪种解码、以及硬件要为此付出多少时序精度。你既不能"入口速率编码、出口却期待毫秒级首脉冲结论",也不能指望给高精度时间戳的硬件去省那根时钟线。把"编码—硬件—解码"当成一根闭环的绳,而不是三个独立零件,后面读部署(第 5 章)才会看到:很多"跑不准"的翻车,根源往往不在模型,而在编码与硬件的时序假设没对齐。
编码账的一句话
- 速率编码:计数脉冲频率,稳健但慢、费尖峰。
- 时间戳编码:用脉冲时机,省尖峰快但娇气。
- 解码三种:频率读出、首脉冲读出、加权计数。
- 选型尺子:稀疏时间敏感 → 时间戳;稠密稳定 → 速率;怕噪用频率,怕费电用时机。