6.5 能源效率与低功耗 AI 的账
6.5 能源效率与低功耗 AI 的账
本节摘要:本节把全书最硬的能耗账摊开——用真账目对比神经形态芯片、GPU、CPU 处理同一功耗敏感任务的年耗电,教你怎么算"省不省、省多少"。读完你会用一组数量级数据,判断一个低功耗 AI 任务该用哪条路线。
这一节是全书"账房"的最硬核一章——前几节讲了场景,这一节把直接把账本数字摊开算,回答"到底省不省、省多少"。这是第 6 章的收束,也是把第 1 章那把尺子真正落成"电表读数"。读它前最好带着 TrueNorth 70 毫瓦/百万神经元、Loihi 片上学习这些具体数字。
一、先定一个可比的口径
比能耗最忌口径混乱。固守规则:同一任务、同一规模、同一精度要求下才可比。对低功耗 AI,最常见的口径是"处理一次推理花几十毫焦耳"或"每处理一笔尖峰花多少皮焦坡(pJ)"。我们不追求精确到个位,只要把数量级拉平,结论就一目了然。下面用一个简化但方向可信的账算,数值取公开报道的典型量级,帮你建立手感。
二、一笔"一年电费"的账
设一个演示性但量级贴近现实的例子:一台边缘设备要长期做"声音关键词唤醒 + 简单手势识别",每天醒着跑一小时、其余休眠。两套方案:
- 方案 A(通用 CPU/GPU 云推理):每次唤醒要联网上传 → 无线+云算,单次唤醒的综合功耗量级在十到几百毫焦耳;一年下来,无线往返、空闲信令、散热,跑出来的电费与带宽账不小。
- 方案 B(事件驱动神经形态芯片):唤醒即本地推理,事件驱动让它平时接近静态零功耗,单次推理只花几个到几十毫焦耳量级的本地能量;休眠时段几乎不耗电。
把两边的"一年耗电"摊成一张粗账(数值为演示量级,用于理解而非精确报价):
| 项 | CPU/云 | 神经形态边缘 |
|---|---|---|
| 每天激活时主处理功耗 | 高(帧级全量) | 低(事件驱动稀疏) |
| 休眠/空转功耗 | 中(总有信令) | 极低(静态功耗小) |
| 联网往返与带宽 | 高 | 无或极少 |
| 一年估算量级 | 高(瓦时级以上) | 低(亚瓦时级) |
结论不是"神经形态永远省",而是"当任务稀疏 + 可从长期休眠唤醒,它一年能省出肉眼可见的电量账"。 这正是边缘低功耗 AI 最值钱的那个场景。
三、真账目:单次推理量级的参照
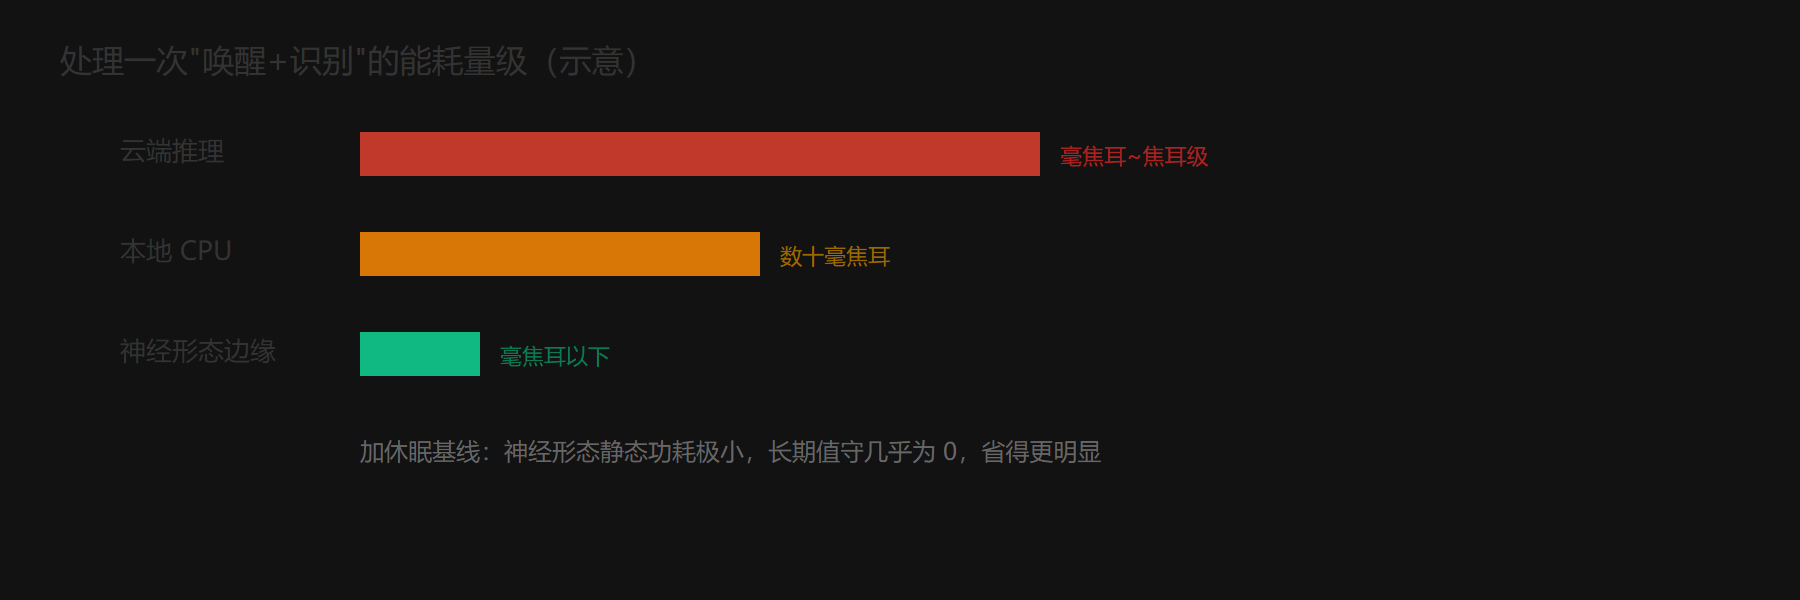
给几个数量级让你对标(记住它们,选型用得上):传统 GPU 单次大模型推理的能耗动辄在焦耳级甚至更高;而事件驱动的神经形态芯片,在专用的稀疏小任务上,单次处理可以是毫焦耳/亚毫焦耳量级——相差可达两个到三个数量级。TrueNorth 用零点几瓦跑百万神经元,同规模下无数倍于 GPU 的落地,正是这个数量级差的活实证。但注意:这成立的前提是任务稀疏且精度可接受,若不满足,数量级差会缩水甚至反转。
补一道"怎么把数量级差用对"的功课,避免拿它对不上号。数量级差最漂亮的场景永远是"稀疏 + 可长眠 + 本地算"三件套;而一旦任务变成"每一帧都要全量推理"(比如持续高清视频流),事件驱动那张牌基本失效,神经形态往往只剩存算一体那一两项优势,数量级差距会立刻从"两个数量级"缩水到"两三倍到同档",甚至因为低精度而更吃亏。所以读别人报的"省 N 倍",先补一问:这是按帧全量任务测的,还是按稀疏多头任务测的? 只有后一类,那个 N 才有意义。把"先对任务形态、再看数量级"这个顺序固定住,你才能把本篇的三个数量级数字真正当成选型时的标尺而不是炫耀的话术。
四、怎么给一个低功耗 AI 任务记账
⚠️ 常见坑:上来就看"TOPS/W"这种单位。它只算计算密度、不含静态功耗与缩放等,片面的能效页常常夸大真省。核算要同时看"静态功耗占比、任务稀疏度、时延预算"三者,才能判断真账。
💡 关键直觉:省电的账,账本底部两行字最关键——"这个任务稀疏吗"和"它休眠时真能零功耗吗"。两行都对,省;任一不对,别谈数量级。
五、一张量级对比图
把"单次动作的能耗量级"画成一张对照图,比念数字更直白:
六、把"一年账"算出个味道
光有量级不够,给一个可验算的直觉。设这台"智能异动门锁"每天真正被触发 200 次唤醒+识别,每次约 50 毫秒活动、其余时间都在休眠:
- 传统云推理:每次要联网上传+云端跑+回传,综合约 0.5 焦耳级别的链路耗能。200 次 × 0.5 J = 100 J/天,一年约 36.5 千焦耳——还没算无线心跳、空转信令和待机的常态损耗,那块容量有限的电池撑不了多久。
- 事件驱动神经形态:每次唤醒只花毫焦耳级别的本地算力,200 次 × 5 mJ = 1 J/天,一年约 0.365 千焦耳,休眠段还几乎不吃电。和上一条是约两个数量级的差距(100 倍上下)。
这个数不是让你背,是让你掌握对比的"形状":只要"唤醒稀疏 + 可长睡 + 本地算",神经形态的常年电量就能压到对方的一个零头;反过来,若任务每天满负荷、唤醒密集,"休眠零功耗"这张牌就废了,两边的账会迅速拉近甚至反转。所以判断一个低功耗 AI 值不值得用神经形态,永远先看"负载与休眠的占比",再看"单次动作省多少"。
最后提醒"省电≠省钱"的另一半账:省下电量还要能装进系统才算数——包括把事件相机的功耗、芯片自带外设的漏电都算进去。真要落地,别只盯着那颗芯片的标称能效,把整条链路和整年负载一起盘一遍,才是第 6 章从头到尾那把"真账"的意思。
把这张能耗账放回全册的高度再看一眼,它其实回答了开头那个"做账房"主调里最该回答的问题:神经形态靠什么省电?答案不是某一颗元件神奇,而是四行账同时在省——稀疏(不必在无关处空耗算力)、事件驱动(空闲即零功耗)、存算一体(不搬权重)、大规模并行(一次过电算一整层)。任何一块"能效领先"的神经形态芯片,都逃不过这四账的某个组合;而任何只靠单个数字(比如 TOPS/W)宣称省电的宣传,都值得你用这四账逐一核对。把"动手前先盘四账、落地前先整年负载"这个习惯带上,你已经真正握住了这本"类脑账房"的钥匙——前半册教的方程、器件、芯片,都是为了把这四行账落到实处。
能耗账的台账
- 可比口径三件套:同任务、同规模、同精度才谈能耗。
- 数量级差:稀疏任务上神经形态单次可为毫焦耳级,比 GPU/CPU 省 2-3 个数量级。
- 一年账是长期主义:稀疏+可休眠场景,省的是肉眼可见的电量。
- 别只看 TOPS/W:静态功耗、稀疏度、时延要一起看才见真账。