7.1 硬件制造与可扩展性的账
7.1 硬件制造与可扩展性的账
本节摘要:本节摊开神经形态最实际的难题——从百万神经元走向人脑级规模的三堵墙:工艺良率、功耗-散热、封装布线。读完你能说出扩展难在哪、为什么"越造越大"不简单是加核。
第 4 章我们看过 TrueNorth 那批百万神经元芯片,但离人脑的千亿级还差好几个数量级。这一节就是全册第一次直面"为什么还没冲到脑量级"。它在知识地图上是挑战章的起点,接第 4 章硬件、朝第 7.3 节的宏大叙事收束。读它前请带上第 4 章"存算一体、事件驱动"的设计原则——扩展问题正是这两条原则升级时的痛。
一、三堵墙,层层卡住规模
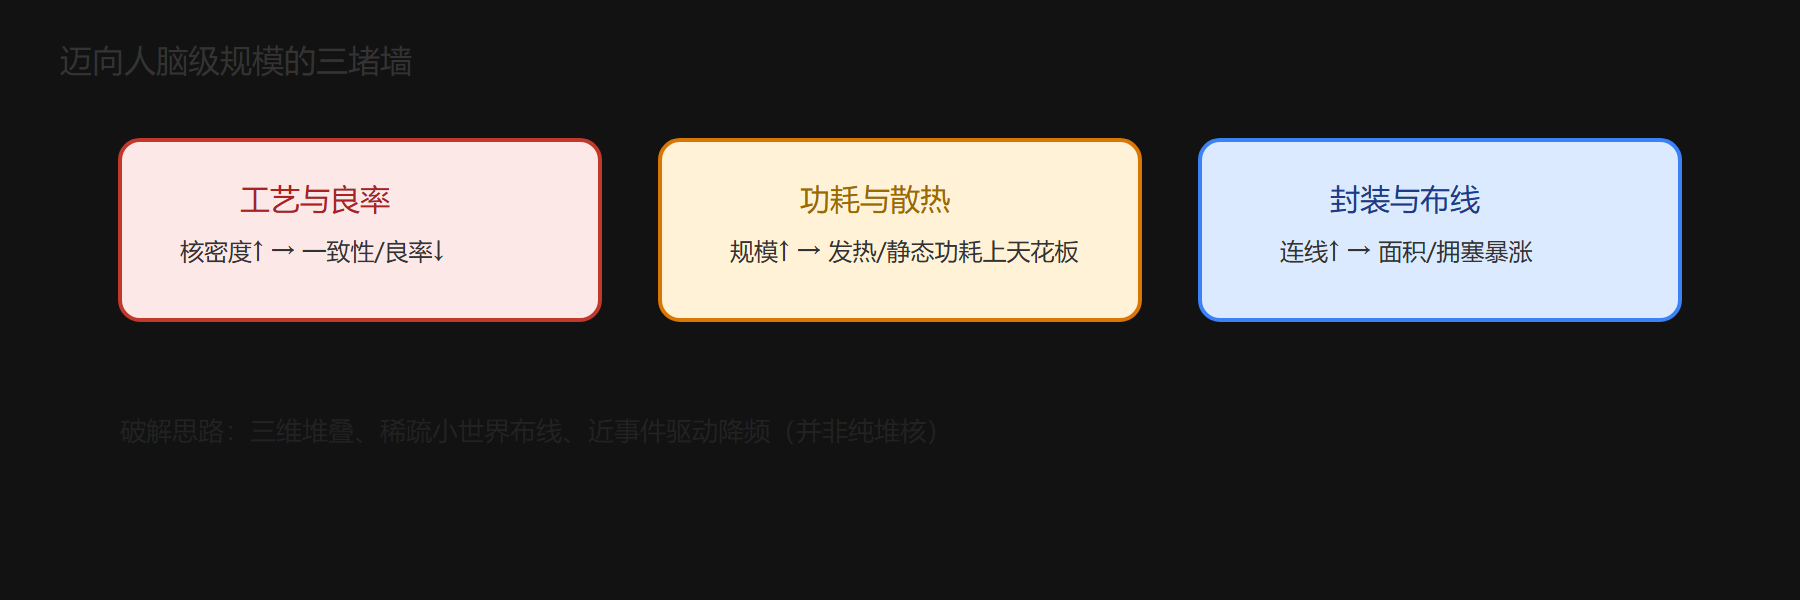
墙一:工艺与良率。 造百万神经元的神经形态芯片,一旦神经核密度再往上翻,工艺的一致性、良率就变得棘手。哪个核心的漏电稍偏,整片账就可能错;规模每大一级,报废成本与调试成本都陡增。前端的工艺尺寸能压,但"规模复用"带来的良率账跑不掉。
墙二:功耗与散热。 神经形态省电是对"稀疏任务"而省,可真把千万级神经元堆在一起跑时,即便每笔尖峰很便宜,整体功耗与发热也在上台阶——那点"省"在面对持续大规模负载时会显得无力。散热就成了物理天花板,不是设计能轻易绕过的。
墙三:封装与布线(片上网络)。 神经元越多,核之间要连的账就越多。交叉开关、片上网络要支撑海量连线,面积与布线拥塞暴涨,而每个核还是只做很窄的事。这是最实际也最抓狂的一堵墙。
二、扩展的账:加核不是无脑加
人脑的账很大气:千亿神经元、万亿突触,却几乎不卡在"连线拥塞"上——它的布线是三维的、稀疏的、小世界的(第 2.3 节)。而我们现在的芯片是二维平面,连线一通就挤满,这正是它扩展到人脑级时天然吃亏的地方。所以"把规模往上提"不是简单地把 TrueNorth 拼 N 片,而是要拆维度解决布线、功耗、良率三笔账。
三、现实的可扩展路线
尽管三堵墙在,工程上仍有几条还账的路:三维堆叠用多层布线缓解平面拥塞;稀疏/事件驱动在芯片内优先连真需要连的核,把"连线密度"摊薄而不是堆满;多片互连用小世界思路把多个芯片拼成更大网络(章作为 S 级方案)。这也是为什么不能用"一颗芯片打天下",而要像人脑那样"局部抱团 + 长程稀连"地拼装。
四、怎么做才不踩坑
⚠️ 常见坑:用"我有 N 千万神经元"当卖点时,先看它是不是"算力打包虚标"。有的把"元件/突触数量"当"可用的神经元数"吹,绕开三堵墙不提。看规格要拆开问:可真正并行跑的有多少?连线密度多少?静态功耗占多少?
💡 关键直觉:规模不是加法账,是乘法账——核数×连线×功耗三路一起涨,才决定能不能真扩。人脑的妙,在它有办法让这三笔账不同时爆炸。
五、为什么"越多核"不直接等于"越接近脑"
把三堵墙再往工程里落一落,你会明白"神经元数"这个数字本身很容易骗人。厂商喜欢报"我集成了 N 千万神经元",但真正决定能力的是另一组数:
- 可用 vs 包装:规格书里的"神经元数"常是"集成单元数",而真正能并行工作、被路由接通的往往少一截。两数之间那段的差距,往往被营销轻轻带过。
- 连线密度:神经元只是"格子",要让格子之间能互相传脉冲,需要突触与路由。规模翻倍,需要的连线与路由近乎平方增长,这才是布线的真账——两个千万级神经元芯片,一个连线稀疏、一个连线爆满,能力天差地别。
- 静态功耗占比:神经形态省电是"读稀疏时省",在满负载时,所有并行的核都在烧电。一个芯片有没有"静态功耗大得离谱"的问题,取决于它并肩数开满时的常态功耗,而不是它吹的那句"单峰 pJ 级"。
用这三把尺子去读类似"千亿神经元芯片"的新闻,你会自然发现:那多是"提出规划体系/小规模原型",离"真的装进人脑级规模并长期稳定跑"还有数道没写完的账。这不是泼冷水,而是让你把"规模"从宣传词还原成"工艺、连线、功耗"三笔实账——读懂翻倍的代价,你才读得懂为什么神经形态一路走的都是"局部抱团 + 长程稀连"而非"无脑堆核"。
再补一句务实的判断:扩展的合理路径不在"一颗更强的大脑芯片",而在"把多颗成熟芯片按小世界拓扑拼成更大的计算岛"。曼彻斯特的 SpiNNaker 正是以"一百多万核的众核网络跑脑规模模拟"立起来的——它证明"怎样连"往往比"单点做多大"更牵动可扩展性这笔账。
再把"规模翻倍的代价"算成看得见的三笔,帮你建立数量感。 假设从百万神经元往千万神经元走:第一笔,工艺与良率——芯片面积与良率的关系通常是指数级的,面积越大、良率掉得越狠,一颗千万级大芯片在量产时的"坏片"成本,远比两颗五百万级拼起来高,这是制造端的强制分摊;第二笔,功耗与散热——就算单笔尖峰降到皮焦级,千万个神经元同时响应一次,瞬时功率也会跨过散热设计的分水岭,届时你面对的不是"省不省"而是"散不散得掉";第三笔,连线与布线——核间连线数量大致随核数平方上涨,平面布线会在某个规模撞上拥塞上限,这就是为什么必须引入稀疏、层级、三维。把这三笔的量级放进脑子,你就能一眼看出那句"我做到 N 千万神经元"底下藏的代价结构,也更能体会为什么神经形态的旗舰产品都谨慎地停在"用来做特定任务的专用规模",而不是盲目宣称要追平人脑——不是不想,是三笔账同时爆炸的现价,还没人付得起。
一句话收束本节:可扩展性的本质,是"核数、连线、功耗"三笔账的联乘游戏,谁能同时压住这三项递增的斜率,谁才配谈"逼近人脑级"——单独堆任何一项数字,都只是替下一堵墙提前挖坑。
六、把"要到脑量级"翻译成一道乘法题
很多宣传把它讲成"只要再加亿点核"。真把它翻译成一道乘法题,你会清醒得多。假设一颗旗舰神经形态芯片做到一千万神经元,人脑按一千亿(一百倍于千万,也就是一百亿)粗略算一算数量级,你会看到:
第一项:物理体积。 芯片要容纳的连线与突触随规模增长,即便单核做得再密,千万级芯片本身已是多倍互连的庞然大物;从千万冲到百亿,光是把"要连的东西"装下、走线安排进来,就像把一座城再放大百倍而不让街道堵死,面积、封装、层数每一项都在抬价。
第二项:功耗账。 前面说过单笔尖峰省电,可满负载时千万级已撞散热墙;若放大到脑量级并保持"高并行实时响应",瞬时功耗与散热的工程难度是连乘放大的,不是简单多买几台制冷机能兜住的。
第三项:连线账。 它随核数近似平方涨。十万核时几条长程通道叫"小世界",百亿核时要维持同样的"平均跳数很短"就需要极其优化的路由与层级,这在平面工艺里几乎是物理级难题——必须靠三维、稀疏、层级反复拆解。
所以"到脑量级"从来不是"把当下芯片做大一百倍",而是"每一步都把核、线、功耗三者的斜率同时压下去"的长期工程。看懂这道乘法题,你就明白了为什么整个领域目前更现实的目标,是"在特定任务上做够用的大"(百万级神经元、专用场景),而不是一步登天地冲人脑。这页判断本身就是读神经形态新闻最重要的一块压舱石——别人说"冲向人脑"时,你心里有那三道每翻一倍的代价,就稳稳当当的了。
本节要点回顾
- 三堵墙:工艺良率、功耗散热、封装布线,层层卡规模。
- 加核≠无脑加:密度、连线、功耗三笔账联乘决定能不能扩。
- 突围路线:三维堆叠、稀疏小世界布线、多片互连。
- 拆虚标:把"可用神经元数、连线密度、静态功耗"分开看。