1.2 量子计算与经典计算的本质区别
1.2 量子计算与经典计算的本质区别
本节摘要:别以为量子计算机只是一台"更快的经典计算机"——它们的差别不在速度档位,而在描述状态的语言。经典 n 比特任一时刻只有 n 个确定值,量子 n 比特的状态由 2^n 个概率幅张成;前者随比特数线性增长,后者指数爆炸。本节算给你看这个差距有多大,再解释为什么"状态空间大"不等于"算力大"——中间隔着干涉与测量两道关。
从一道算术题说起
拿三个比特做实验。经典情形,三个比特在任一时刻的状态就是三个格子里的确定值,比如 011。想描述"三个比特所有可能的取值",你列一张 8 行的表就够了——但注意,机器本身在任一时刻只处于其中一行。
量子情形完全不同。三个量子比特的状态要写成 |ψ⟩ = α₀|000⟩ + α₁|001⟩ + …… + α₇|111⟩,8 个概率幅一个都不能少,否则状态没有完整定义。描述它,你必须把 8 个复数全部写出。比特数翻倍,这张概率幅表就从 8 行变 16 行、32 行……每加一个量子比特,状态空间的维度翻一倍。
把这张增长表算到物理极限附近,差距就不再抽象:
| 量子比特数 n | 概率幅个数 2^n | 经典内存(存双精度复数) |
|---|---|---|
| 10 | 1 024 | 约 16 KB |
| 30 | 约 1.07×10^9 | 约 16 GB |
| 50 | 约 1.13×10^15 | 约 16 PB |
| 300 | 2^300,超过可观测宇宙原子数 | 不可存放 |
数值演算只到 50 就撑爆了今天所有经典计算机的内存——这就是经典计算机模拟量子系统的天花板:几十个量子比特的完美模拟已经做不到,而真实量子器件轻松拥有上百个物理比特。2020 年前后的"量子霸权/量子优势"实验,本质都是利用这道模拟鸿沟做文章(第 7.2 节会复盘那些实验的成色)。
状态空间对比图
图:经典三比特与量子三比特的状态空间形态
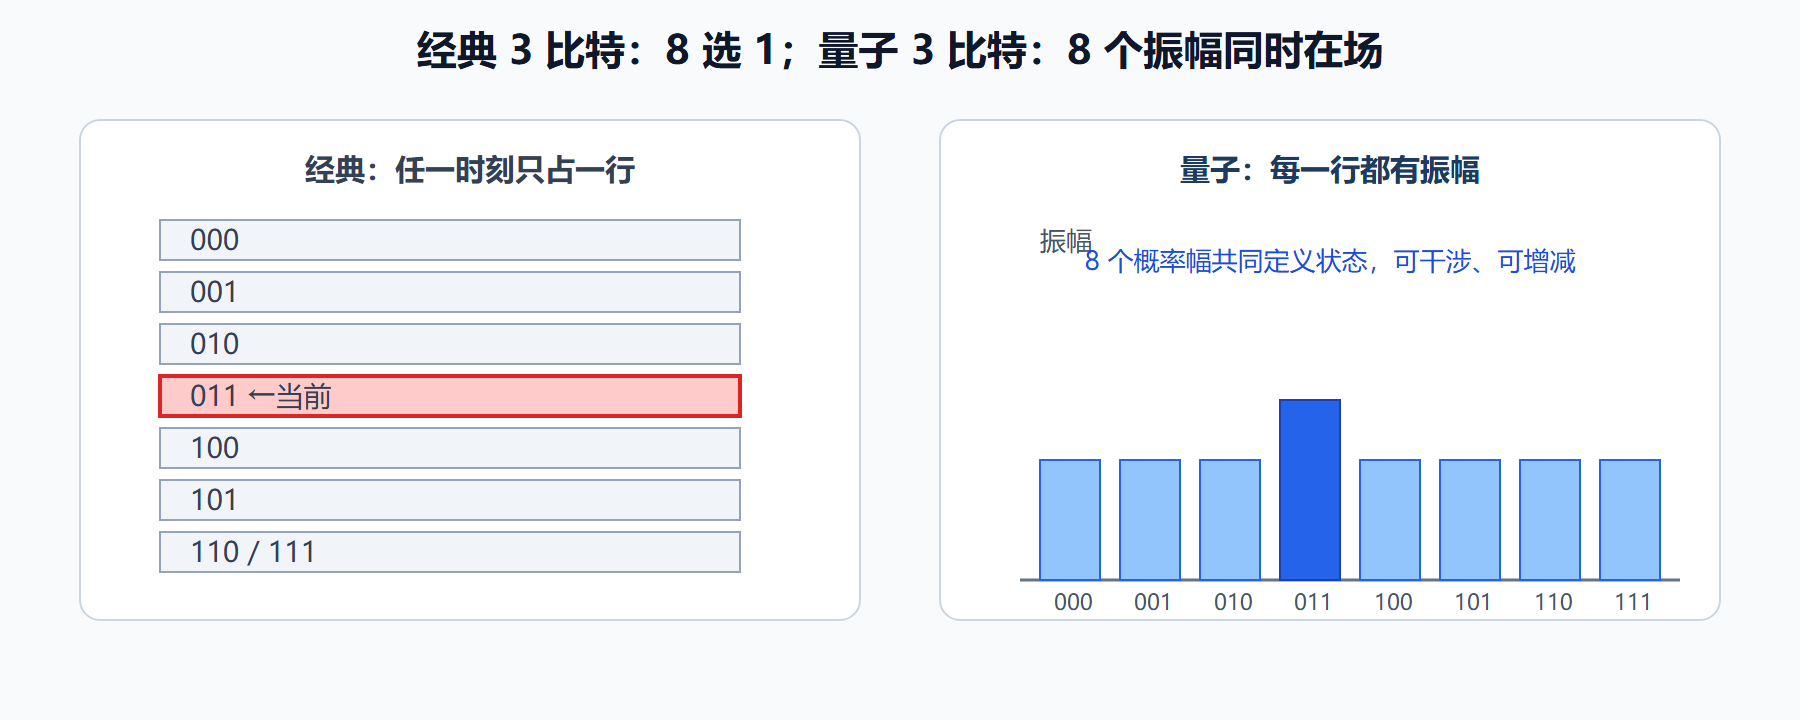
左边的经典机器,8 行表只是"可能性的目录",机器每次只走一行;右边的量子系统,8 个振幅全是"现在时",每一个都能被门操作增减——这是两种截然不同的物理实在。
干涉:把状态空间优势变成算力的桥
如果只看"振幅多",很容易得出"量子计算机并行尝试所有答案"的错误结论——错误在于你读不出。测量时,2^n 维的振幅矢量瞬间坍缩成一个 n 比特结果,一次测量只给一个样本,而且样本服从 |振幅|² 分布。
真正的桥是干涉。振幅是复数,带相位,可以相加也可以相抵。算法设计者的工作,是安排一串量子门,让所有指向错误答案的振幅路径互相抵消(相位相反),指向正确答案的振幅路径互相加强(相位相同)。这和波纹水池里的水波叠加是同一个数学:两列波同相则浪更高,反相则水面平静。
所以更准确的口号是:量子计算不是"同时尝试所有答案",而是"让错误答案在测量前自我湮灭"。 第四章你会看到三个具体算法如何执行这个口号——Deutsch-Jozsa 用一次干涉分辨函数性质,Grover 迭代着放大振幅,Shor 用傅里叶变换读出周期。
操作与读出的三条硬差异
| 差异点 | 经典 | 量子 | 后果 |
|---|---|---|---|
| 门是否可逆 | 与、或不可逆(两个输入压成一个输出) | 全部幺正、可逆 | 量子编译器必须把不可逆逻辑改写成可逆形式 |
| 能否复制状态 | memcpy 随便复制 | 不可克隆定理禁止复制未知量子态 | 纠错不能靠备份,只能靠冗余编码(第 5.3 节) |
| 读出代价 | 读寄存器,无损 | 测量坍缩,统计式 | 算法输出必须是"少比特的答案",不是大表 |
这三条里,不可克隆对工程的影响最容易被低估:经典容错靠多副本对账,量子容错连"对账"的资格都没有——你不能把一个量子态复制三份投票。第 5.3 节的量子纠错码就是在给这个困局找出路。
一段可运行的对照实验
用几百字代码在经典计算机上模拟 3 比特,你能直观摸到两种范式的差别。下面用 Python 风格伪代码模拟"3 量子比特均匀叠加态"的测量分布:
import random, math # 3 比特均匀叠加:每个基态振幅 1/sqrt(8) n = 3 dim = 2 ** n # 8 个基态 amp = [1 / math.sqrt(dim)] * dim # 8 个概率幅,全部相同 # 测量:概率 = 振幅模平方;均匀叠加下每个基态概率 1/8 counts = [0] * dim for _ in range(8000): r = random.random() acc = 0.0 for i, a in enumerate(amp): acc += a * a if r < acc: counts[i] += 1 break print(counts) # 每项都接近 1000:8 个结果平分 8000 次测量
注意模拟代码里那行 2 ** n:模拟器必须显式扛住 8 个振幅,而真实量子系统"天生免费"地拥有它们。模拟的代价随 n 指数上涨,量子器件的代价随 n 线性上涨——这道成本曲线的交叉,就是整个领域的经济叙事。
本节要点回顾
- 状态空间:经典 n 比特是 n 个确定值,量子 n 比特是 2^n 个概率幅;50 比特已超经典内存极限。
- 振幅不是概率:振幅是复数、带相位、可干涉;测量概率是振幅的模平方。
- 干涉是桥:把状态空间优势兑现为算力的唯一通道,是让错误答案的振幅相消。
- 三条硬差异:门全可逆、状态不可克隆、读出必须坍缩——它们共同塑造了量子算法与纠错方案的形态。
下一节把镜头拉远:这条"数学先于机器"的技术路线,是怎么一步步走到今天的。
一道容易答错的思考题
问:既然量子 n 比特拥有 2^n 个振幅,能不能用它来"免费存储"海量经典数据,比如把一部电影编码进几百个量子比特?
答:编码进去不难(数学上 2^n 个振幅确实装得下),难的是读出来。测量一次只返回一个 n 比特基态标签,想读回电影,平均要测 2^(n-1) 次,而每次测量之前还得重新制备状态——制备本身的开销没有省。这个例子把本节的核心再敲了一遍:状态空间的优势必须经由干涉兑换成特定问题的步数节省,才叫算力;直接当存储用,是负收益。量子计算不是更大的仓库,是更聪明的路线选择。
再补一组可以自己动手验证的数字:用任何语言模拟 30 比特的均匀叠加态,光分配振幅数组就要 16 GB 内存;同样的叠加在真实设备上只是"每个比特过一遍 H 门",30 个门而已。跑一遍这个小实验,指数鸿沟就不再是纸面谈资。