5.3 量子纠错与容错计算
5.3 量子纠错与容错计算
本节摘要:量子纠错是全领域最反直觉也最关键的工程发明:在禁止复制、禁止直接读态的约束下,用多个物理比特编码一个逻辑比特,靠"症状测量"定位错误而不惊扰信息本身。本节先用最小样本(三比特码)走通原理,再展开表面码的格点逻辑与开销账本(码距 d 需约 d² 个物理比特),最后给出 2023-2024 年"越纠越好"实验为什么被视为领域拐点。
经典方案为什么全部失效
经典容错三板斧——副本冗余、多数投票、循环校验——搬到量子世界三步就死。
副本:未知量子态不可克隆(1.2 节的硬约束),抄不了。投票:多数投票要先读出各副本,而测量即坍缩,读的第一个副本就把信息毁了。校验和:量子错误是连续的——振幅可以偏转任意小角度,经典"哪一位翻转了"的离散分类根本套不上。
表面上死局。1995 年 Shor 给出的破解思路是三招连用:编码(把一个逻辑比特的信息分散进多个物理比特的联合纠缠结构里)、症状测量(不测数据本身,只测数据对之间的"关系",比如"这三位是否一致"——答案是奇偶性,坍缩只伤奇偶不伤信息)、离散化(连续的小偏转经过症状测量后被投影成有限几种离散错误,再各配对策)。三招合起来,连续错误、不可复制、不许直读三个约束竟然同时被绕开——这是 1.3 节时间线上"1995-96 纠错码"的全部内容,也是理论家对"量子计算不可能实现"最响亮的回击。
最小样本:三比特码的完整一轮
用重复码保护一个比特免受"翻转错误"(X 错误)。把 α|0⟩+β|1⟩ 编码进三比特纠缠态(注意:不是复制!是纠缠编码):
编码:α|0⟩+β|1⟩ → α|000⟩ + β|111⟩ 线路:CNOT(数据→辅助1) + CNOT(数据→辅助2) 症状测量:只问三个比特"是否一致" 测 Z1Z2 与 Z2Z3 两个奇偶(不读 α、β) 000 或 111 → 症状 (0,0),无错 100 或 011 → 症状 (−1,·),第一位翻转 → 补 X1 010/101 → 症状 (·,+1),第二位翻转 → 补 X2 001/110 → 第三位翻转 → 补 X3 解码:三个 CNOT 反向 + 恢复 α|0⟩+β|1⟩
症状表里没有任何一格暴露 α 或 β 的值——信息完璧归赵,错误被定位。但三比特码的软肋也明摆着:它只治 X 翻转,治不了 Z 相位错误;且一个码块错两位就无法区分。修法是升级:Shor 九比特码同时治 X 与 Z;Steane 七比特码、以及最终的主角表面码,都在这个框架上加码。
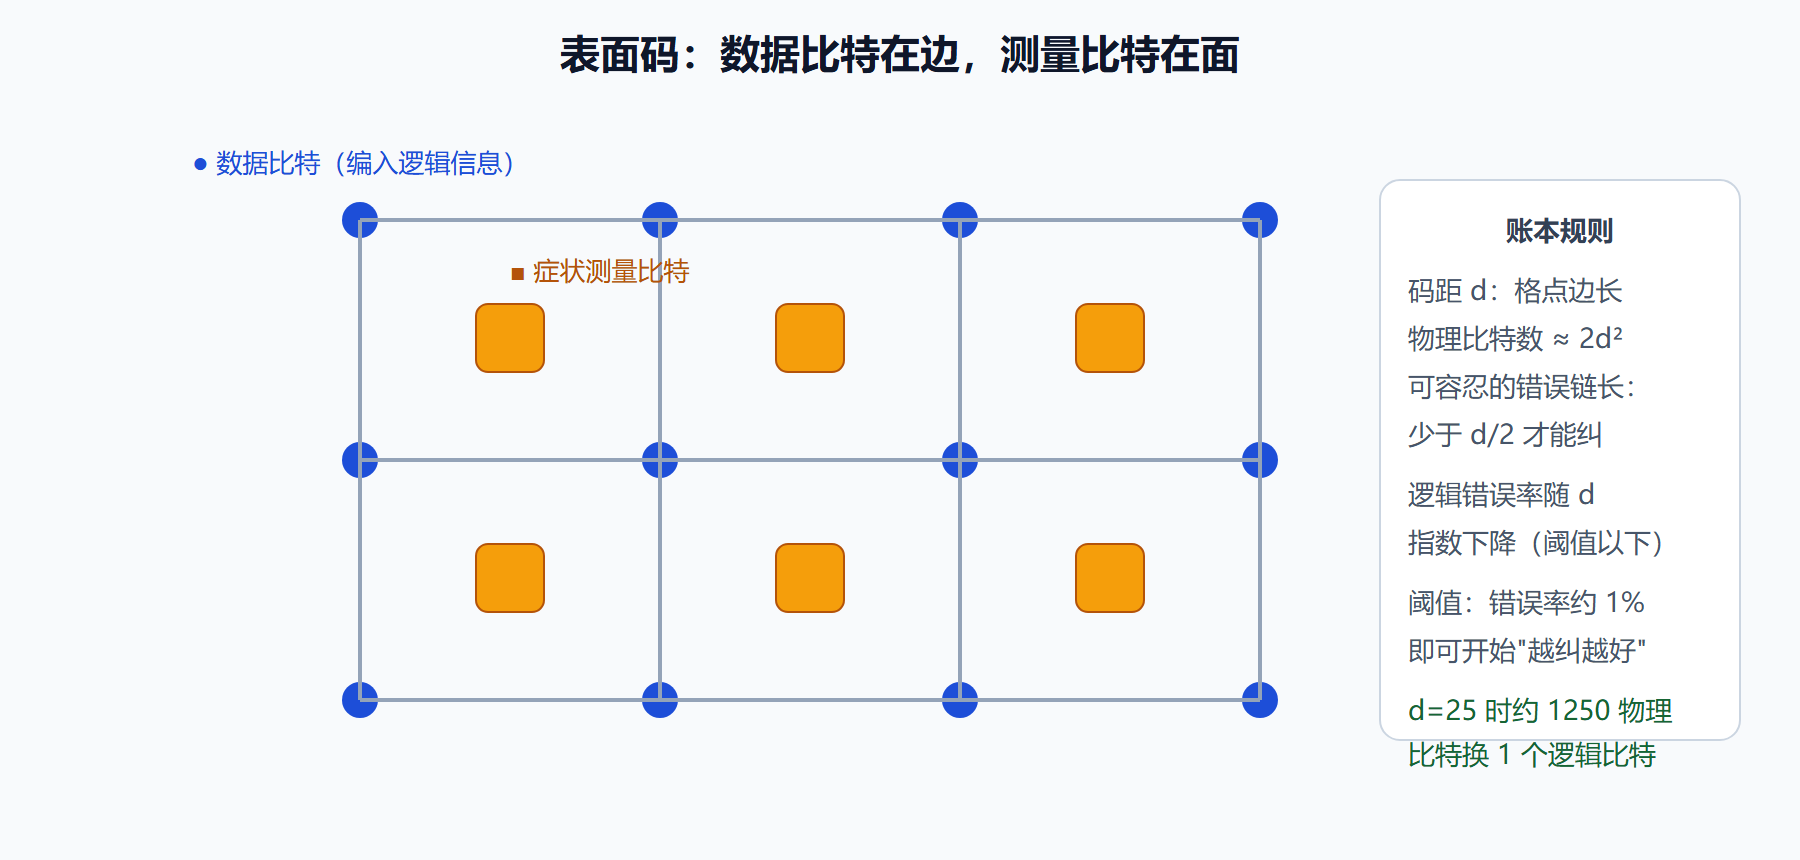
图:表面码的格点结构
表面码为什么胜出
众多纠错码里,表面码成为主流候选有三个工程理由。第一,只要求近邻互连:数据比特排成平面格点,症状比特坐在面和边上,每轮只做四邻居的奇偶测量——恰好匹配超导芯片的物理布局,不需要全连通。第二,阈值高:只要物理门错误率压在约 1% 以下,加大码距就能让逻辑错误率指数下降;1% 这条线,最好的超导设备已经摸到(5.1 节的两比特门 0.3%-1% 正是这句话的上下文)。第三,症状测量循环简单:同一套操作反复打拍子,硬件化友好。
代价 equally 明确:开销与深度。一个 d=25 的表面码块约 1250 个物理比特换 1 个逻辑比特,而跑 Shor 分解需要数千个逻辑比特——乘起来就是"数百万物理比特"的量级(4.3 节那笔账的出处)。每个纠错周期本身也要上千个门操作,好在全部是近邻操作,可以流水线化。码距可调是表面码的温柔之处:从小 d 起步验证增益,硬件进步后逐步加大。
拐点证据:从"纸面承诺"到"实测增益"
纠错真正说服世界靠两条实验曲线。2023 年,中性原子平台把 48 个物理比特编成若干逻辑比特,两逻辑比特门保真度首次超过其组成物理比特的错误率——纠错增益(below breakeven)第一次在多逻辑比特系统实测。2024 年,超导平台给出系统性的"码距-错误率"曲线:码距从 3 加到 5、7,逻辑错误率按理论预期逐步下降,且更大码距的方案在下一代硬件上可行性已验证。这两组数据合起来宣告:只要错误率在阈值下,"越纠越好"不再是信仰,是曲线。
容错还差最后一块:通用计算需要非 Clifford 门(4.1 节出现过的 T 门),表面码上它靠"魔态蒸馏"制备——用多个带噪 T 态蒸馏出一个高纯 T 态,蒸馏工厂又是大片物理比特。当下硬件路线图上的里程碑几乎全与这块拼图有关:先把单逻辑比特做到长存,再把两逻辑比特门做好,最后把蒸馏工厂开起来——三件事齐了,Shor 才从数学变成日程表。
本节要点回顾
- 三重约束三招解:编码对抗不可克隆、症状测量绕开直读、离散化驯服连续错误。
- 三比特码是最小样本:症状只报奇偶,信息分毫不动。
- 表面码三优势:近邻互连、阈值约 1%、循环简单;代价约 2d² 物理比特换 1 逻辑比特。
- 拐点已实测:2023-2024 的纠错增益与码距曲线把容错从纸面拉进实验室。
至此,从比特到逻辑比特的完整阶梯修通。下一章走出技术栈,看这些能力兑现到密码学、化学、金融、AI 时,哪些是真需求、哪些是叙事。
延伸辨析:纠错的成本与耐心
**症状测量为什么自己不出错。**症状比特测完就扔(每轮重置重用),它携带的错误随读出被清空,不会累积到数据上——这是"用一次性探针换数据永生"的设计。代价是每轮纠错周期要跑完整个症状电路(表面码一轮几百个门),纠错的开销以时间体现为"线路变慢",以空间体现为 2d² 比特。
**为什么 T 门那么贵。**表面码原生的门集合(H、S、CNOT)对应的逻辑操作都好做,唯独 T 门(π/8 相位)无法直接在码内实现,只能靠魔态蒸馏:用大量带噪 T 态炼出少量高纯 T 态,蒸馏电路本身就是一片表面码。通用计算的门预算里,T 门数量成了第一成本指标——4.3 节说 Shor 的工程优化"含 T 门计数最小化",出处就在这里。
经典纠错码工程师看量子码的三个惊讶。其一,码不是存数据的一次性包装,而是边算边纠的连续过程——纠错与计算在时间上交织;其二,错误率不是越低越好地追求极限,而是只需压过阈值,剩下交给码距;其三,"测量"本身是纠错流程的一环,而非计算的对立面。三个惊讶指向同一件事:量子容错是一套运行时系统,不是一次性编码。
问题:逻辑量子比特什么时候能"用"
行业的中期共识是按逻辑比特数量级分档:十几个逻辑比特 + 低错误率,可跑出有科学价值的演示(如小体系化学基准);数百个,进入 6.2/6.3 节部分应用的起跑线;数千个,Shor 级算法提上日程。对照 2023-24 的实测(单块与小规模逻辑比特),行业处于第一档的门口。这个分档比年份预测诚实,因为它每一步都有可验证的门票。