1.1 三大实现盘点:HotSpot、OpenJ9 与 GraalVM
1.1 三大实现盘点:HotSpot、OpenJ9 与 GraalVM
本节摘要:JVM 是规范而不是某一个程序,HotSpot、OpenJ9、GraalVM 都是它的实现。本节盘点三家的设计取向与适用场景,并教你用几条命令认出自己机器上运行的是哪一台——这是后续所有调参与排错动作的前提。
上一章把 JVM 抬上了解剖台,本节先解决一个基本问题:台上这台"机器"其实不止一个型号。就像"汽车"是一个品类,丰田、大众、比亚迪是具体厂商,"Java 虚拟机"是规范定义的品类,HotSpot、OpenJ9、GraalVM 是具体实现。你在生产环境调的每一个参数、看到的每一种 GC 日志格式,都绑定在某个具体实现上——认错机器,处方就会开错。本节讲完三家的差异,下一节讲它们共同遵守的规范文本从哪来。
先看市场格局:谁在运行你的 Java 程序
服务端世界的大多数 JVM 进程,跑的都是 HotSpot。它是 Oracle JDK 和绝大多数 OpenJDK 发行版的默认虚拟机,从 JDK 1.2 时代一路演进至今。所谓"绝大多数 Java 性能问题的默认现场",指的就是它。
OpenJ9 是 Eclipse 基金会托管的开源实现,血统来自 IBM J9。它在内存占用上长期优于 HotSpot:同样一个 Spring Boot 应用,OpenJ9 启动后的常驻内存往往能省下一块可观的份额,因此它在一度流行的微服务与 Serverless 实验中常被拿来替换默认 JVM。代价是社区生态较小,遇到疑难杂症时,可搜到的中文资料、性能工具链适配都比 HotSpot 少。
GraalVM 是 Oracle 实验室推出的高调玩家,它有两重身份:既是一个用 Java 写的高性能 JIT 编译器(可以插进 HotSpot 替换 C2),又是一套独立运行时(Substrate VM),能把 Java 程序提前编译(AOT)成不依赖 JVM 的原生可执行文件。后者正是近年云原生浪潮里它被反复提及的原因:启动时间从秒级压到毫秒级,常驻内存大幅下降。
还有 Azul Zing(C4 收集器、无停顿回收的商业先驱)、阿里的 Dragonwell、亚马逊的 Corretto 等——后两者本质是 OpenJDK 的发行版,内核仍是 HotSpot。理解了"发行版不等于另一个实现",市场格局就清楚了:内核层面真正要分辩的,主要是 HotSpot、OpenJ9、GraalVM 三家。
HotSpot:默认选项是怎样炼成的
HotSpot 的名字来自它的核心机制:通过解释器与即时编译器协作,探测"热点代码"(反复执行的方法与循环),把它们编译成机器码缓存起来。冷代码用解释执行省内存,热代码用编译执行换性能——这套分层策略让它在不预付全部编译成本的前提下,逼近甚至达到 C++ 的峰值性能。
它长期占据主导还有几个工程原因:GC 家族齐全,从 Parallel 到 G1 再到 ZGC,覆盖各种延迟与吞吐诉求;诊断工具链成熟,jstat、jmap、JFR 全都围绕它打磨;遇到问题时,你能搜到的案例、博客、论文绝大多数基于它。生产环境选型时,"出事了好找人"本身就是重要筹码。
动手看看它的分层编译开关(不同版本默认值不同,JDK 8 起服务端模式默认开启分层编译):
$ java -XX:+PrintFlagsFinal -version 2>&1 | grep -E "TieredCompilation|Compiler" bool TieredCompilation = true {product} intx CompilationPolicyChoice = 2 {product} java version "21.0.2" 2024-01-16 LTS
TieredCompilation=true 说明分层编译在工作,CompilationPolicyChoice=2 对应默认的分层策略。这类参数核查在本册第六章会大量出现,这里先混个脸熟。
OpenJ9 与 GraalVM:另两条路线
OpenJ9 把赌注押在"省"上:更紧凑的对象布局、共享类缓存(类数据在多个 JVM 进程间复用)、默认就用分代并发收集器 gencon。同一个堆上限设置,OpenJ9 的实际内存曲线通常更平缓。如果你的场景是大量短命小进程(批处理任务、函数计算实例),这笔账很划算;反之,长跑型大堆服务上,它的峰值吞吐一般不如调教好的 HotSpot。
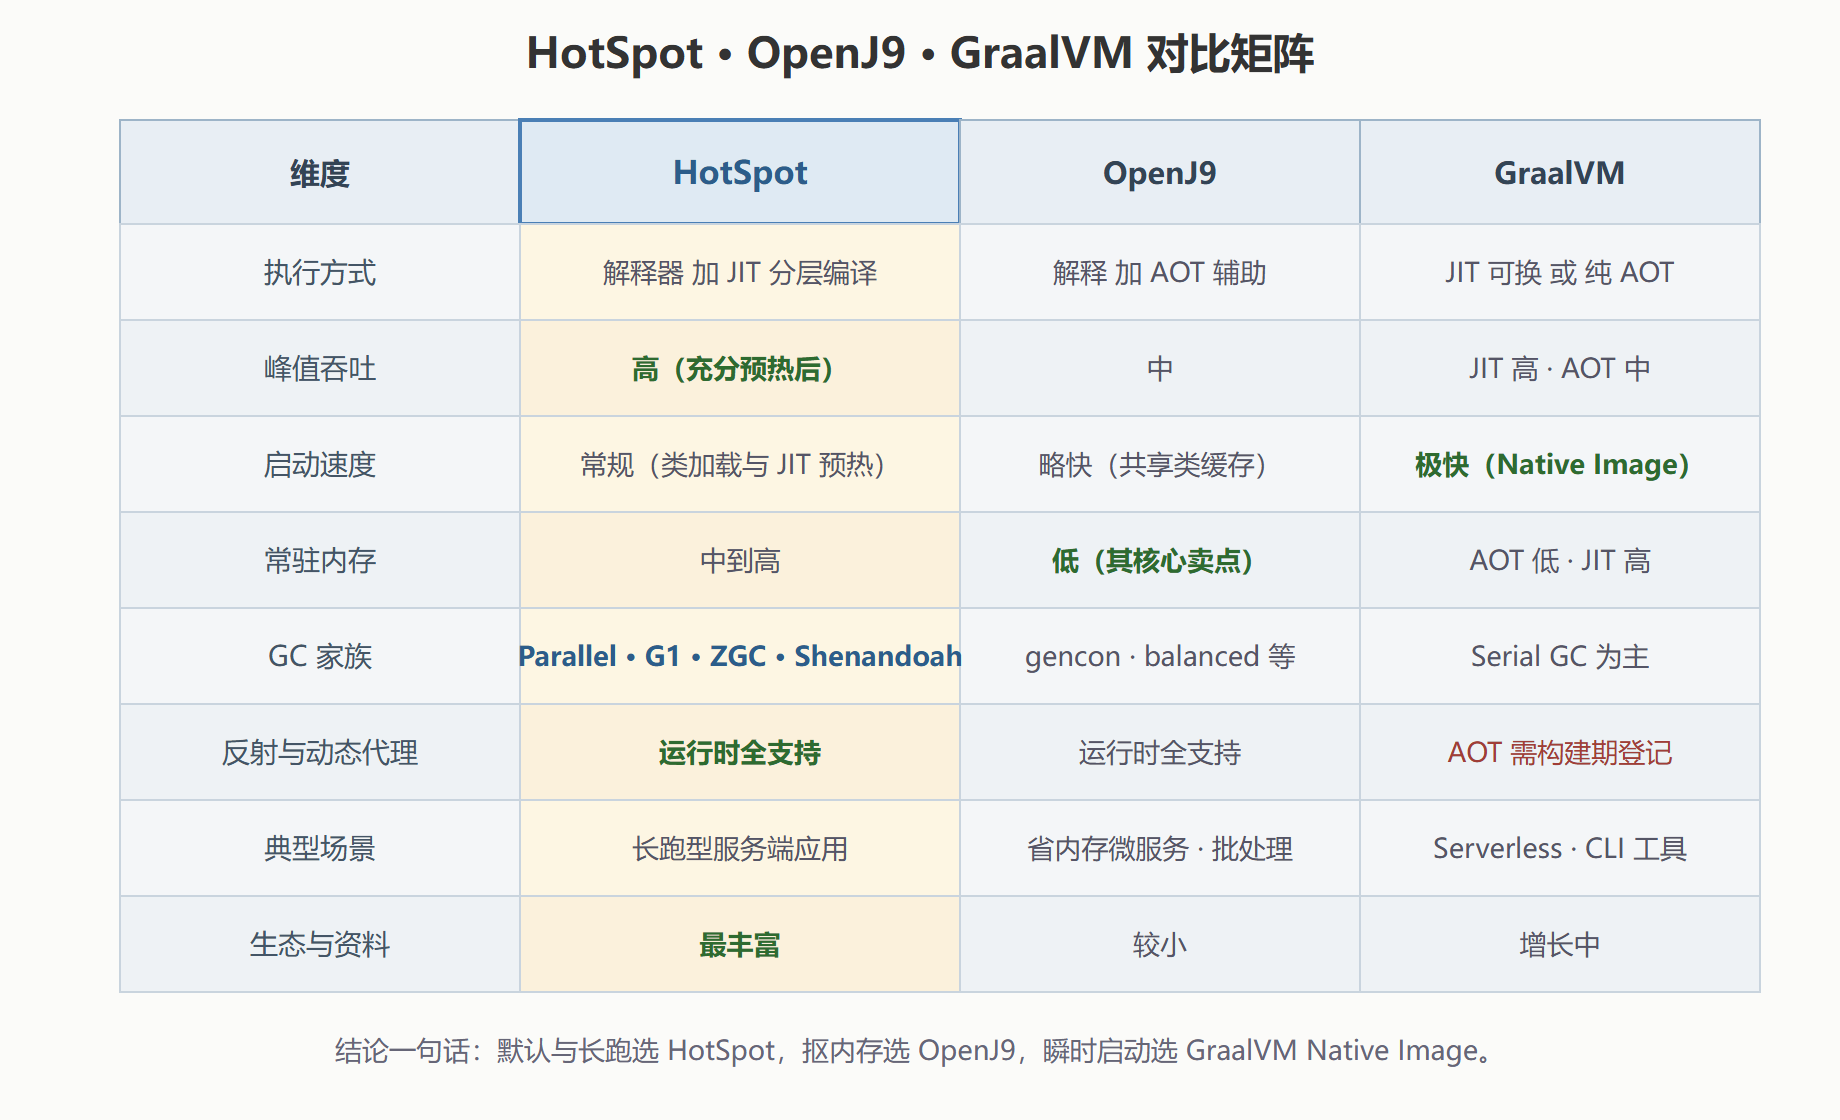
GraalVM 的 Native Image 路线则干脆改了开局方式:在构建阶段就做完类加载、静态初始化,把可达代码编译成原生机器码。运行时没有 JIT、没有传统的类加载,启动几乎瞬时。代价同样明显:反射、动态代理、动态类加载这类"运行时魔法"需要在构建期显式登记;峰值性能通常低于充分预热的 HotSpot;构建时间长。它们三家的取向可以摆成一张对照表:
图 1-1:三大 JVM 实现多维对比矩阵
动手验证:认出你手里的那台机器
选型讨论容易停留在纸面,用三条命令就能落地。第一条看身份:
$ java -version openjdk version "17.0.10" 2024-01-16 OpenJDK Runtime Environment Temurin-17.0.10+7 (build 17.0.10+7) OpenJDK 64-Bit Server VM Temurin-17.0.10+7 (build 17.0.10+7, mixed mode)
末尾 Server VM 与 mixed mode 是 HotSpot 的名片:服务端虚拟机、解释与编译混合执行。如果是 OpenJ9,这里会显示 Eclipse OpenJ9 VM;GraalVM 则带 GraalVM 字样。第二条看垃圾收集器(JDK 9 以后):
$ java -XX:+PrintCommandLineFlags -version 2>&1 | tr " " "\n" | grep -i gc -XX:+UseG1GC
JDK 9 起 HotSpot 默认收集器是 G1——记住这个默认值,第五章讲收集器演化时你会明白它为什么取代了 Parallel。第三条验证 GraalVM 的 AOT 能力,用原生镜像工具把一个小程序编译成本地可执行文件,观察启动时间差距:
public class Warmup { public static void main(String[] args) { long start = System.nanoTime(); System.out.println("hello from jvm"); System.out.println("elapsed ms: " + (System.nanoTime() - start) / 1_000_000); } }
传统 JVM 上这个进程从拉起到打印大约要几十到几百毫秒(类加载、验证、JIT 预热都算在内);Native Image 编译出的二进制则能在个位数毫秒内完成同样的输出。差距的来源不是代码写得好不好,而是第四章要细讲的那套"运行时编译"被整个挪到了构建期。
⚠️ 常见坑:把"OpenJDK"当成与 HotSpot 并列的实现。OpenJDK 是源码项目与发行版名称,它的默认虚拟机就是 HotSpot;真正与 HotSpot 并列的是 OpenJ9 这类另一套引擎。混用这两个概念会在排错时找错文档。
💡 关键直觉:实现选型本质是在"预热预算"上做交换——HotSpot 预付运行期编译成本换峰值性能,GraalVM AOT 预付构建期成本换启动速度,OpenJ9 用更紧凑的结构同时压低两头。先想清楚你的进程能活多久,再谈选哪个。
要点回顾
- JVM 是规范品类:HotSpot、OpenJ9、GraalVM 是具体实现,参数、日志、工具链都绑定实现,排错第一步是确认身份;
- HotSpot 靠分层编译立足:解释执行保底、JIT 编译冲峰值,生态与工具链最全,是本册默认的解剖对象;
- OpenJ9 主打省内存:共享类缓存与紧凑布局适合短命小进程,峰值吞吐弱于调教好的 HotSpot;
- GraalVM 提供两条路:既可作 HotSpot 的高速编译器,也可用 Native Image 做 AOT,后者反射与动态代理需登记;
- 发行版不等于新引擎:Dragonwell、Corretto 等都是 HotSpot 内核的发行版,不要与 OpenJ9 混为一谈;
- 身份可用命令核实:java -version 看 VM 名字,PrintCommandLineFlags 看默认 GC,两条命令避免"开错处方"。
下一节我们看这些实现共同遵守的顶层文本——JVMS 规范,弄清"必须做什么"与"自由发挥"的边界划在哪里。