2.3 虚拟机栈与程序计数器:线程的私人工作台
2.3 虚拟机栈与程序计数器:线程的私人工作台
本节摘要:虚拟机栈与程序计数器是每根线程与生俱来的私有区域:栈上摞着方法调用的帧,程序计数器记着当前执行到哪条指令。本节拆开栈帧的内部结构,演示 StackOverflowError 的成因与调参思路,并说清本地方法栈与线程栈大小的真实约束。
前两节切的都是全体线程共享的区域,本节把视角切到"私人领地":每根线程出生时,JVM 就为它配好一套虚拟机栈与程序计数器。理解这套工作台有两件事值得立刻知道:其一,异常堆栈(Exception in thread main 那一长串)就是虚拟机栈在崩溃瞬间拍下的快照,本章教你看懂它的帧结构;其二,进程线程数上限、递归爆栈,全都受 -Xss 这一个参数管辖——第七章讲虚拟线程时,会回头清算这个参数在云原生时代的账。
栈上长什么样:一摞方法调用的帧
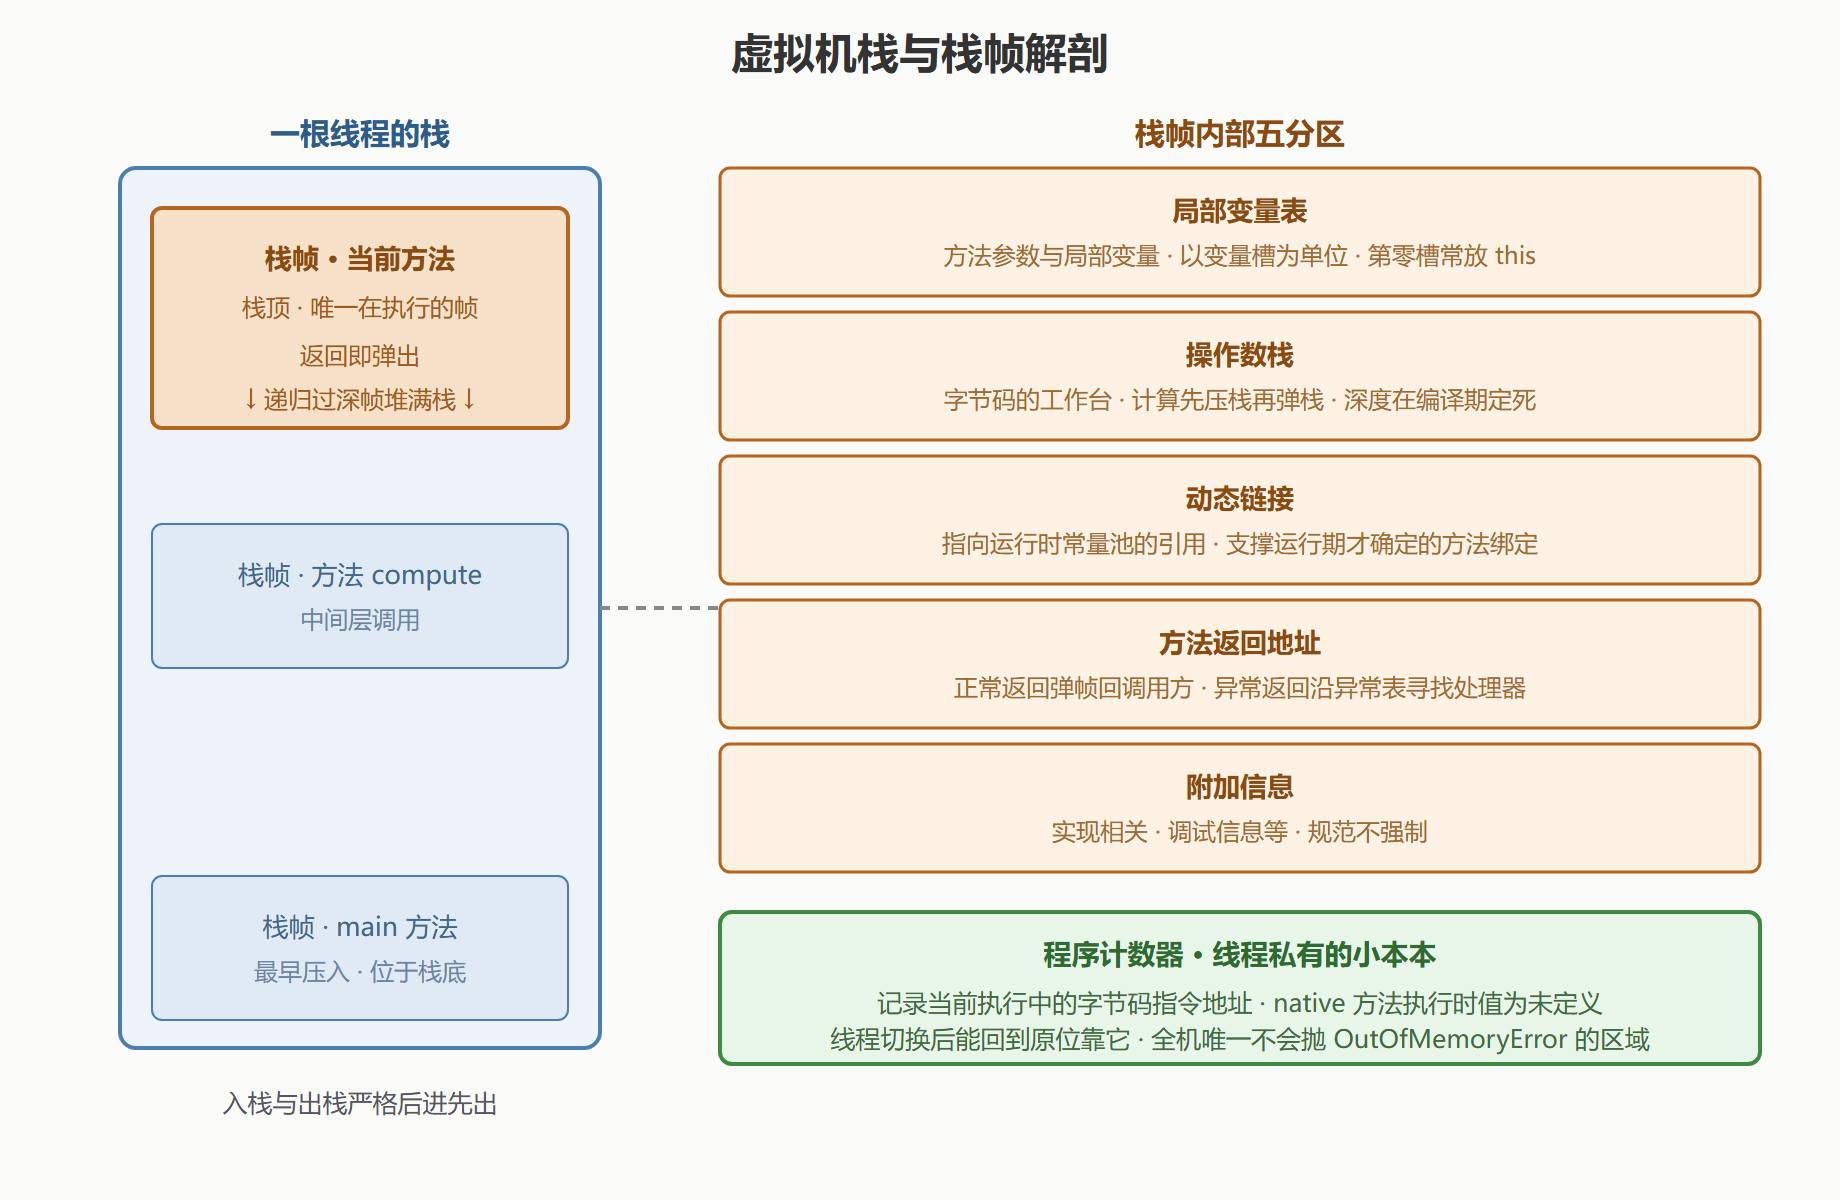
线程每调用一个方法,JVM 就往它的栈上压入一个栈帧;方法返回,帧弹出。栈里永远只有栈顶那一个帧在工作。每个帧内部分成五块,其中局部变量表和操作数栈是主角:
图 2-3:栈帧结构解剖图
看一个最小实例,把字节码与栈帧动作对上号。下面的方法算两个数之和:
public int add(int a, int b) { int sum = a + b; return sum; }
用 javap 看它的字节码(javap -c 类名):
public int add(int, int); Code: 0: iload_1 // 把局部变量表 1 号槽的 a 压入操作数栈 1: iload_2 // 把 2 号槽的 b 压入操作数栈 2: iadd // 弹出两个数相加,结果压回栈顶 3: istore_3 // 弹出栈顶结果,存入 3 号槽 sum 4: iload_3 // 把 sum 压栈,准备返回 5: ireturn // 返回栈顶 int,当前帧弹出
局部变量表第零号槽放的是 this(实例方法惯例),一、二号槽是参数 a 与 b,三号槽是局部变量 sum——j 与槽号的对应关系一目了然。操作数栈则是字节码的算术工作台:iload 压、iadd 弹两个压一个。这套"压弹"节奏在第四章讲指令集时是主角,这里先建立画面感。
StackOverflowError:栈被帧堆满的现场
栈的容量由 -Xss 设定(HotSpot 默认约一兆,平台与版本略有差异)。递归没有终止条件,或者递归深度过大,帧不断入栈,就撞出 StackOverflowError。亲手复现一次:
public class StackBreach { static int depth = 0; static void recurse() { depth++; recurse(); } public static void main(String[] args) { try { recurse(); } catch (StackOverflowError e) { System.out.println("max depth: " + depth); StackTraceElement[] st = e.getStackTrace(); System.out.println("stack trace frames: " + st.length); } } }
$ java -Xss256k StackBreach max depth: 2734 $ java -Xss1m StackBreach max depth: 10856
两个读数值得注意:栈容量扩到四倍,可承受的递归深度也大约翻到四倍——深度与容量成正比;捕获后 getStackTrace 返回的帧数是有限截断(默认至多一千零二十四帧),所以别指望从堆栈打印里看到完整的递归链。生产上的对应排查手法:看到 StackOverflowError,先看异常打印最底部重复的类与方法名,那就是真正的循环点——常见于 equals 或 hashCode 互调、对象 toString 循环引用、框架 AOP 代理自调用。
另一个实用冷知识:能开多少根线程,与每根线程的栈大小直接相关。粗略估算,进程剩余本地内存除以单线程栈容量就是线程数天花板。一千根线程各一兆栈,光栈就要吃掉一个 GB 上下——这就是线程数受限的算术根源,也是第七章虚拟线程"栈帧存堆上"设计要解决的核心痛点。
本地方法栈与程序计数器的两件小事
本地方法栈为 native 方法服务(JNI 调用进入的 C/C++ 世界)。HotSpot 的实现里它与虚拟机栈合二为一,-Xss 一并约束,所以日常排查无需单独考虑它;但个别实现是分开的,读其他厂商文档时留意措辞差异。
程序计数器是全机器最不起眼又必不可少的部件:它只记录"当前线程执行到字节码第几条指令"。没有它,线程被 CPU 切走再切回来就找不到断点——并发场景下每根线程都要独立计数,这正是它必须线程私有的原因。执行 native 方法时它记不了字节码地址,值定义为未定义。它也是规范明文保证不会抛 OutOfMemoryError 的唯一区域。
⚠️ 常见坑:把 -Xss 调大当作万能解法。栈溢出若是递归失控,调大参数只是让进程多撑几秒,随后可能在更深处溢出,甚至因栈变大而压低了可用线程总数。正确次序是:先定位循环调用点修代码,确认是"合法深递归"(如超深树遍历)才考虑加栈,或改写成显式栈结构的迭代实现。
💡 关键直觉:栈是"方法执行"这个抽象的物理载体。看懂栈帧,异常堆栈、方法调用开销、线程内存占用、尾递归为什么不被 JVM 优化,这些分散的知识点就串成了一条线。
要点回顾
- 栈与程序计数器线程私有:随线程创建而生、随线程销亡而灭,无需 GC;
- 栈帧五分区:局部变量表、操作数栈、动态链接、返回地址、附加信息,前两者承担计算;
- 栈容量由 -Xss 决定:深度与容量成正比,默认约一兆;线程总数受"剩余内存除以栈大小"约束;
- 溢出排查看重复帧:StackOverflowError 打印里重复出现的类与方法即循环点;
- 本地方法栈服务 native 调用:HotSpot 中与虚拟机栈合并实现;
- 程序计数器记断点:线程切换恢复的锚点,native 执行时值未定义,唯一保证不 OOM 的区域。
线程私有的两块小切片看完,下一节补上共享区外的最后一块拼图:直接内存。它不在规范描述的运行时数据区清单里,却是 NIO 高性能读写与堆外缓存的真正舞台,也是容器内存事故里最常被漏算的一笔账。