4.2 解释器与 JIT:分层编译的热点晋升
4.2 解释器与 JIT:分层编译的热点晋升
本节摘要:HotSpot 用混合模式平衡"立即能跑"与"跑得快":解释器零延迟起步,计数器捕获热点,C1 快速出活,C2 深度优化,假设破产时去优化回退。本节沿分层编译的晋升路径逐层讲解,用编译日志实证整条链,并把内联与逃逸分析这两项最值钱的优化讲到能对上自己的代码。
第一章说过 HotSpot 名字的由来就是"热点",本节把这四个字拆到机器级。为什么默认不是"全量编译"?启动时把全部方法编译一遍,一个小应用也要多等数秒;为什么默认不是"纯解释"?峰值性能差出一个数量级。混合模式的答案:让解释器立刻开工,同时给每段代码记流水账,谁跑得勤就把谁送进编译流水线——用最贵的编译资源只伺候最值的代码。
分层编译:五层阶梯的晋升游戏
现代 HotSpot 默认开启分层编译(JDK 8 起服务端模式默认),编译层级从零到四:
图 4-1:分层编译晋升阶梯与回退通道
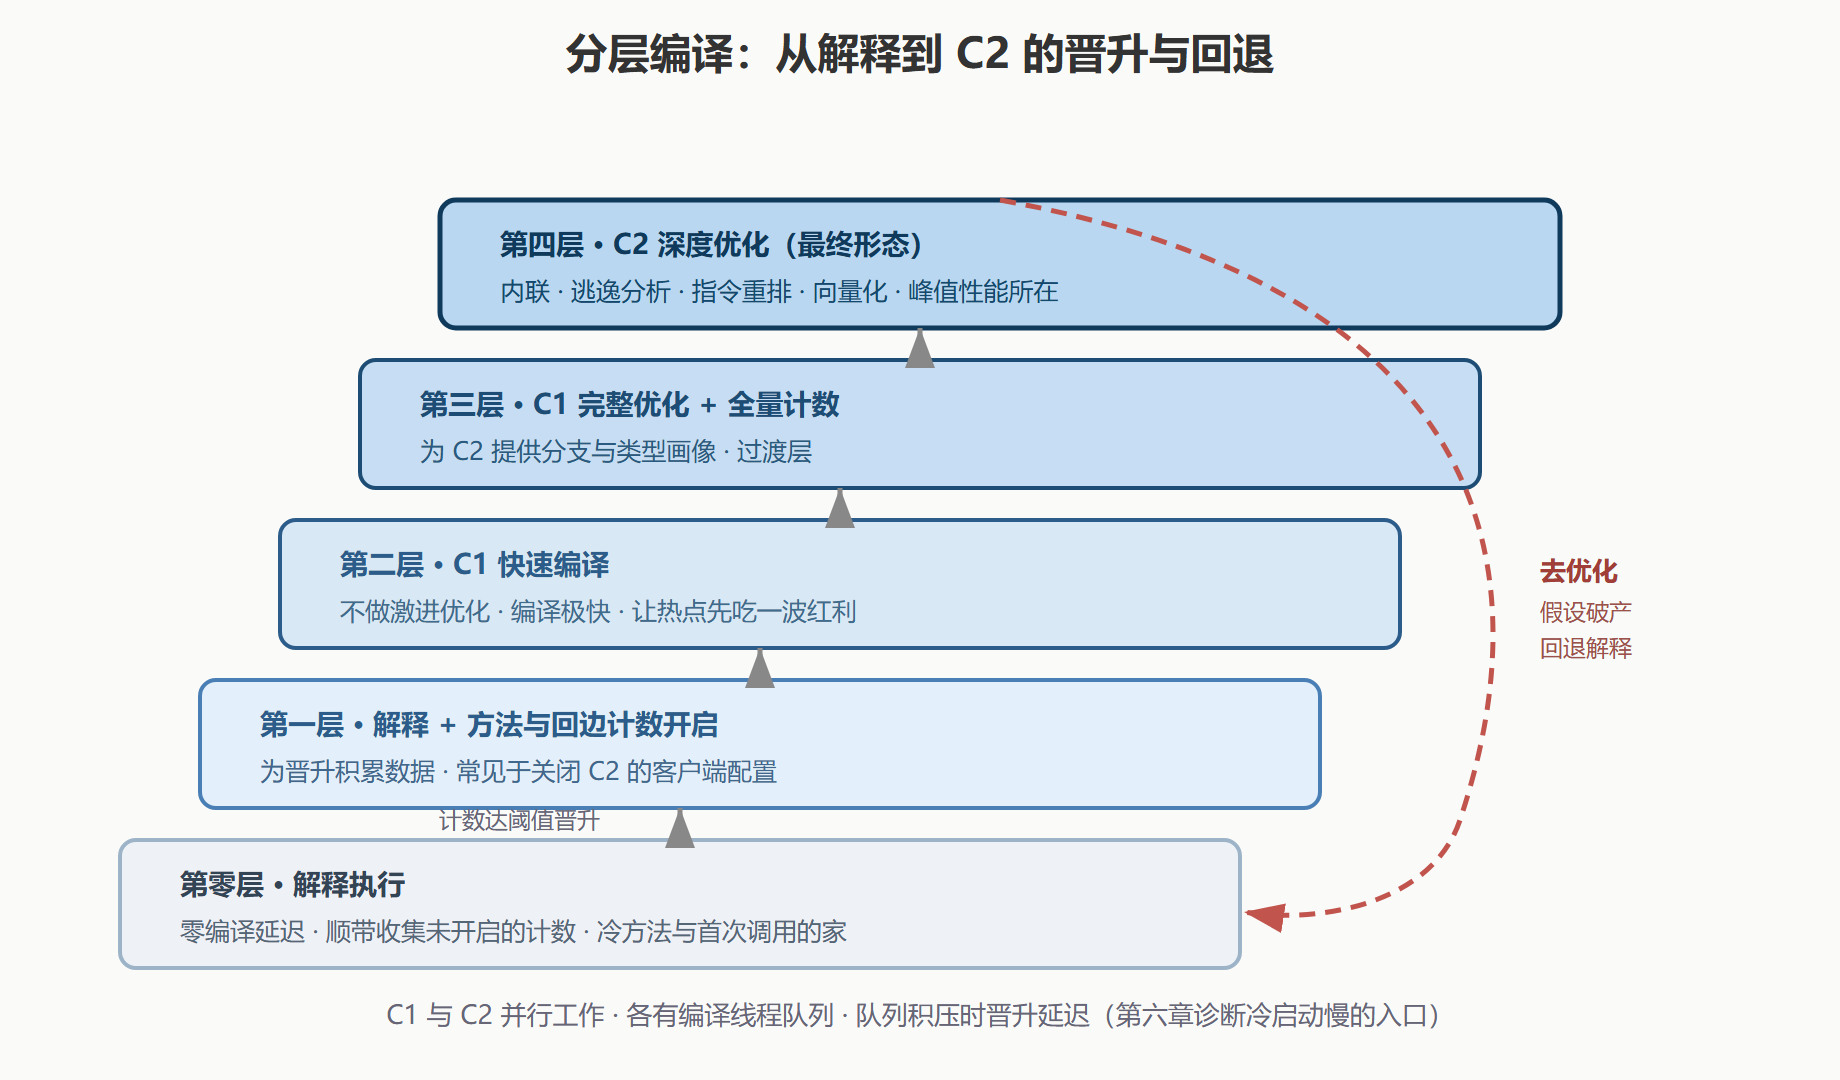
晋升由两台计数器驱动:方法调用计数器记录方法被调次数,回边计数器记录循环回跳次数(对应 4.1 那个 goto 拼出的环)。阈值达到,方法或"正在执行中的循环"进入编译队列(OSR,栈上替换,让长循环不等下一次调用就能换上编译版)。C1 与 C2 是两级编译器:C1 出手快、优化浅,让热点先吃到第一波红利;C2 出手慢、优化深,内联、逃逸分析、向量化全在这一层。中间的第二、三层兼顾两头,还顺手为 C2 收集类型与分支画像。
用编译日志实证晋升
一段代码 + 一份日志,把上面的机制变成可见的事实:
public class TierDemo { static long compute(int rounds) { long sum = 0; for (int i = 0; i < rounds; i++) { sum += i * 31; } return sum; } public static void main(String[] args) { for (int i = 0; i < 200_000; i++) { compute(1000); } System.out.println(compute(10)); } }
$ java -XX:+PrintCompilation TierDemo 2>&1 | head -n 12 129 77 3 TierDemo::compute (22 bytes) 129 79 4 TierDemo::compute (22 bytes) 130 78 3 java.lang.invoke.MethodHandle::invokeBasic (0 bytes) ...
日志列从左到右:时间戳、编译任务号、层级、方法。TierDemo::compute 先后以层级三、层级四被编译——正是阶梯图中"C1 带画像、再晋升 C2"的实拍。层级数字后面的标记也有讲究:% 表示 OSR(栈上替换,长循环的编译替换)、n 表示 native 方法、s 表示 synchronized。第六章诊断"服务预热慢"时,这份日志配合时间戳就能回答"哪些方法在拖编译的后腿"。
参数层面有两个常用闸门:-XX:CompileThreshold 直接指定方法晋升的调用次数(关闭分层编译时生效,典型实验值一万);-XX:-TieredCompilation 关掉分层只用 C2。做性能实验时先打印这两项确认当前策略,再对比数据,别拿不同配置的机器互相比较。
两项最值钱的优化
C2 的优化清单很长,但两项与业务代码关系最直接。
内联(Inlining):把被调方法的方法体复制进调用点,消除调用开销。它被称为"优化之母",因为内联之后,原本横跨多个方法的代码才能被整体分析与重排。小方法、热点路径上的方法、final 或私有方法最容易被内联;方法体太大(默认超过若干字节码条数)则被拒绝。这也是"小方法优先"这条编码习惯在性能上的真实依据——不是为了可读性,而是为了可内联性。验证手段:加 -XX:+PrintInlining(配合 UnlockDiagnosticVMOptions)能看到每个调用点内联成功或失败的原因。
逃逸分析(Escape Analysis):分析对象的作用域是否逃出方法或线程。没有逃逸的对象可以被"标量替换"——对象根本不创建,成员变量直接拆成局部变量放在栈或寄存器里;线程局部且不逃逸的锁可以消除(第七章锁优化再展开)。这意味着某些你以为在堆上分配的对象,运行期根本不存在。典型受益写法:方法内部 new 的局部对象没有作为返回值、没有被存进外部集合、没有被传给无法内联的方法。
去优化(Deoptimization)是这套体系的保险丝:C2 的激进优化建立在"未来与过去一致"的假设上——这个引用在运行期只会是已见过的子类、这个分支从未走过。一旦假设被打破(比如动态加载了一个新的子类),编译码作废,执行回退到解释器重新收集画像,等待再次晋升。-XX:+PrintCompilation 输出里出现 made not entrant 字样,就是某段编译码被宣布退役的时刻。极端场景:一个高频多态调用点后来不断出现新类型,会陷入"编译、去优化、再编译"的抖动,这在 4.3 与第六章的案例里还会遇到。
⚠️ 常见坑:拿微基准测"优化后比优化前快多少",却在测量前没有预热——解释执行与 C2 编译执行可以差出十倍以上,没预热的对比是噪音对比。正经微基准要预热多轮、或直接用 JMH 框架(它替你处理预热与编译稳定性)。第六章 6.2 的 JFR 也能帮你在真实服务里区分"没预热"与"真退化"。
💡 关键直觉:JIT 优化奖励"稳定的代码"。类型稳定、分支稳定、方法小而热,收益就大;到处反射、动态生成、深继承多态,画像不断作废,编译器只能保守。所谓"写得规矩跑得快",机制根源就在这里。
要点回顾
- 混合模式是折中:解释器零延迟起步,计数器选热点送编译,编译资源只花在刀刃上;
- 五层阶梯:解释、计数、C1 快、C1 全、C2 深,方法调用与回边两台计数器驱动晋升;
- OSR 处理长循环:栈上替换让执行中的循环不等下次调用就换编译码;
- 编译日志是实证工具:PrintCompilation 看层级与时机,made not entrant 看退役;
- 内联与逃逸分析最值钱:小而热的方法易内联,不逃逸的对象可整体消失;
- 去优化是保险丝:假设破产回退解释,多态抖动场景会反复编译。
执行引擎的主干到此讲完。下一节换个开局:如果干脆不做运行期编译,构建时就把字节码变成机器码,会得到什么、失去什么——Graal 编译器与 AOT 的取舍清单。