5.3 收集器巡礼:从 Serial 到 ZGC
5.3 收集器巡礼:从 Serial 到 ZGC
本节摘要:二十多年的收集器演化有清晰的主线:Serial 单线程起点,Parallel 押注吞吐,CMS 开辟并发低停顿路线,G1 用 Region 化给出可预期的停顿,ZGC 与 Shenandoah 把停顿压进亚毫秒。本节沿这条主线讲每代解决谁的什么病,收束到一条默认选择规则与一张选型对照。
原理备齐(判定标准、三种术式),本节看它们在二十多年里被怎样组合。读这一节像读病史:每一代收集器都是对上一代某个具体病症的手术方案,没有凭空出现的"更强"。理解了病症与方案的对应,参数手册上那一排 UseXXGC 开关就从记忆负担变成了选择题。
演化主线:两条轴上的接力
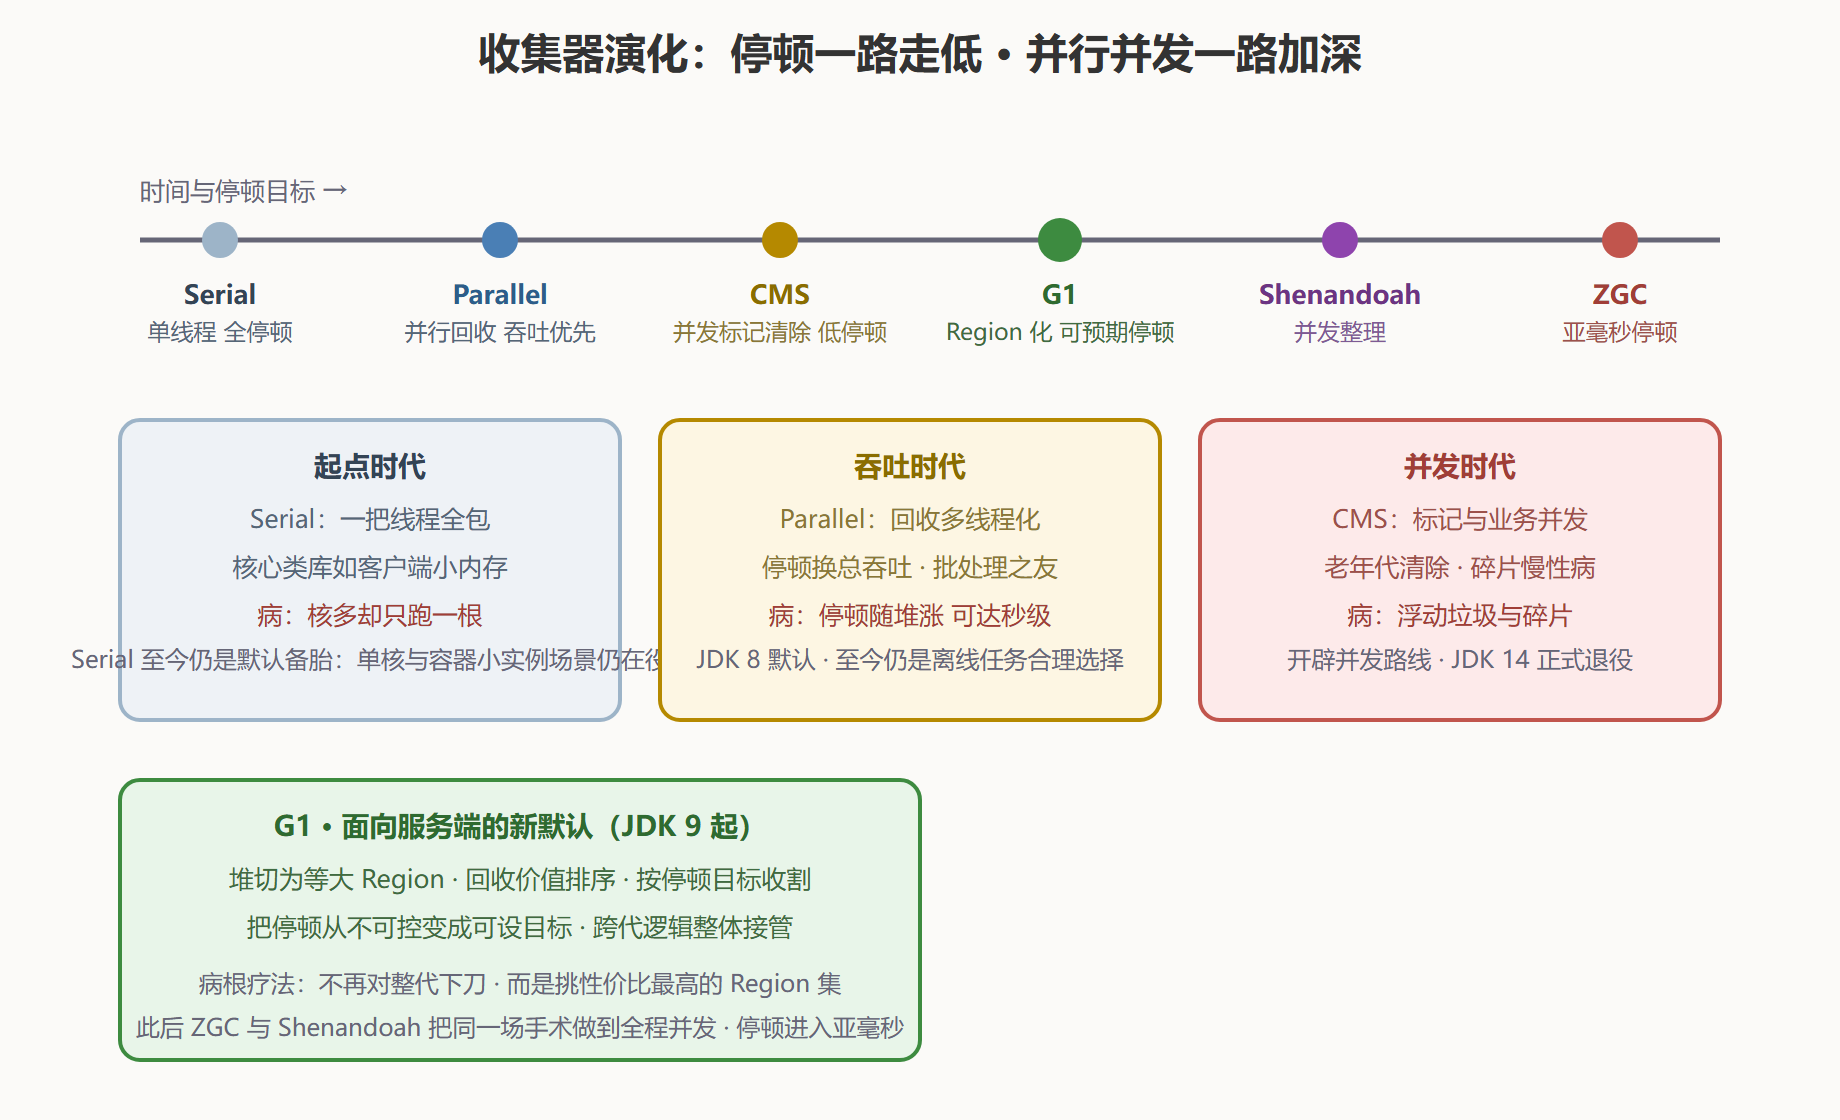
图 5-2:收集器演化时间线(按停顿目标演进)
各代收集器的手术方案
Serial:单线程完成全部回收,全程停顿。今天它仍有三个正当岗位——客户端小内存应用、单核容器、以及作为 Serial GC 供 Native Image 使用。看懂它是理解一切的原点:并行化与并发化都是围绕它的增量改造。
Parallel(ParNew 与 Parallel Scavenge 一族):把回收工作并行到多核,停顿缩短,总吞吐最大化。它不追求停顿目标,追求"单位时间里 GC 占用越少越好"。JDK 8 的默认组合就是它,批处理、离线计算这类"停顿无所谓、总时长敏感"的负载今天依然该选它。
CMS:历史转折点。它把老年代回收中最耗时的标记工作与业务线程并发执行,只在极短的两个阶段停顿。低停顿路线由此开辟,但三项先天代价也如影随形:标记期间业务还在制造新的死对象(浮动垃圾),并发抢占业务 CPU,清除术留下碎片需要周期性整理兜底。JDK 9 弃用、JDK 14 移除,它的并发思想由后人继承。
G1:面向大堆服务端的再设计。堆被切成两千个左右等大 Region,各 Region 逻辑上归属 Eden、Survivor 或老年代,回收时按"垃圾占比性价比"排序,优先收割收益最高的 Region 集——停顿第一次变成可设目标(默认约两百毫秒,-XX:MaxGCPauseMillis)。JDK 9 起成为服务端默认,如今绝大多数新服务默认就在 G1 上。跨 Region 引用靠记忆集维护,代价是更高的内存与写屏障开销,小堆上不划算。
ZGC 与 Shenandoah:把整理也并发化的极低停顿路线。ZGC 用着色指针让引用自描述搬运状态,配合读屏障完成并发 relocate——停顿与堆大小基本解耦,TB 级堆也能保持亚毫秒级停顿。JDK 15 正式转正,JDK 21 引入分代 ZGC(吞吐大幅改善,此前不分代正是其吞吐短板)。Shenandoah 走转发指针路线达成类似目标,随 OpenJDK 的 Red Hat 分支演进。两者都是"停顿极低、吞吐略让"的取向。
G1 实操三件事:目标、巨对象与失败标记
既然 G1 是多数服务的默认引擎,它的三个实操细节值得多看一眼,都是日志里高频出现的角色。
停顿目标别设到离谱。MaxGCPauseMillis 默认两百毫秒上下,有人追求极致把它压到十毫秒以下——G1 会顺从地把年轻代尺寸砍小,回收频率随之暴涨、总吞吐反而塌方。目标的正确用法是按业务 SLA 倒推:接口尾延迟预算若为几十毫秒,GC 预算给到二十毫秒量级,设完观察一周日志再校准,而不是一步压到底。
巨对象是 G1 特有的雷。超过 Region 一半大小的对象被标记为巨对象(Humongous),直接进入老年代并连续占用整数个 Region。日志里 "Humongous regions" 常态偏高,说明有代码在批量制造大数组与大集合——这属于 6.3 病案二的分支,处方是改分配结构(分块、流式、缩对象),而不是调收集器。
失败标记要背熟。"to-space exhausted" 与 "Evacuation Failure" 出现,说明搬运时腾不出空间、回收被迫就地失败,G1 退化为类全停顿模式硬扛。这几乎总指向堆余量不足或晋升过快,先加内存或压分配速率,微调停顿目标是药不对症。这些标记与 5.4 的三条曲线联合判读,G1 的健康度一目了然。
默认选择规则与选型对照
把家族史收束成可执行的决策,多数团队只需要这几条:新服务、通用场景,默认 G1 不折腾(它成为默认本身就是大量生产验证的结果);吞吐敏感的批处理离线任务,Parallel;堆很大(比如超过若干 GB)且对停顿敏感的在线服务,上 ZGC(优先分代 ZGC),并用 5.4 的日志方法验证停顿确实达标;小容器小内存,Serial 甚至都是合理候选,G1 反而臃肿。
| 收集器 | 停顿 | 吞吐 | 适用堆 | 现役状态与定位 |
|---|---|---|---|---|
| Serial | 长 | 低 | 极小 | 在役,单核与小容器 |
| Parallel | 长(并行缩短) | 最高 | 中大 | 在役,批处理离线首选 |
| CMS | 中 | 中 | 中 | 已退役,只作历史参照 |
| G1 | 可预期(百毫秒级) | 高 | 中到很大 | 默认,通用服务端 |
| ZGC | 亚毫秒 | 高(分代后) | 大到 TB | 在役,低停顿大堆 |
⚠️ 常见坑:给小堆强上 ZGC。低停顿设计有固定开销(屏障、并发线程、内存开销),几 GB 以下的小堆收益有限;先确认停顿确实是当前瓶颈(用 5.4 的日志量化),再谈换收集器。
⚠️ 常见坑:跨版本沿用收集器参数。CMS 参数在 G1/ZGC 上无效甚至告警,G1 的调参经验也不能平移到 ZGC——ZGC 的推荐姿势恰恰是"少调参,给够内存"。每换一次收集器,参数体系重新校准一遍。
💡 关键直觉:收集器选择本质是"停顿与吞吐的汇率先兑"。同一套三术式原理下,各代产品的差异就是把哪笔账记在谁头上。先量化自己业务的停顿预算与吞吐底线,再对照这张表选——顺序反了就全是玄学。
要点回顾
- 演化主线:Serial 单线程 → Parallel 吞吐 → CMS 并发低停顿 → G1 可预期停顿 → ZGC 亚毫秒;
- CMS 功过:开辟并发标记路线,但浮动垃圾、抢占与碎片致命,已退役;
- G1 的核心思想:Region 化加性价比排序,停顿变成可设目标,JDK 9 起默认;
- ZGC 一族:并发整理让停顿与堆大小解耦,分代 ZGC 补齐吞吐短板;
- 默认规则:通用默认 G1,批处理 Parallel,大堆低停顿 ZGC,小容器不必追新;
- 换收集器即重校参数:跨家族参数不可平移,先量化停顿与吞吐再动手。
家族史读完,本单元还剩最实用的一步:怎么从滚动的 GC 日志里读出以上一切——收集器类型、健康度、病灶位置。下一节全部在真实日志上过招。