6.3 四类典型病灶:泄漏、抖频 GC、锁竞争与 CPU 飙升
6.3 四类典型病灶:泄漏、抖频 GC、锁竞争与 CPU 飙升
本节摘要:四类高频病灶各有一条标准诊断路径:泄漏看回收后谷底加直方图两期对比,GC 风暴看频率与净收益背离,锁竞争看 BLOCKED 聚集与死锁检测,CPU 飙升用线程号对号入座找热点栈。本节每条病案从症状走到凶手,一步不跳,末尾以一次 OOM 事故的完整复盘收束全章。
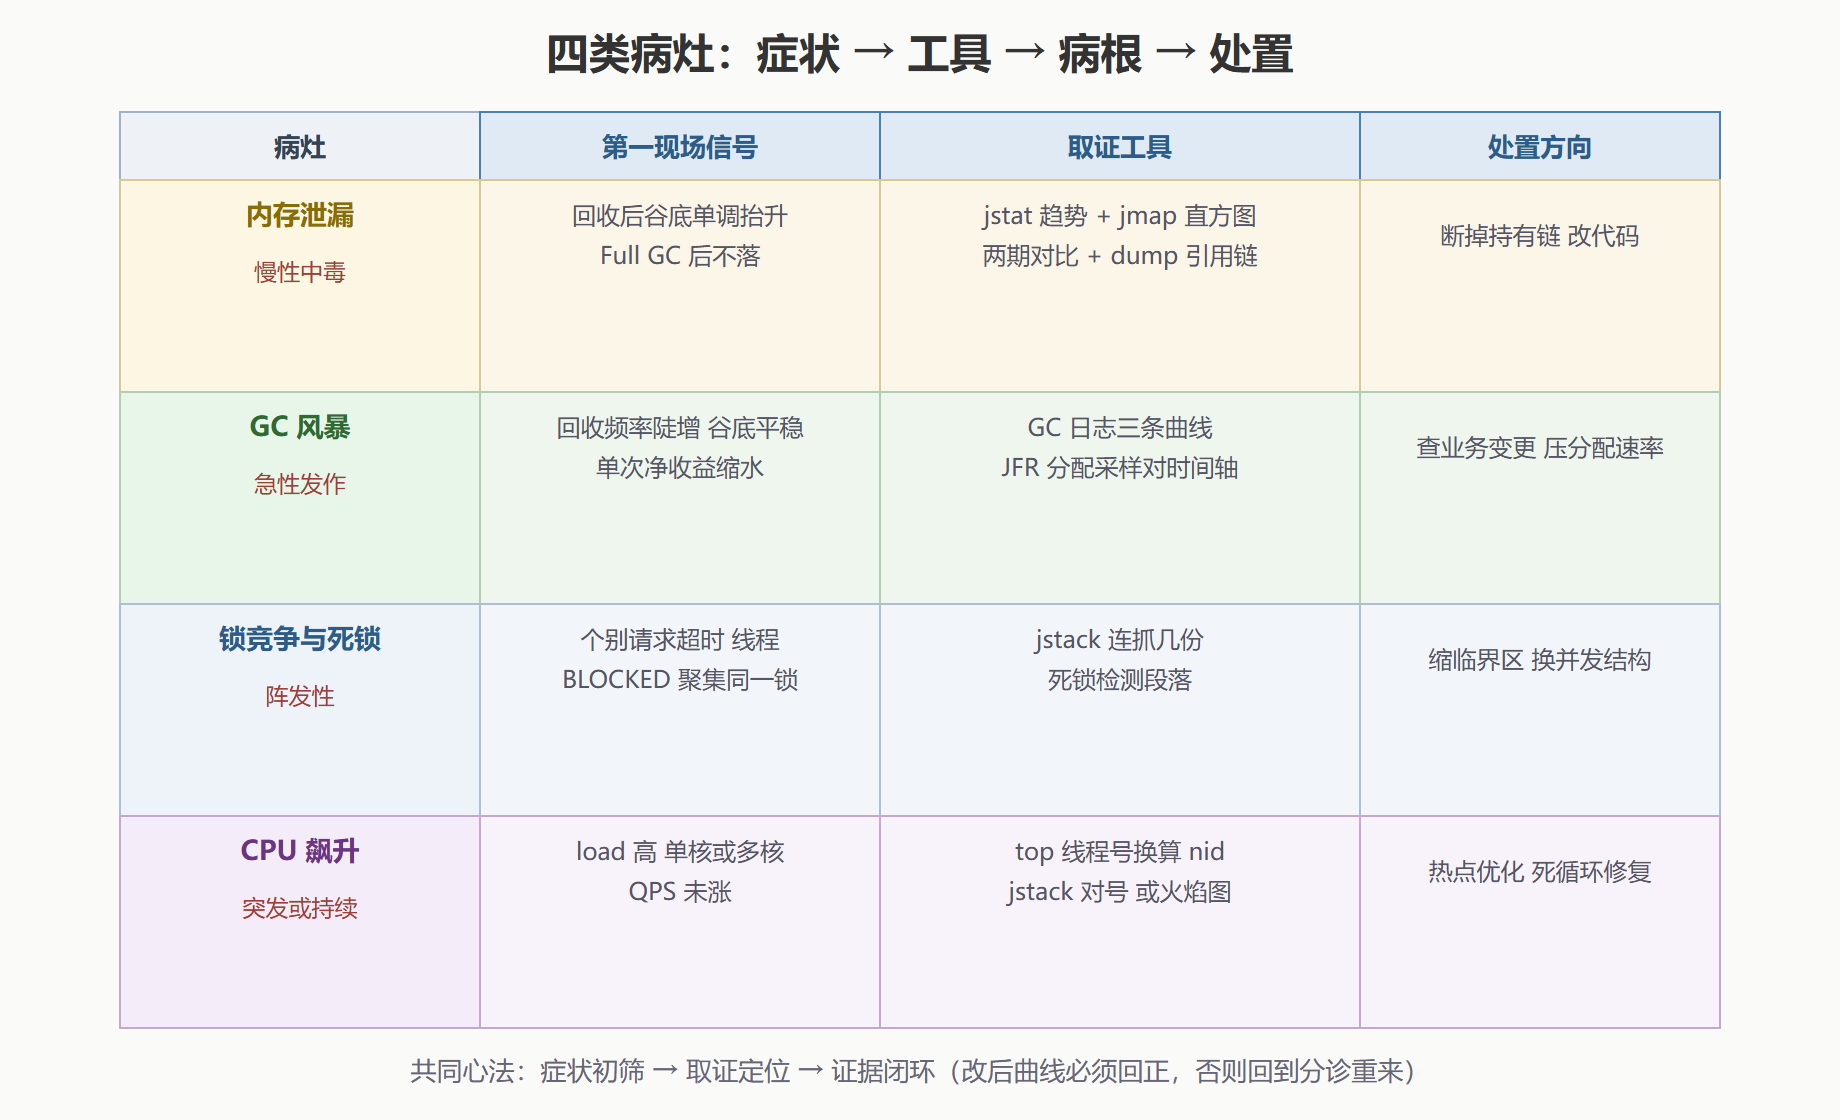
前两节把工具备齐,本节进入临床。四条路径的共同心法是"症状初筛、取证定位、验证闭环":先用现象把范围切到四类之一,再用对应工具取证,最后一定要让证据闭环——改了之后曲线必须回正,否则回到分诊重新来。先给一张总览对照,然后逐条病案展开。
图 6-1:症状、工具与病灶对照矩阵
病案一:内存泄漏(慢性中毒)
症状:服务内存水位每周缓慢抬升一次 Full GC 后的水位线,最终一天凌晨 OOM 重启。取证按两步。第一步 jstat 确认趋势(-gcutil 采样观察 O 列,每次回收后的值只升不降);第二步 jmap 直方图两期对比:
$ jmap -histo 29104 | grep "com.demo" > h1.txt (三小时后) $ jmap -histo 29104 | grep "com.demo" > h2.txt $ diff h1.txt h2.txt 87: 184122 7364888 com.demo.rule.RuleContext 87: 902377 36095080 com.demo.rule.RuleContext ← 三小时净涨约七十万实例
RuleContext 实例只进不出。dump 后在 MAT 里查它的引用链,GC Roots 指向一个静态注册表——规则引擎每次执行都注册上下文、处理完不注销。凶手是持有链,不是"对象太多"。修复:执行完反注册或改用弱键映射(第五章引用强度知识的直接应用)。闭环验证:修后再看 jstat 谷底曲线走平。
病案二:GC 风暴(急性发作)
症状:发版次日请求毛刺增多,监控 GC 频率翻倍。第五章病案二的结论直接复用:频率升而谷底平稳,是分配速率异常而非泄漏。取证用 JFR 分配采样对时间轴(6.2 的第三步):锁定毛刺时段,看 ObjectAllocationSample 的类分布——那天的元凶是日志框架:新代码把大对象拼进日志字符串,级别关闭后仍执行了拼接,海量临时字符串制造了分配海啸。修复是改占位符式日志调用。教训同步记下:分配风暴的第一嫌疑永远是"最近的业务变更",而不是 GC 参数。
病案三:锁竞争与死锁(阵发性)
症状:个别请求超时,QPS 不高时也偶发;线程数看着正常。取证连抓几份 jstack:
$ for i in 1 2 3; do jstack 29104 > stack_$i.txt; sleep 3; done $ grep -A3 BLOCKED stack_1.txt | head -n 16 "http-nio-8080-exec-9" ... BLOCKED (on object monitor) at com.demo.cache.LocalCache.get(LocalCache.java:57) - waiting to lock <0x000000076ab62208> (a com.demo.cache.LocalCache) "http-nio-8080-exec-4" ... BLOCKED (on object monitor) at com.demo.cache.LocalCache.get(LocalCache.java:57) - waiting to lock <0x000000076ab62208> (a com.demo.cache.LocalCache)
多根线程 BLOCKED 在同一地址(0x76ab62208)——本地缓存的方法用 synchronized 包住了整个读路径,锁粒度是整个实例。若文件末尾出现 "Found one Java-level deadlock",两把锁的循环等待环会直接打印出来,连推断都省了。修复按粒度排序:缩临界区(只同步读回源那段)、换并发结构(ConcurrentHashMap 的分段思想)、热点场景用读锁分离。第七章讲完锁升级原理后,你会明白为什么"更少的时间持锁"永远优先于"更细的锁对象"。
病案四:CPU 飙升(突发或持续)
症状:load 飙到核数的数倍,QPS 没涨。Linux 上四步对号法:
$ top -Hp 29104 # 找出吃 CPU 的线程号,如 29177 $ printf "%x\n" 29177 # 十六进制换算 → 71f9 $ jstack 29104 | grep -A 15 "nid=0x71f9" "http-nio-8080-exec-3" ... RUNNABLE at com.demo.util.Patterns.isValid(Patterns.java:31) at com.demo.rule.RuleEngine.eval(RuleEngine.java:88)
top -Hp 列出进程内各线程的 CPU;线程号转十六进制(Java 栈里的 nid 字段就是十六进制线程号);jstack 按 nid 找到对应栈。上面这例的真凶是正则回溯:某个新加的模式串在特定输入下灾难性回溯,RUNNABLE 的高 CPU 栈正落在 Pattern 匹配上。多线程都压在同一段,或者想看整体分布,用 Async-Profiler 的 CPU 火焰图一图收齐。修完后 CPU 曲线回正即闭环。
收束:一次 OOM 事故的完整复盘
把四条路径串起来演一遍真实时序。某服务凌晨三点 OOM 重启,值班只留下一句 "OutOfMemoryError: Java heap space"。复盘顺序:先看监控确认是慢涨还是突涨(慢涨走病案一,突涨走病案二)——该例是数日内缓慢爬升,且事故前夜 Full GC 后水位仍居高位,锁定泄漏路线;回放 JFR 记录,分配采样里一个业务类持续高位;但因进程已死、没留下 dump,改从残留日志推断:OOM 前的最后一批日志显示一批特殊订单在反复重试,每次重试把失败上下文挂进一个静态列表。代码核查证实:重试逻辑注册后无注销,特殊订单格式又恰好永远失败。修复包含三件事:注销时机、失败上限、以及把"OOM 自动 dump"参数(-XX:+HeapDumpOnOutOfMemoryError)加进启动项——让下次事故自带现场。这个复盘的每一步都用了本章工具,而判定"该走哪条路"的依据,全在第五章的曲线知识里。
⚠️ 常见坑:在线上顺手就 dump 几个 GB 的堆。live dump 触发全停顿,大堆服务秒级暂停足以触发上游超时连锁。正确次序是:摘流量或选低峰、先直方图后 dump、确认目标盘空间。诊断动作本身必须比病灶温和。
💡 关键直觉:四类病灶对应四种"证据形状"——泄漏是单调趋势、风暴是频率与净收益背离、锁竞争是状态聚集、CPU 是栈热点。工具只是取证手段,先认出形状,才知道取什么证。
要点回顾
- 分诊心法:症状初筛四选一,对应取证路径,修复后必须曲线闭环;
- 泄漏路径:jstat 谷底抬升 → 直方图两期对比 → dump 引用链 → 断持有链;
- 风暴路径:日志频率与净收益背离 → JFR 分配采样 → 追业务变更压分配速率;
- 锁路径:jstack 连抓看 BLOCKED 聚集,死锁检测直接给环,修复优先缩临界区;
- CPU 路径:top -Hp → 线程号转十六进制 → jstack 对 nid,或火焰图整体定位;
- 复盘模板:判涨型、查工具记录、锁定业务诱因、修复加"下次自带现场"的自动 dump。
四条病案走完,最后一步是把诊断结果翻译成参数处方:内存给多少、收集器选哪个、容器里的账怎么算——下一节是处方学。