2.3 Context:进出层的公共通道
2.3 Context:进出层的公共通道
上一节钉死了层序,这一节看层与层之间传递的那个东西——ctx。每个请求进来时,内核创建一个全新的 Context,它既不是请求对象也不是响应对象,而是把两者连同应用实例、请求级状态一起封装成的"公共通道"。所有中间件共享这一个实例,你在层间传的一切信息都从这里过。
通道里装了什么
一个 Context 身上有五类成员,按使用频率排个序:
| 成员 | 来源 | 典型用途 |
|---|---|---|
| 请求快捷属性 | 委托自 request | ctx.url、ctx.method、ctx.query、ctx.headers |
| 响应快捷属性 | 委托自 response | ctx.body、ctx.status、ctx.set、ctx.type |
ctx.state |
空对象,Koa 预留 | 层间传数据:用户信息、请求 ID、计时起点 |
| 原生对象 | ctx.req、ctx.res |
Node 原生 request 与 response,应急时用 |
| 实例引用 | ctx.app |
拿到配置、触发应用事件 |
ctx.state 是官方预留的请求级暂存区,鉴权中间件解析完 token 把用户写进去、路由处理器读出来,这是它在全册最标准的用法:
// 鉴权层:进层阶段解析并写入 state app.use(async (ctx, next) => { const token = ctx.get('authorization').replace('Bearer ', ''); ctx.state.user = await verifyToken(token); // 解析失败会 throw,交给错误层 await next(); }); // 业务层:直接读 state,不关心 token 怎么来的 router.get('/me', async (ctx) => { ctx.body = { id: ctx.state.user.id, name: ctx.state.user.name }; });
用 ctx.state 而不是自己造全局变量,理由有两条:其一是请求隔离——state 跟着 Context 走,天然不会串请求;其二是可测试——单测里构造一个假 ctx、塞好 state 就能驱动任何一层,不需要真的发 HTTP 请求。
委托:为什么 ctx.url 等于 ctx.request.url
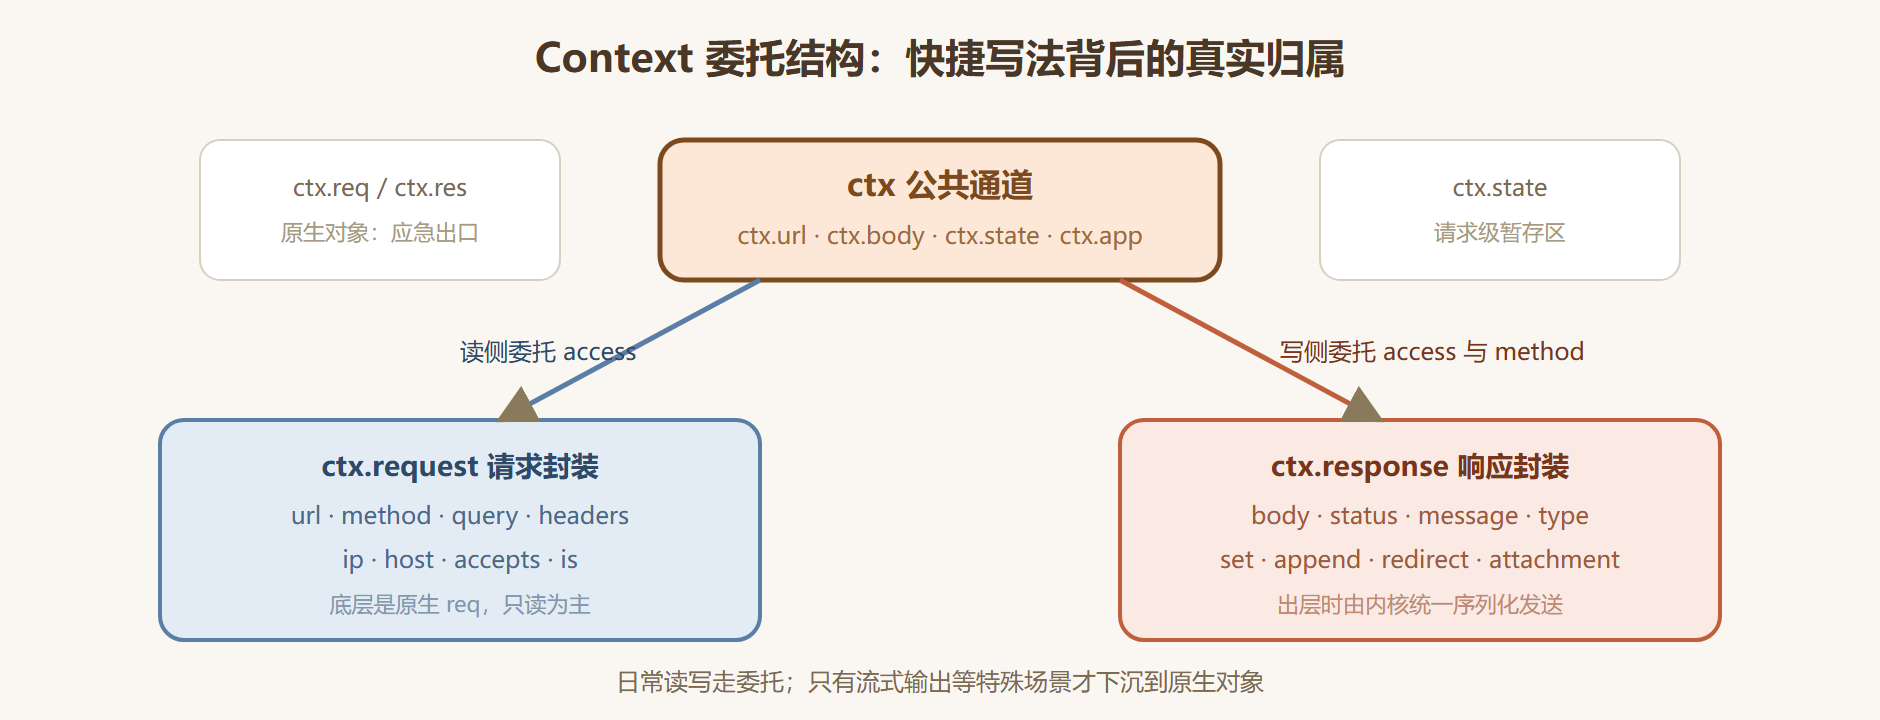
Context 上那批快捷属性不是复制粘贴来的,而是通过 getter/setter 委托实现的:访问 ctx.url 时,实际执行的是 ctx.request.url 的 getter;给 ctx.body 赋值,实际执行的是 ctx.response.body 的 setter。委托关系大致如下:
// 内核近似实现:把 request/response 的常用属性代理到 ctx 上 const delegate = require('delegates'); // Koa 实际使用的委托库 delegate(proto, 'request') .access('url') .access('method') .access('query'); delegate(proto, 'response') .access('body') .access('status') .method('set') .method('append');
委托分两档:access 同时代理读与写,method 代理函数调用。这层封装省掉的代码量相当可观——没有它,每个中间件里都是 ctx.response.set(...)、ctx.request.header.authorization 这样的长链式写法。
图 2-2:Context 的委托结构示意
应急出口:什么时候碰 ctx.req 与 ctx.res
委托覆盖了九成日常操作,剩下的一成需要下沉到原生对象,典型场景有两个。其一是流式输出:把文件流或数据库游标直接接到响应上,Koa 提供的写法是给 ctx.body 赋一个可读流,内核会负责 pipe;仅当需要精细控制(如自定义背压处理)时才操作 ctx.res。其二是绕过封装的极端优化,比如直接往 ctx.res 写头——这类代码能跑,但会破坏"出层统一发送"的约定,属于高风险动作。
// 推荐的流式输出:直接把可读流交给 body const fs = require('fs'); router.get('/download', async (ctx) => { ctx.set('Content-Type', 'application/octet-stream'); ctx.body = fs.createReadStream('./assets/report.pdf'); });
⚠️ 常见坑:在已经设置
ctx.body之后又去操作ctx.res(手动 end 或 write),会造成双重发送或响应截断。规则很简单:一次请求的生命周期里,要么全程走封装(ctx.body),要么全程走原生(自担责任),不要来回横跳。
通道的生命周期与安全边界
Context 与请求同生共死:请求结束,ctx 就不再被引用,理论上会被垃圾回收。但两个动作会让它"死不干净"。一是把 ctx 存进全局集合(比如塞进一个 Map 打算稍后处理)——它会连带把整个请求响应对象钉在内存里,请求量大时就是内存泄漏,第 8 章排查案例里有真实事故。二是把 ctx 直接传给异步日志回调后长期持有——日志库通常只需要几个字段,正确的做法是提取完就丢:
// 正确:提取需要的字段,不持有整个 ctx app.use(async (ctx, next) => { await next(); logger.info({ method: ctx.method, url: ctx.url, status: ctx.status, cost: Date.now() - ctx.state.start, }); // logger 异步落盘时只持有这个普通对象 });
还有一条安全边界要立住:不要信任 ctx 上的任何输入。ctx.query、ctx.params、ctx.request.body、甚至 ctx.headers,全部来自客户端,进入业务逻辑前必须校验(第 7 章整章讨论);ctx.get('x-forwarded-for') 这类头还可能是中间商伪造的,只有显式设置 app.proxy 并部署在可信代理之后才可当真。
本节要点回顾
- Context 是请求级单例通道:五类成员里,
ctx.state是层间传数据的标准位置; - 委托是语法糖:快捷属性背后是 request 与 response 的 getter/setter,理解委托才能理解异常行为;
- 流式输出走 body 赋值:可读流直接交给内核;碰
ctx.res是高风险应急动作,不许横跳; - 别让 ctx 死不干净:不进全局集合、不整体传给异步回调,日志只提取字段;
- 通道里的输入皆不可信:query、body、headers 进业务前必须校验。
内核三件套还剩最后一件:异常。请求在层间穿行时谁摔了跤、跤怎么摔到最外层、最外层怎么体面地收场——下一节把 Koa 的错误处理机制一次讲透。