3.3 自定义中间件模式与复用
3.3 自定义中间件模式与复用
上一节货架上的轮子覆盖不了贴业务的层——日志要按公司的格式落、限流要按自家产品的维度算。这一节把手艺从"写一个能跑的中间件"升级到"造一条可复用的中间件生产线":工厂函数封装配置、参数校验前置、依赖注入、多实例共存,最后用日志与限流两个完整实现收尾。本章主线任务(日志、鉴权、限流三层)在这一节完成过半。
从匿名函数到工厂:一次必然的重构
先看几乎所有人都会写的第一版日志中间件:
// 版本一:写死格式,全局唯一,无法定制 app.use(async (ctx, next) => { const start = Date.now(); await next(); console.log(`${ctx.method} ${ctx.url} ${ctx.status} ${Date.now() - start}ms`); });
能跑。但第二个服务要用同样逻辑、想换个格式、想跳过健康检查路径时,这二十行就得复制粘贴。重构方向只有一个——把中间件包进工厂函数,参数变成配置:
// 版本二:配置化工厂 function requestLogger(options = {}) { const { skip = (ctx) => ctx.url === '/health', // 默认跳过健康检查 format = (ctx, ms) => `${ctx.method} ${ctx.url} ${ctx.status} ${ms}ms`, log = console.log, // 日志函数可注入,测试时换成假实现 } = options; return async (ctx, next) => { const start = Date.now(); await next(); if (skip(ctx)) return; log(format(ctx, Date.now() - start)); }; } // 装配处所见即所得 app.use(requestLogger()); app.use(requestLogger({ skip: (ctx) => ctx.url.startsWith('/assets') }));
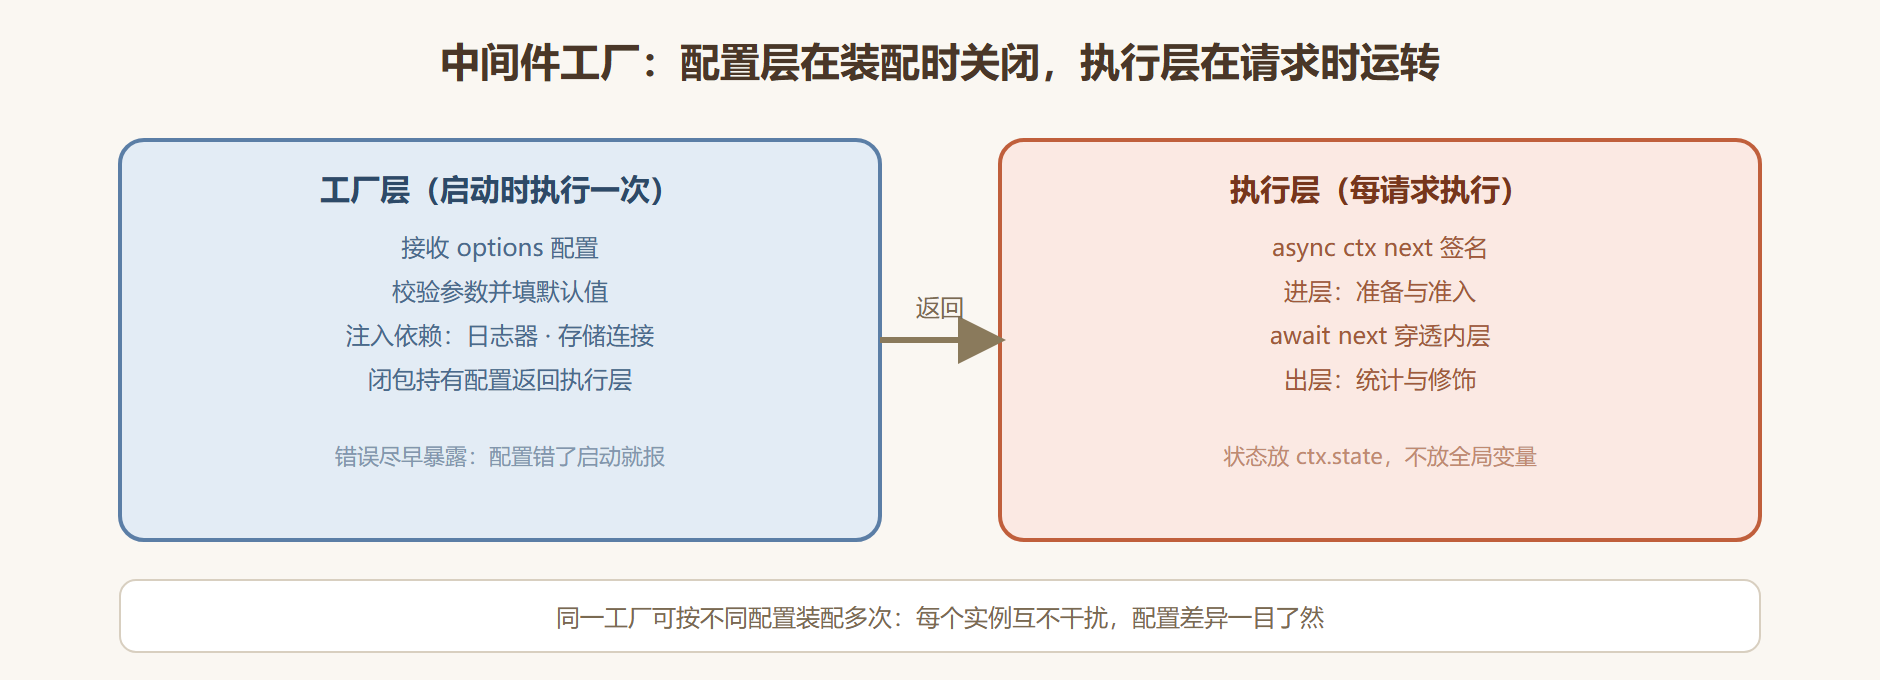
工厂模式带来三个直接收益:配置显式化(默认值就写在解构里,读装配代码就知道行为);依赖可注入(log 函数是参数,单测里传一个收集调用的假函数即可断言,不用 mock 模块);多实例共存(同一工厂按不同配置装配多次,互不干扰)。
图 3-1:中间件工厂的分层结构
配置校验要放在工厂里,不是请求里
工厂层在启动时执行一次,执行层每请求执行一次——能提前的检查必须在工厂里做完。参数类型不对、阈值填成负数,这类错误应该在进程启动时就崩出来,而不是等线上第一个请求触发:
function rateLimit(options = {}) { const { windowMs = 60_000, max = 100, keyGen = (ctx) => ctx.ip } = options; if (typeof max !== 'number' || max <= 0) { throw new Error(`rateLimit: max 必须是正整数,收到 ${max}`); // 启动即失败 } if (typeof keyGen !== 'function') { throw new Error('rateLimit: keyGen 必须是函数'); } // …工厂返回执行层的代码见下一节 }
这是把"配置错误"从事故降级为启动失败的关键一招。Koa 社区维护良好的中间件(如 bodyparser 的 enableTypes)都遵循这个模式——传错参数立刻抛错,绝不带病上线。
完整实现一:带窗口的限流层
把上面骨架补全,得到一个可用的固定窗口限流器。存储用内存 Map(单实例够用),key 生成器可配置(按 IP、按用户、按接口均可):
function rateLimit(options = {}) { const { windowMs = 60_000, max = 100, keyGen = (ctx) => ctx.ip } = options; if (!Number.isInteger(max) || max <= 0) throw new Error('max 必须为正整数'); const hits = new Map(); // key -> { count, resetAt } return async (ctx, next) => { const key = keyGen(ctx); const now = Date.now(); let bucket = hits.get(key); if (!bucket || now > bucket.resetAt) { bucket = { count: 0, resetAt: now + windowMs }; hits.set(key, bucket); } bucket.count += 1; // 响应头告诉客户端配额状态,好过让前端瞎猜 ctx.set('X-RateLimit-Limit', String(max)); ctx.set('X-RateLimit-Remaining', String(Math.max(0, max - bucket.count))); if (bucket.count > max) { const retry = Math.ceil((bucket.resetAt - now) / 1000); ctx.set('Retry-After', String(retry)); ctx.status = 429; ctx.body = { code: 'TOO_MANY_REQUESTS', message: `请求过密,${retry} 秒后重试` }; return; // 截停:限流命中不进内层 } await next(); }; } app.use(rateLimit({ windowMs: 60_000, max: 300 })); // 全局兜底 app.use(rateLimit({ keyGen: (ctx) => `login:${ctx.ip}`, max: 5, // 登录接口单独收紧 windowMs: 300_000 }));
两个实现细节来自踩坑:其一,命中限流后必须设置响应再截停,裸 429 没有 Retry-After 会让客户端立刻重试形成风暴;其二,内存 Map 只适合单实例——多实例部署时每个进程各算各的,配额变成"每进程配额",那时要把存储换成 Redis(接口不变,工厂的依赖注入正好派上用场)。
完整实现二:结构化日志层
第 2 章的日志层输出的是人读的一行文本;生产环境要的是机器可检索的结构化日志。升级版把格式决策交给注入的日志器,中间件只负责采集事实:
function accessLogger({ logger, skip = () => false } = {}) { if (!logger) throw new Error('accessLogger: 必须注入 logger'); return async (ctx, next) => { const start = process.hrtime.bigint(); // 高精度计时 try { await next(); } finally { if (skip(ctx)) return; const ms = Number(process.hrtime.bigint() - start) / 1e6; logger.info({ // JSON 结构,落 ELK 或日志平台 type: 'access', method: ctx.method, url: ctx.url, status: ctx.status, costMs: Math.round(ms), userId: ctx.state.user && ctx.state.user.id, reqId: ctx.state.reqId, }); } }; }
注意 try/finally 的用法:请求哪怕被内层异常打断(异常继续向上冒泡),日志也要落——finally 保证这一点,而异常本身不受影响。这是 3.1 节包裹型形态的直接应用。
复用的最小规范
层要复用,光有工厂不够,还得有规范。给团队的四条底线:命名统一(文件名即层名,导出唯一的工厂函数);配置即文档(每个 option 写清类型、默认值、效果,JSDoc 注释就够);行为有测试(至少覆盖截停、放行、异常三条路径,参照 3.1 节的测法);入口只装配(层的实现放独立模块,app.js 里只出现 use 加配置,装配顺序一目了然)。满足这四条的层,从一个项目搬进公共库、再搬进另一个项目的成本,不超过复制一个文件。
⚠️ 常见坑:把业务逻辑写进通用层。日志层里判断"这个用户是 VIP 就不打日志",三个月后这个层就没人敢动了。通用层只认通用事实(路径、状态、耗时),业务判断留在业务层——层的复用性与它的"业务绝缘度"成正比。
本节要点回顾
- 工厂函数是标准形态:配置显式、依赖可注入、多实例共存,比匿名函数多一层"设计";
- 校验在工厂不在请求:配置错误启动即崩,绝不带病上线;
- 限流层两个细节:响应头通告配额、命中必须带 Retry-After;内存存储只管单实例;
- 日志层用 try/finally:异常路径也要落日志,采集事实不掺业务判断;
- 复用四条底线:统一命名、配置即文档、行为有测试、入口只装配。
层造出来了,但同样的层换个位置装配,行为可能完全不同——下一节专治"顺序玄学",用可复现的实验把层序对行为与性能的影响钉死。