9.2 提速改造:缓存与性能优化
9.2 提速改造:缓存与性能优化
本节摘要:性能优化要按投入产出排队:先做零代码的框架级缓存(配置、路由、OPcache),再查数据层顽疾(N+1、慢查询、缺索引),最后才考虑业务缓存(Remember、Cache 门面、Redis)。本节按这个顺序给出完整清单与每项的适用边界,读完你能给项目做一次有依据的提速,而不是背口诀式的瞎调。
优化前先立基线
没有测量就没有优化。动手前先回答三问:现在接口耗时多少(基线)、慢在哪一环(定位)、改完快了多少(验证)。定位工具有现成的:调试栏的 SQL 面板看每页查询数与耗时,慢查询日志抓超阈值语句,queue:monitor 看队列积压。常见结论往往出乎意料——多数"框架慢"的项目,真相是每页百条 SQL 的 N+1(第五章的预加载没做)加缺索引,框架本身只占零头。
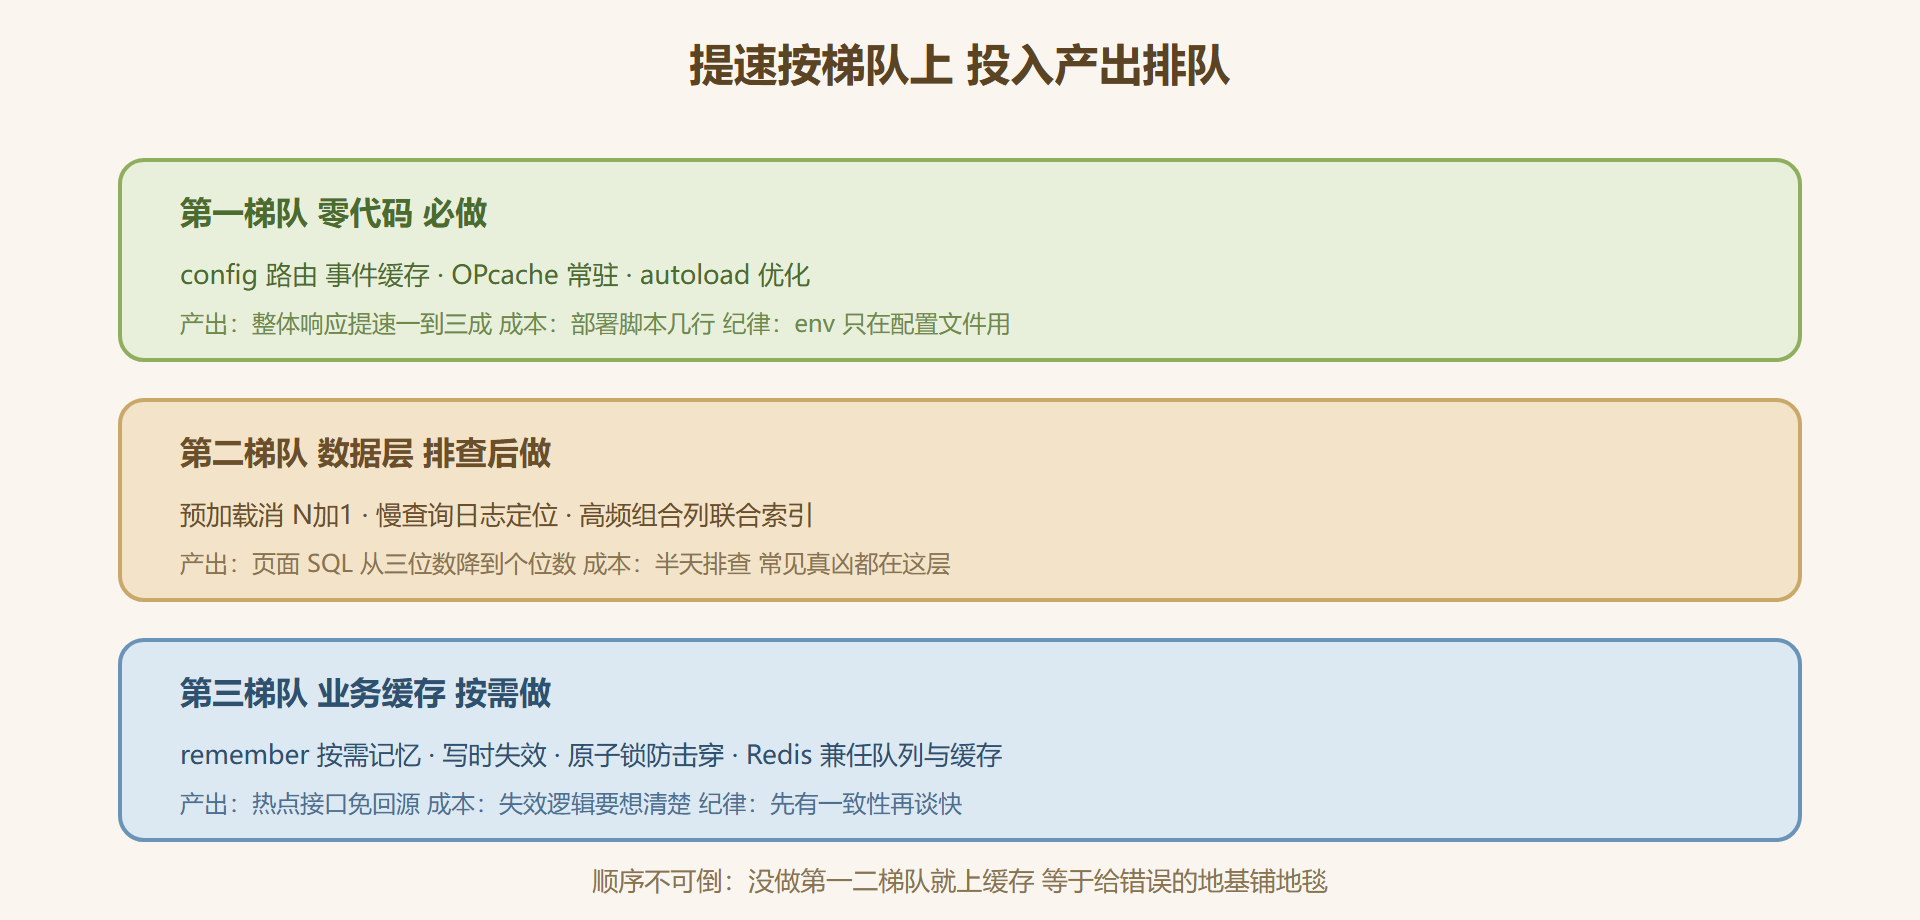
第一梯队:零代码的框架级优化
这批优化只改配置与命令,投入最小、确定性最高,是每个 Laravel 项目上线的必做项:
# 生产部署的标准优化三连(部署脚本里固定执行) php artisan config:cache # 配置合并成单文件,免去逐个文件读取 php artisan route:cache # 路由编译成数组,匹配变查表(呼应第三章) php artisan event:cache # 事件监听映射缓存
# PHP 层:OPcache 必开(php.ini),把编译结果驻留内存 opcache.enable=1 opcache.validate_timestamps=0 # 生产环境不检查文件改动,由部署触发重启 opcache.memory_consumption=256 # Composer 自动加载优化:类映射代替目录扫描 composer install --optimize-autoloader --no-dev
三条纪律配着这批优化走:config:cache 之后 .env 不再被逐行读取,env() 只能在配置文件里用,业务代码里直接调 env() 会静默拿到 null——这是新手线上事故的经典来源;本地开发环境别开这些缓存,否则改代码不生效能把人逼疯;validate_timestamps 关掉后,代码更新必须重启 PHP 服务,部署脚本里要写明。
第二梯队:数据层顽疾排查
按第五章的方法复查三件事。N+1:调试栏看每页 SQL 条数,超过十位数的先查预加载;慢查询:开慢日志抓超两百毫秒的语句,逐条看执行计划;索引:where 与 order by 的高频组合列建联合索引,迁移里补上(第九章第一节说过,索引变更也走迁移)。
<?php // 一个典型修复:列表页的搜索加排序,缺联合索引前是全表扫 // 迁移补索引 Schema::table('work_orders', function (Blueprint $table) { $table->index(['team_id', 'status', 'created_at'], 'orders_team_status_time'); });
第三梯队:业务缓存的取舍
数据层干净之后,剩下的热点才轮到缓存。缓存策略的核心问题是"什么数据可以旧到什么程度",按答案选机制:
<?php use Illuminate\Support\Facades\Cache; // 一、按需记忆:查一次存五分钟,命中即免查询 $stats = Cache::remember('dashboard:stats:' . $team->id, 300, function () use ($team) { return $team->orders() ->selectRaw('status, count(*) as n') ->groupBy('status') ->pluck('n', 'status'); }); // 二、写时失效:数据更新时主动清缓存,读侧永不过期 public function boot(): void { // 模型保存时清掉相关统计缓存(放 Observer 或直接在事件里) static::saved(fn () => Cache::forget('dashboard:stats:' . $this->team_id)); } // 三、原子锁防击穿:热点 key 过期瞬间,只放一个请求去回源 $value = Cache::lock('rebuild:stats', 10)->block(3, function () { return Cache::remember('dashboard:stats', 300, fn () => heavy_query()); });
驱动选择:单机小流量文件缓存够用;多机部署、要原子锁与队列时上 Redis——它同时是队列与缓存的地基,一项投入两处收益。缓存的失效键设计要带业务维度(如团队编号),全局一个大 key 既容易互相踩,也让失效粒度失控。
图 9-2:提速改造的梯队与投入产出
进阶路标与常见坑
单体优化到头还有两步可走:Octane 把应用常驻内存(Swoole 或 RoadRunner 驱动),省掉每请求的框架启动开销,吞吐翻倍常见,但代码要额外警惕内存泄漏与静态态污染;再往上就是读写分离与水平扩展,属于架构级议题,触发条件是单库写入成为瓶颈。
⚠️ 常见坑清单:把 session 或队列驱动留在 file 和 sync 就上了多机生产(第八章说过 Redis 一项两用);缓存了带用户身份的数据但键没带用户维度,A 用户看到 B 用户的面板;OPcache 的 validate_timestamps 关了但部署不重启服务,线上代码永远停在上一版。
优化的两个高频追问
页面改了内容,缓存要不要手动清?
取决于缓存策略的选择。remember 类缓存靠过期时间自然换血,适合容忍几分钟陈旧的统计数据;写时失效类靠模型事件主动清 key,适合必须即时一致的场景。最怕的是第三种——上线换逻辑忘了换缓存键,线上一直跑旧口径。给缓存键加版本前缀(如 stats:v2),是比"记得清缓存"更可靠的工程习惯。
优化做完怎么向团队证明有效果?
留对比数据:优化前的每页 SQL 条数与平均耗时、优化后的同口径数字。第三方库与调试栏都能导出这些数据。性能工作最忌"感觉快了"——没有前后数字,下一次有人往循环里塞查询时,没人有底气拦住。
本节要点回顾
- 先测后优:基线、定位、验证三步走,多数项目慢在 SQL 不在框架。
- 第一梯队必做:三项框架缓存加 OPcache,成本几行配置,纪律是 env 与部署重启。
- 第二梯队是真凶层:预加载、慢日志、联合索引,三位数 SQL 降成个位数。
- 第三梯队讲取舍:缓存策略先答"允许旧多久",键带业务维度,一致性优先于速度。
速度拉满了,最后一程:把项目安全地送上生产服务器,并给上线后的日子配好物业班子。下一节讲部署与运维。