2.1 Reactor 模式:一个搬运工看管所有传送带
2.1 Reactor 模式:一个搬运工看管所有传送带
本节摘要:Reactor 模式的核心是"事件分发"——一个或几个线程守在多路复用器上,谁就绪就通知谁处理,而不是为每个等待者派专职工人。本节拆解单线程、多线程、主从多线程三种编排的优劣,并给出 Netty 主从模型的代码、调参与判断依据。
一、问题的原型:等与被等的矛盾
把第一章的作坊式车间再往前推一步。假设你已经接受了"不该为每个连接养一个工人"的观念,那下一个问题立刻出现:一个工人怎么同时照看几百条传送带?他总不能轮流去每条传送带前问"有货吗"——这种轮询方式(polling)在连接数大时会把 CPU 耗在无意义的巡检上。
Reactor 模式给出的答案是别问,听广播:工人坐在调度室里,把所有传送带登记在一块"告警板"(多路复用器)上;任何一条传送带有货到,告警板会直接点名,工人只处理被点名的那些。等待的工作交给了告警板(操作系统内核的 select、epoll、kqueue 机制),工人只在有事可做时出手。这个"事件就绪 → 分发 → 处理"的循环,就是 Reactor(反应器)这个名字的由来:系统对事件做出反应,而不是主动巡检。
Doug Lea 在《Scalable IO in Java》里把这类编排总结成三种形态,Netty 全部支持,而且各有适用场景。
二、三种车间编排:单线程、多线程、主从
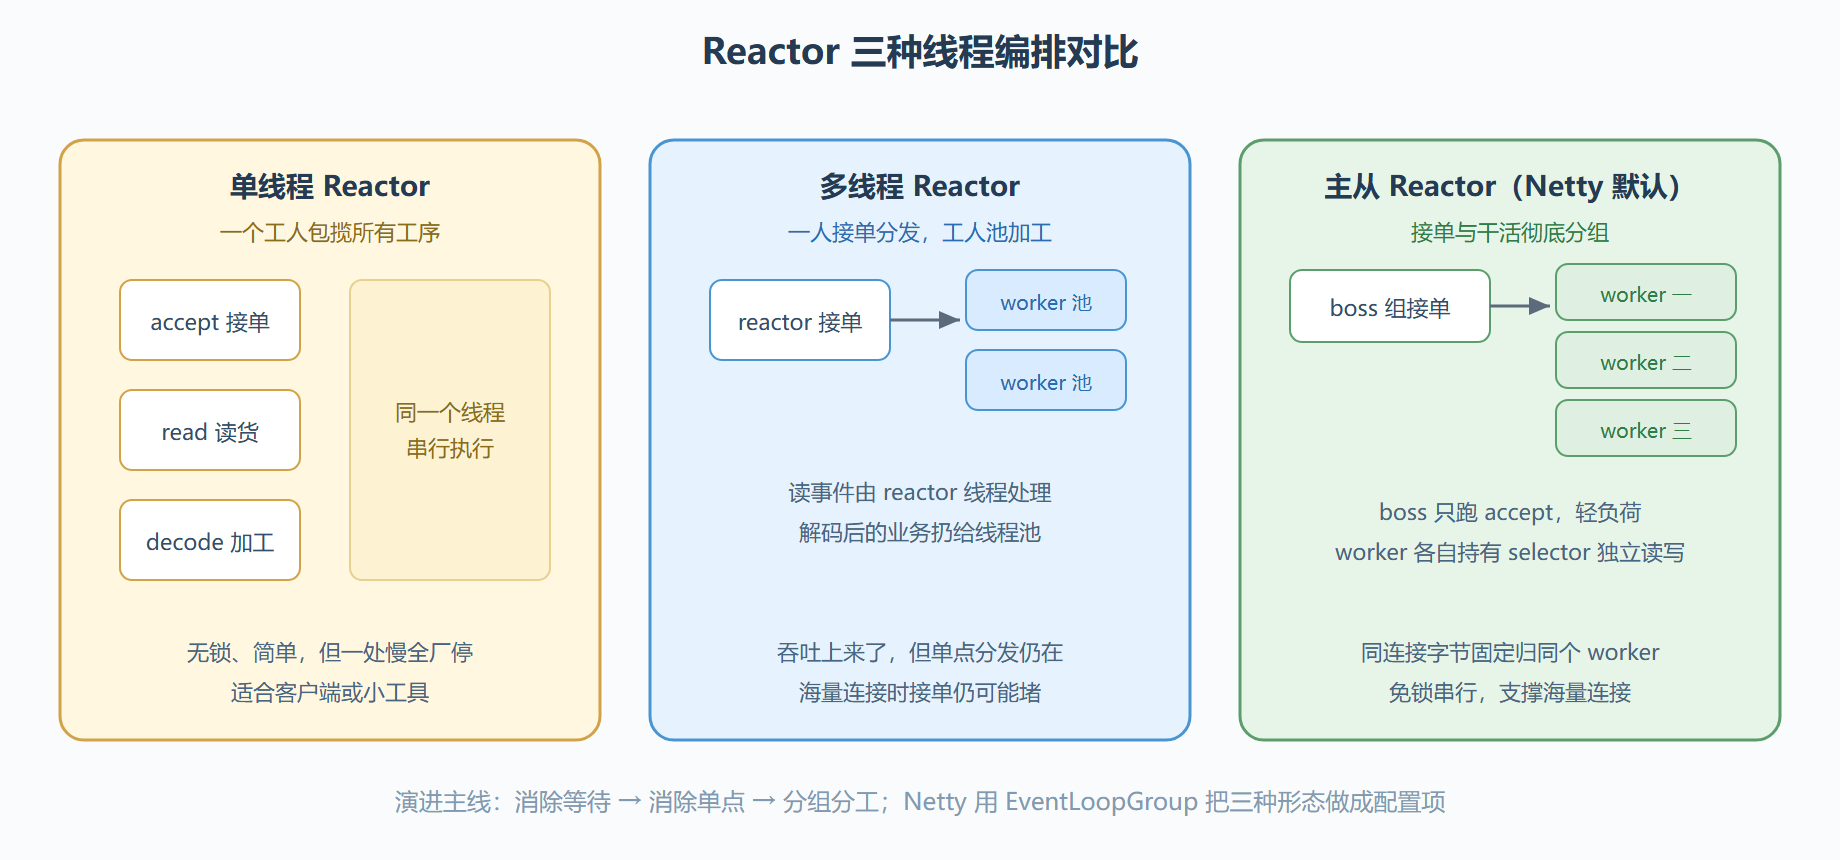
三种形态的取舍一目了然,但有三个细节值得单独强调。
其一,单线程 Reactor 的"无锁"是 Feature 不是 Bug。 Redis 就是单线程模型的著名实践者:一个线程串行处理所有请求,彻底消灭锁竞争与上下文切换。它的问题也在这里——任何一个操作慢了,全线排队。所以单线程只适合操作全部短平快的场景。
其二,多线程 Reactor 的瓶颈在分发者。 读事件仍由 reactor 单线程处理,连接数到几十万、或 accept 风暴来临时,分发者本身成为单点。
其三,主从模型把"接单"和"加工"分到两组线程。 Netty 的实现里,boss 组的 EventLoop 只注册了 OP_ACCEPT;新连接建立后,boss 把它按轮询方式注册进 worker 组某个 EventLoop 的 selector,从此这条连接的读写、解码、业务回调全部由该 worker 串行执行。
三、在 Netty 里落到代码
主从模型在 Netty 里就是第一章见过的两行,这次把每个参数的含义补全:
// boss 组:线程数 1 即可——accept 是轻活,多了浪费 EventLoopGroup boss = new NioEventLoopGroup(1); // worker 组:不传参数时默认取 CPU 核数 × 2 EventLoopGroup workers = new NioEventLoopGroup(); ServerBootstrap b = new ServerBootstrap(); b.group(boss, workers) // 主从分工在此生效 .channel(NioServerSocketChannel.class) .childHandler(...); // 也可以退化为单线程模型:两组传同一个实例 EventLoopGroup single = new NioEventLoopGroup(1); b.group(single, single); // 单 Reactor 形态 // 或者只传一组:等价于 boss 与 worker 合并 b.group(single); // 部分旧 API 支持,不推荐混用
worker 数量的经验起点是 CPU 核数 到 CPU 核数 × 2。判断依据不是连接数(连接多不等于忙),而是计算密度:如果 Handler 里有解析、压缩这类 CPU 密集操作,worker 数贴近核数即可;如果业务很轻、纯粹转发,2 倍核数通常吃满网卡中断与多队列。再往上加线程不会提高吞吐,只会加剧切换。
⚠️ 常见坑:为了"提高并发"把 worker 开到几十个。EventLoop 的设计前提就是少量线程各管一片连接,线程一多,同一条流水线上的内存局部性反而被破坏,吞吐不升反降。
四、怎么选:一张决策表
| 车间形态 | 对应编排 | 判断信号 |
|---|---|---|
| 客户端程序、代理的单连接侧 | 单线程 NioEventLoopGroup(1) |
连接少、逻辑简单、追求零锁 |
| 中小规模服务端 | 主从,worker 等于核数 | 常规业务,CPU 密集解析较多 |
| 海量连接推送/网关 | 主从,worker 两倍核数 + Epoll 传输 | 连接数十万级、单消息轻 |
| Handler 里有慢 IO(查库、调下游) | 主从 + 业务线程池隔离 | 慢操作绝不能占用 worker(第六章展开) |
💡 关键直觉:Reactor 解决的是"人等活"还是"活等人"的问题。三种编排的演进方向始终一致:让等待发生在内核(多路复用器),让线程只在有活时出手,让每条连接的活固定归一个人。
常被追问的三个细节
boss 线程为什么配一个就够? accept 只是把三次握手完成的连接从内核队列里取出来登记,单线程一秒能做数万次;真正的读写重活全在 worker。除非每秒新建连接以十万计的风暴场景,多配 boss 只是多养一个闲人。
worker 之间会不平衡吗? 轮询分配保证的是"注册时均匀",不是"负载均匀"——有的连接话多、有的安静,属于正常现象。Netty 刻意不做运行时迁移(把连接从一个 worker 挪到另一个),因为迁移要付出锁与状态同步的代价,大于收益;极端不平衡靠加机器横向扩容解决,而不是在线挪连接。
Handler 里 sleep 一秒会怎样? 该 worker 名下所有连接集体停摆一秒:心跳超时、消息延迟、任务队列积压会一起找上门。这不是理论风险,是代码评审里要实拦的高频事故。
出车间的检查单
- 核心思想:事件分发取代主动轮询,等待交给内核多路复用器。
- 单线程:全链路串行无锁,适合轻量客户端;Redis 是同思想的旁证。
- 多线程:业务并行化,但分发线程仍是单点。
- 主从:接单与加工分组,同连接固定 worker,Netty 服务端默认形态。
- 调参依据:worker 数由计算密度决定(核数到两倍核数),与连接数无关。
- 慢操作隔离:worker 里出现阻塞调用会拖垮整片连接,是主从模型的头号纪律。