1.1 消息队列演化史与 Pulsar 的出生
1.1 消息队列演化史与 Pulsar 的出生
本节摘要:消息队列不是被发明出来的,而是被"直连的痛"逼出来的。本节沿时间线走完进程直连、专用中间件、日志流系统三代形态,看清每代解决了什么、又留下什么新伤口,最终回答 Pulsar 为什么把存储从计算里搬出去——理解了这段因果,后面的所有架构设计都不必死记。
别急着看 Pulsar:先看水道是怎么修出来的
别以为消息队列是近十余年才冒出来的新潮玩意。只要软件系统出现了"两个程序需要错开时间传话"的需求,这条水道的第一段就已经挖开。上世纪的大型主机时代,工程师用消息队列接口在进程之间传递控制指令,那是最早的雏形;真正让这套思路普及的,是互联网业务把单体应用拆散成一堆互相看不顺眼的服务之后——调用方与被调方的时间节奏对不上了,谁也不愿意陪着谁阻塞。
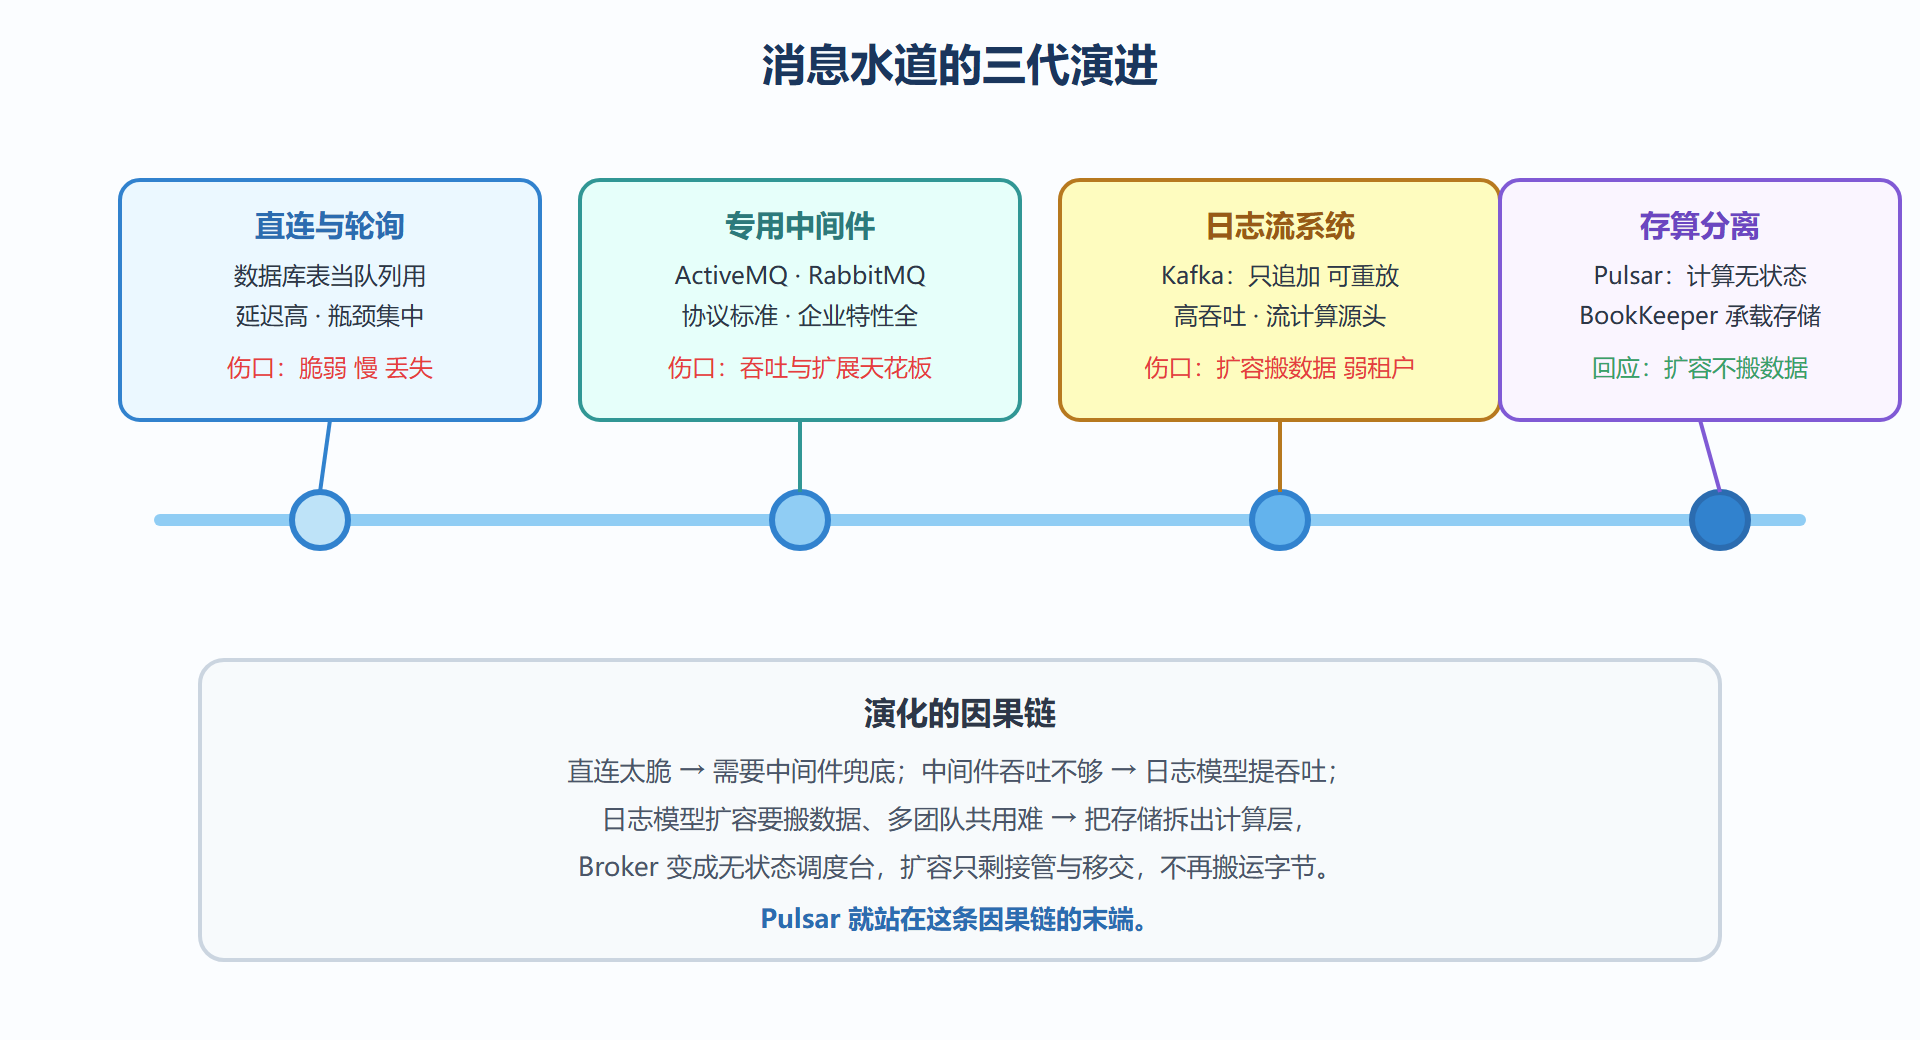
第一代解法朴素而痛苦:进程直连加轮询。发送方把消息写进数据库表或共享文件,接收方定期来扫。这种方式撑起了早期的大量业务,但三个伤口很快暴露:轮询间隔决定了延迟下限,想快就得空转烧资源;数据库表成了所有人的瓶颈,写入一多就锁成一团;没有统一的投递语义,消息丢了、重复了,全靠业务代码各自打补丁。
一、中间件时代:把水道独立成公共设施
于是专用消息中间件登场,IBM MQ 在金融行业扎根,ActiveMQ、RabbitMQ 把开源阵营带热。它们的核心贡献是把"存转发的规矩"从业务代码里抽出来,标准化成协议与接口:AMQP 定义了交换机、队列、绑定这套路由语法,JMS 在 Java 世界统一了编程接口。企业级特性也齐了——事务、持久化、优先级、死信,该有的柜面业务能力一样不缺。
这一代的天花板在吞吐与扩展上。RabbitMQ 的架构围绕"单节点的消息路由"展开,镜像队列能做高可用,但数据终究长在某些特定节点上;想要更高的吞吐,就得更复杂的集群配置,而扩展过程对使用者是心智负担。社交网络、日志采集这类场景一天要过几百亿条消息,中间件时代的架构模型开始喘不上气。
二、日志流时代:把队列变成只追加的账本
Kafka 在这场压力下把模型整个翻了过来:队列不再是"取走即消失"的待办清单,而是"只追加、可重放"的日志账本。消费者只记录自己读到哪个偏移量,读完了账本上的字并不擦掉,别人随时可以从头再读。配合顺序写磁盘与零拷贝,Kafka 把单集群吞吐推到了中间件时代难以想象的高度,顺势成了流式计算的事实数据源。
但日志流模型也有自己的性格缺陷。最典型的是分区与节点的绑定:分区是存储的基本单元,扩容、缩容或机器故障时的再均衡,本质是在节点之间搬运分区数据——几百 GB 的分区一搬就是小时级,搬完还要追增量。另一个常被诟病的点是多租户能力薄弱:没有原生的租户隔离,几百个业务共用一个集群时,配额、权限、隔离都要靠命名约定与外围工具硬凑。此外消息确认语义偏简单,延迟敏感场景与队列语义场景用起来总有别扭之处。
图 1-1 消息中间件三代演化时间线
三、Pulsar 的回答:把存储从计算里请出去
Pulsar 诞生于 Yahoo 内部,动机非常具体:当时公司内部的消息基础设施要在成千上万个主题、多团队共享的前提下保持低延迟,Kafka 式的再均衡搬运在那种规模下不可接受。工程师们给出的答案是釜底抽薪——把"消息的存放"整个外包给专门的存储层 BookKeeper,Broker 自己只留路由与调度,变成可以随时增删的无状态服务层。主题的所有权(哪些分区由哪个 Broker 服务)成了纯元数据,切换归属只是改一条记录,不用挪任何消息字节。
这一刀切下去,带来三件连锁好事:扩容缩容变成秒级的所有权移交;Broker 故障后其他节点立刻接手,不需要等数据复制完成;分层存储能顺理成章地把老数据卸到更便宜的对象存储上去,因为计算层本来就不持有数据。代价则是组件更多、初次部署的理解成本更高——这也是为什么本书要用整整一章(第 2 章)来拆它的四层架构。
容易误读的两个演化断点
走时间线时有两处断层最容易被讲歪,值得单独校准。第一处是"中间件被日志流取代"这个流行说法。事实是取代从未发生:RabbitMQ 至今在电商交易、物联网接入、企业集成总线里活得好好的,因为队列语义(消息被消费即离开、天然削峰、灵活路由)与日志语义(只追加、多订阅重放)服务的是不同形状的问题。真实的演化图景是并存与分工,不是你死我活——日志流吃下了"数据管道"这个新物种的巨大增量,而传统中间件守住了"业务投递"的老地盘。看懂这一点,你就不会在选型讨论里说出"我们都该迁走"这种话。
第二处断层是"Pulsar 只是又一个 Kafka"。这句话对设计动机极不公平。Kafka 的每一步演化都在"分区日志"这个框架内打转——分区是吞吐单元也是存储单元,两者绑死,于是再均衡必须搬字节。Pulsar 的起点恰恰是拆开这组绑定:吞吐归计算层管(Broker 无状态调度),存储归账本协议管(BookKeeper 条带化)。同样的功能清单背后是不同的骨架,骨架差异决定了它们在多团队共享、频繁弹性、长保留归档这些场景下的行为分岔。读技术史要读骨架,不是读功能表——这是本节最想传下去的方法。
演化史的三个可迁移判断
最后把故事压成三句能带走的话。其一,架构的天花板在模型里:中间件时代输在"单节点路由"的模型,不是输在工程实现不够努力——换谁都一样。评估一个系统远期容量,先看它的负载模型里哪两个东西被绑死了。其二,新世代不是旧世代的替品:日志流没有杀死队列,而是开辟了数据管道的市场;存算分离也不是要取代谁,而是为"共享大集群"这个此前没有好答案的场景补上拼图。选型时问"我的问题属于哪个市场",比问"谁更强"靠谱。其三,运维形态跟随存储位置:数据在哪,运维就在哪——直连时代运维数据库表,日志流时代运维分区副本,账本时代运维存储协议。Pulsar 把运维重心从"看住某台机器的盘"改写成"看住协议参数与承载均衡",第 4 章的 Quorum 算术正是这套运维的核心。
本节要点回顾
- 直连与轮询是一切的原点:延迟差、瓶颈集中、语义靠业务自保,逼出了公共水道的思路;
- 专用中间件(ActiveMQ、RabbitMQ 一脉)贡献了协议标准与企业级特性,但吞吐与水平扩展有结构性天花板;
- 日志流系统(Kafka)用只追加账本换来高吞吐与重放能力,代价是扩容搬数据、多租户偏弱;
- Pulsar 的立身之本是存算分离:Broker 无状态化之后,扩容、故障转移、分层存储都成了轻动作;
- 每一代系统都是对上一代伤口的回应,选型时问自己:你的痛点落在哪一代的伤口上。
下一站,给消息办手续:租户、命名空间与主题,这套户籍制度决定了每条漂流者的身份与航道。