1.3 Pulsar 与 Kafka、RabbitMQ 的对比
1.3 Pulsar 与 Kafka、RabbitMQ 的对比
本节摘要:选型不必站队,但必须看清差异。本节把 Kafka、RabbitMQ、Pulsar 三条水道放进同一张矩阵,从架构模型、扩展方式、延迟与语义、多租户、功能生态五个维度逐项拆解,并追问每个差异背后的设计根源——读完你会得到一套可迁移的对比框架,而不是一份需要背诵的结论表。
把三代水道摆在一起
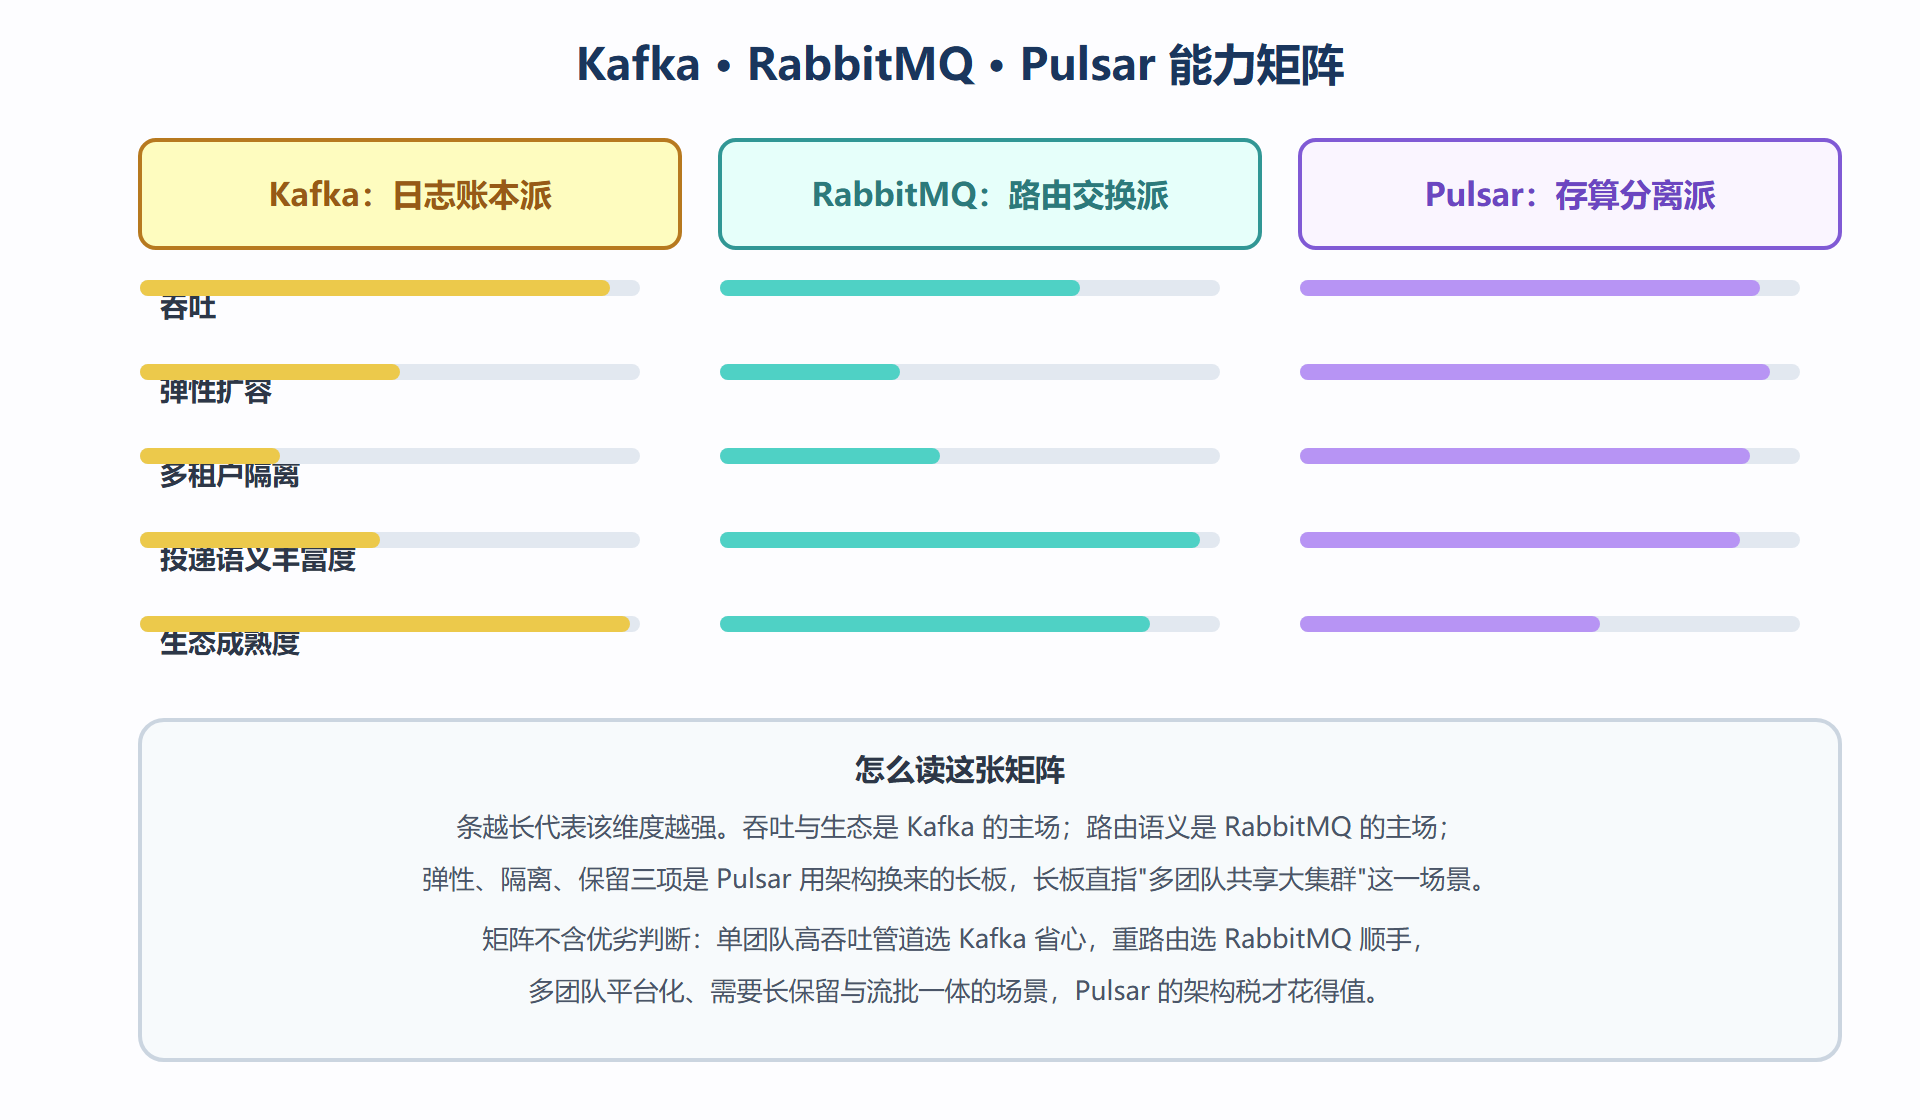
对比之前先交代立场:这三套系统没有谁全面胜出,它们的差异几乎全部来自 1.1 节那部演化史的延续。Kafka 用"分区即存储单元"换来极致吞吐;RabbitMQ 用"单节点灵活路由"换来丰富的投递语义;Pulsar 用"存储外包"换来弹性与共享。理解了各自的立身之本,矩阵里的每个格子都是自然推导的结果。
先用一张速览表定住骨架,后面逐维展开:
| 维度 | Kafka | RabbitMQ | Pulsar |
|---|---|---|---|
| 核心模型 | 分布式提交日志 | AMQP 队列与交换机 | 分层:无状态 Broker 加分布式账本 |
| 扩容方式 | 分区重分配,搬数据 | 队列所在节点难水平扩展 | 所有权移交,不搬消息字节 |
| 消费语义 | 消费组拉取,偏移量提交 | 推送为主,确认即删除 | 订阅类型可选,游标独立于数据 |
| 延迟特点 | 毫秒级,批量吞吐强 | 微秒到毫秒,路由灵活 | 毫秒级,分层存储下长尾可控 |
| 多租户 | 无原生租户,靠外围约定 | vhost 提供弱隔离 | 租户命名空间主题三级原生隔离 |
| 保留能力 | 按时间或大小删段 | 消费后即弃,回溯弱 | 数据与游标分离,可无限保留加分层 |
| 功能生态 | Connect、Streams 生态成熟 | 插件丰富,协议适配广 | Functions、IO、事务、SQL 内建 |
图 1-2 三代消息系统多维对比矩阵
逐维拆解:差异从哪里来
架构与扩容是所有差异的源头。Kafka 的分区副本直接落在 Broker 本地盘上,扩容时新节点没有历史数据,必须靠重分配工具把分区字节搬过去,规模大时这是以小时计的重活。RabbitMQ 的队列长在特定节点上,集群能做故障转移,但"加一台机器就线性加吞吐"并不成立。Pulsar 把字节交给了 BookKeeper 这层专门的存储集群,Broker 加节点后只需把部分主题的所有权移交过来——改元数据的事,秒级完成,而且对生产者消费者完全透明。
消费语义的差异最有意思。Kafka 是消费组模型:一个分区同时只给组内一个消费者,想广播就再开一个组。RabbitMQ 走另一极端,推送加逐条确认,语义灵活但高吞吐场景吃力。Pulsar 的订阅(subscription)是独立于消费者存在的一等公民:独占、故障转移、共享、按键共享四种模式(第 3 章专讲),同一段数据既能让某组排队消费,也能让另一组广播观察,互不干扰——相当于把 Kafka 的"多消费组"与 RabbitMQ 的"队列语义"装进了同一套模型。
保留与回溯:日志账本派靠时间或大小删段,回溯靠偏移量;RabbitMQ 消费即删,回溯基本没有;Pulsar 的数据保留与消费进度彻底解耦,同一个主题上,A 订阅早已读到最新,B 订阅可以停在昨天慢慢追,数据的生命周期由命名空间策略统一管理,还能把冷数据卸到对象存储(第 4 章的分层存储)。
选型判断的三问
给一套可操作的判断顺序。一问团队形态:单团队自用,运维成本优先,Kafka 或 RabbitMQ 的简单性是真实优势;多团队平台化共享,Pulsar 的原生租户隔离开始值钱。二问流量形状:超大吞吐日志管道,Kafka 的成熟度与工具链最稳;强路由语义、小流量业务集成,RabbitMQ 依旧顺手;吞吐与弹性都要、还想长保留回溯,Pulsar 对得上号。三问未来三年的变化:业务会频繁扩缩容吗?会有更多团队接入吗?会需要把老数据沉到廉价存储吗?答得越肯定,Pulsar 的架构红利越明显。
延迟与语义的一组注解
对比矩阵里"延迟"一格最容易被跑分数字带偏,补几条注解。Kafka 的低分位延迟建立在批量之上,追求极致吞吐的配置下,尾延迟受攒批窗口影响;RabbitMQ 小消息直发直收,轻负载下延迟极低,但负载一重抖动先来;Pulsar 的写入要多走一跳网络(Broker 到 Bookie),中位延迟通常略高于本地盘直写的架构,换来的是抖动小——账本协议把热点摊在多台机器上,长尾反而好收拾。选型时把"中位低"与"长尾稳"分开问,业务对两者敏感度往往不同:接口链路怕长尾,管道吞吐看中位。
语义丰富度那格也值得展开一句。三套系统都能实现"排队、广播、重试、死信",差别在于哪些是原生一等公民、哪些要靠外围拼装——原生的能力有统一的配置面与监控面,拼装的能力有三份运维成本与不一致的故障模式。评估时不要问"能不能做",要问"做了之后归谁管"。
一场假想的迁移:订单流从 Kafka 搬去 Pulsar 要动什么
对比矩阵读完,用一次假想迁移把差异落到操作面。假设团队决定把订单事件流从 Kafka 迁到 Pulsar,工程师要动的东西排出来是这样:生产端替换客户端依赖与发送代码,分区键的哈希语义要在 Pulsar 侧用消息键对齐(同键同分区的行为一致,但分区编号本身不延续);消费端的重头是概念翻译——Kafka 消费组对应 Pulsar 的"共享或按键共享订阅",偏移量提交对应游标确认,重平衡对应 Bundle 移交,最后一类映射里最值得留意的是"消费组内一个分区一个消费者"的限制在按键共享模式下不复存在,并行逻辑可以简化。数据搬迁通常双写过渡:新旧水道并行灌一段,下游按订阅逐个切换,Kafka 兼容协议在这段过渡期还能让老客户端零改动接入 Pulsar。
反方向的迁移(Pulsar 搬回 Kafka)作业量明显更大:长保留的历史数据要导出、多订阅的进度要各自换算成消费组偏移、跨租户的权限要在外围系统重建。这份不对称本身就是对比结论的一部分——迁移成本的方向,暴露了哪个系统承载了更多治理职能。做选型汇报时,把"迁走的成本清单"写在材料里,比堆功能对照表更能让决策者看清锁定效应。
关于兼容协议与迁移工具的一句话
Pulsar 服务端提供 Kafka 兼容协议适配层,存量 Kafka 客户端指向适配地址即可收发,双写期与灰度期因此平滑许多;社区另有现成的迁移工具做存量数据搬运。具体版本能力变化较快,动手前以其官方文档的最新说明为准——本教程只负责告诉你这层适配存在、且应该在方案里用上。
本节要点回顾
- 三套系统的差异源自各自立身之本:日志账本、路由交换、存算分离;
- 扩容是否搬数据,是理解 Pulsar 与 Kafka 运维差异的钥匙;
- Pulsar 的订阅独立于数据存在,四种订阅模式可在同一主题上并存;
- 选型按"团队形态、流量形状、未来变化"三问推进,别只看跑分。
下一站收拢本章:把订单事件流放回场景里,划清 Pulsar 的适用边界——什么货适合走水路,什么货别上这条船。