3.2 一条消息的完整漂流:从生产到消费
3.2 一条消息的完整漂流:从生产到消费
本节摘要:本节让那条订单消息把全程游完:生产者发送、Broker 认领与开账本、条带落盘、到达确认、消费者接货、游标推进、签收回收。全链路按站拆解,每站标注"如果这一跳失败会发生什么"——理解失败行为,比记住成功路径更有工程价值。
从 send 到 ack:一站一站看
调用 producer.send() 的瞬间,一场接力开跑。为了让过程可观察,我们先给消息加上跟踪字段,再逐站拆解:
TypedMessageBuilder<String> msg = producer.newMessage() .key("order-1024") .property("trace-id", "t-20240521-0007") // 自定义属性,全程可追踪 .property("stage", "CREATED") .value("{\"orderId\":\"1024\",\"amount\":19900}"); MessageId id = msg.send(); // 阻塞点:send 返回即代表 Broker 已持久化确认
send() 的返回值值得注意:它不等于"消费者已收到",而等于"Broker 已按账本协议把它写进了货仓并回了执"。这个语义差异是排错时的分水岭——发送端慢,查的是写入路径;消费端缺失,查的是订阅与游标。
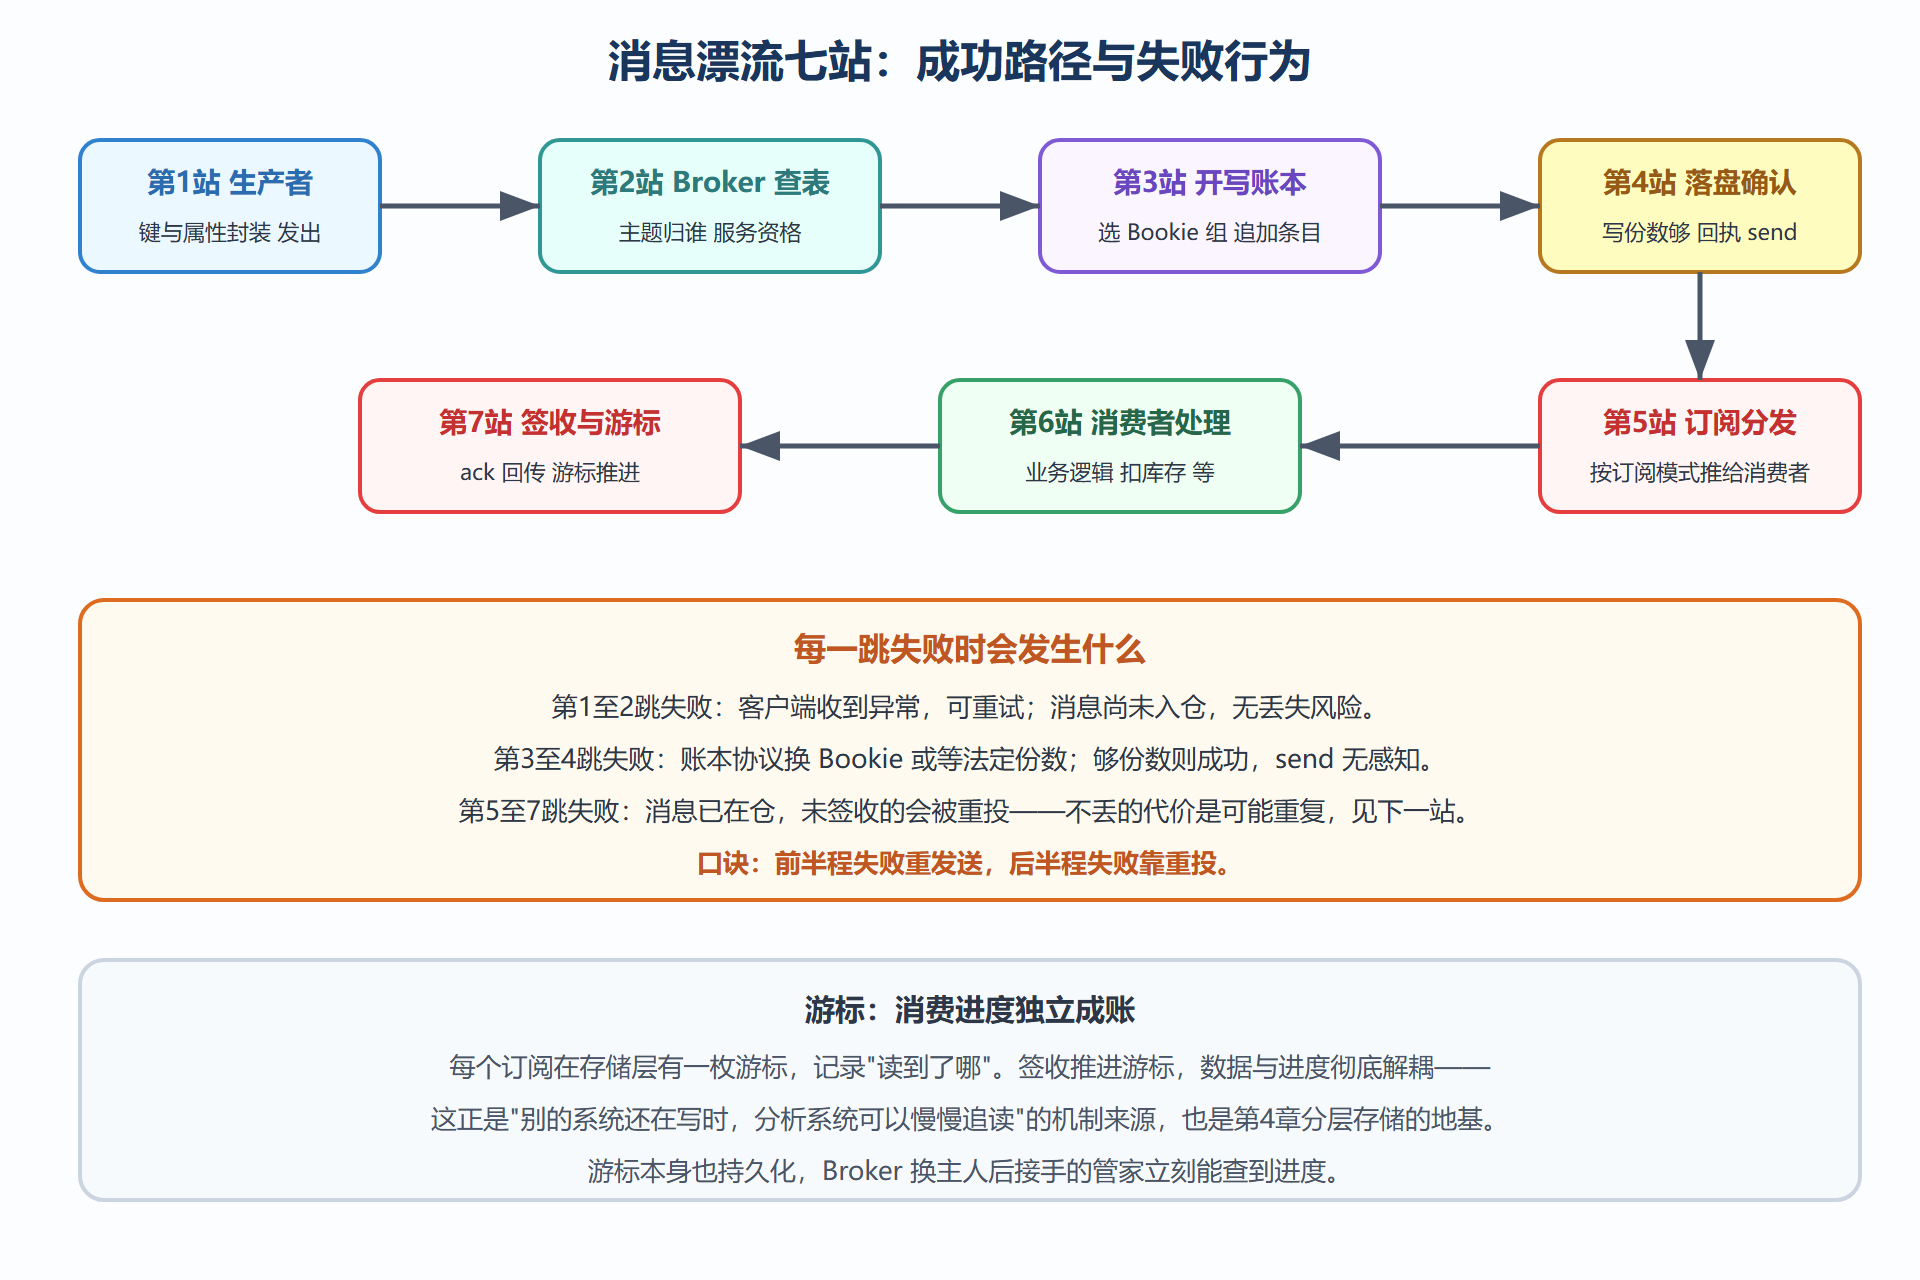
图 3-1 一条消息的完整漂流全链路
逐站补注:图上看不见的细节
第 2 站到第 3 站之间有一个"开账本"决策:当前账本写满或写够时长就封存、开新账本。封存的账本变成只读,读它不再有写锁竞争——这是 Pulsar 延迟曲线平稳的原因之一。第 4 站的"回执"携带 MessageId,即账本号加条目号,发送方拿到它就有了全集群唯一的坐标,第 5 章的幂等生产会用到。第 5 竅的"分发"由订阅模式决定:推给谁、推几份、要不要抢,第 3.3 节整节都在回答。第 7 站的签收有单条与累积两种粒度,且签收本身也是一次网络往返——大批量场景用累积签收能省下可观的确认开销。
用命令观察漂流中的每样实体
理论走完,用管理命令把这趟漂流的所有实体点一遍名:
# 看主题的订阅(每个订阅一枚游标)与各自的消费进度 $ pulsar-admin topics stats persistent://trade-order/transaction/order-events # 输出关键字段示意: # "subscriptions": { # "risk-control": { "msgBacklog": 0, "consumers": 2 }, # 风控订阅已追平 # "warehouse-etl": { "msgBacklog": 154203, "consumers": 1 } # 数仓订阅还在追 # } # 看主题当前的账本列表与每段账本的条目数 $ pulsar-admin topics internal-info persistent://trade-order/transaction/order-events # 直接查看某个游标的位置(账本号加条目号) $ pulsar-admin topics get-subscription-position \ --subscription warehouse-etl \ --topic persistent://trade-order/transaction/order-events
msgBacklog(积压)这个字段建议养成常看的习惯:它是订阅"欠账"的实时读数,数仓订阅欠十五万条说明它在补数,风控订阅欠账持续增长则说明处理能力告急——积压是第 6 章监控告警的第一指标。
七站的时序版:把图读成顺序
静态图看过,换时序视角把关键交互排成先后。下面这段时序图描述同步发送加共享订阅的典型时序(省略批量与多分区细节):
时序图上能看清两处静态图看不出的东西。其一,确认份数的等待发生在 Bookie 组与 Broker 之间,生产者的等待横跨"网络加组装加落盘"全程——这就是批量与压缩都在生产者侧攒、攒完再走的物理原因:既然要等,就把等待摊薄到多条消息头上。其二,游标推进是签收之后的独立动作,消费进度与数据写入是两条独立的账——第 3.4 节的"确认丢失导致重投"与第 4 章的"游标独立成账",根子都在这一步。
时序里每一跳都值得标一个延迟预算:生产者到 Broker 的网络、Broker 组装与排队、Bookie 日志盘的顺序写、回执返回、分发推送、消费者处理、签回。做端到端延迟优化时,把预算逐跳填进去量一量,瓶颈在哪一跳一目了然——绝大多数项目的答案是"消费者处理"那格最长,而不是消息系统本身。先量再优,别凭感觉调参。
漂流的观测窗口:把黑盒打开的三条命令
全程漂流还有个常被忽略的价值:它给出了排错时的"观测锚点"。消息系统出问题时,工程师最容易问的是"我的消息哪去了",而这正是漂流七站每站都有观测窗口的原因——按站查,别全链路瞎猜。发送端先看回调日志与超时错误码(第 1、2 站有无异常);Broker 层用管理命令查主题是否被人订阅错名字;账本层看主题的账本列表有没有异常封存;订阅层看积压与重投计数。下面的命令组合是漂流观测的最小集:
# 订阅与积压总览:每个订阅的欠账与消费人数 $ pulsar-admin topics stats persistent://trade-order/transaction/order-events # 最近异常:看主题的发布与消费错误率(接入监控前的手动版本) $ pulsar-admin topics stats-internal persistent://trade-order/transaction/order-events # 游标细查:某订阅卡在哪个坐标(不同版本参数名略有差异,help 可查) $ pulsar-admin topics get-subscription-position --help
把七站、观测锚点、命令组合三者对应起来,就形成了一张"漂流排错对照卡"——这也是第 6 章监控告警体系的雏形。建议把这张卡贴在团队文档里,格式随意,内容必须包含"每站的失败模式"与"每站的观测命令"两列。
本节要点回顾
- send 的返回语义是"已持久化入仓",不是"已被消费";排错先分清发送侧与消费侧;
- 七站全链路:封装、查表、开账本、落盘确认、订阅分发、业务处理、签收推进;
- 前半程失败重发送、后半程失败靠重投,这条口诀覆盖绝大多数丢失疑云;
- 账本封存变只读,写读分离让延迟曲线平稳;
- 游标独立成账且持久化,积压数是订阅欠账的实时读数。
下一站看分发规则的四种面孔:谁来接货、怎么分货,订阅模式说了算。