4.1 存算分离与写入路径
4.1 存算分离与写入路径
本节摘要:存算分离不是营销词,而是一份具体的分工合同:计算层(Broker)不落盘,存储层(BookKeeper)不问业务。本节把这份合同拆成条款,再沿写入路径把 Entry、Ledger、Ensemble 三级组织一次讲透——读完你能画出一条消息从内存到多块磁盘的完整落盘路线。
为什么存算分离值得做
把口号翻译成条款。条款一:Broker 不持有本地数据卷,扩缩容、故障替换都是元数据事务(第 2 章已验证)。条款二:存储容量与计算容量独立规划——消息量大但计算量小的场景(长保留归档),堆 Bookie 即可;流量尖峰但数据量小的场景(实时信令),堆 Broker 即可,两类机器各按各的形状采购。条款三:存储协议统一,不管上层是普通主题还是事务、函数状态,落盘都走同一套账本协议,可靠性论证只需做一次。
代价也要诚实列:组件更多、一次部署的理解成本更高;写入要多跳一跳网络(Broker 到 Bookie);故障域从一个变成两个,监控要分面看。这笔账在多团队共享、数据要长期留存的场景下明显是划算的,在单人单集群的小场景则未必——与第 1 章的选型结论互为印证。
一、写入路径上的三级组织:Entry、Ledger、Ensemble
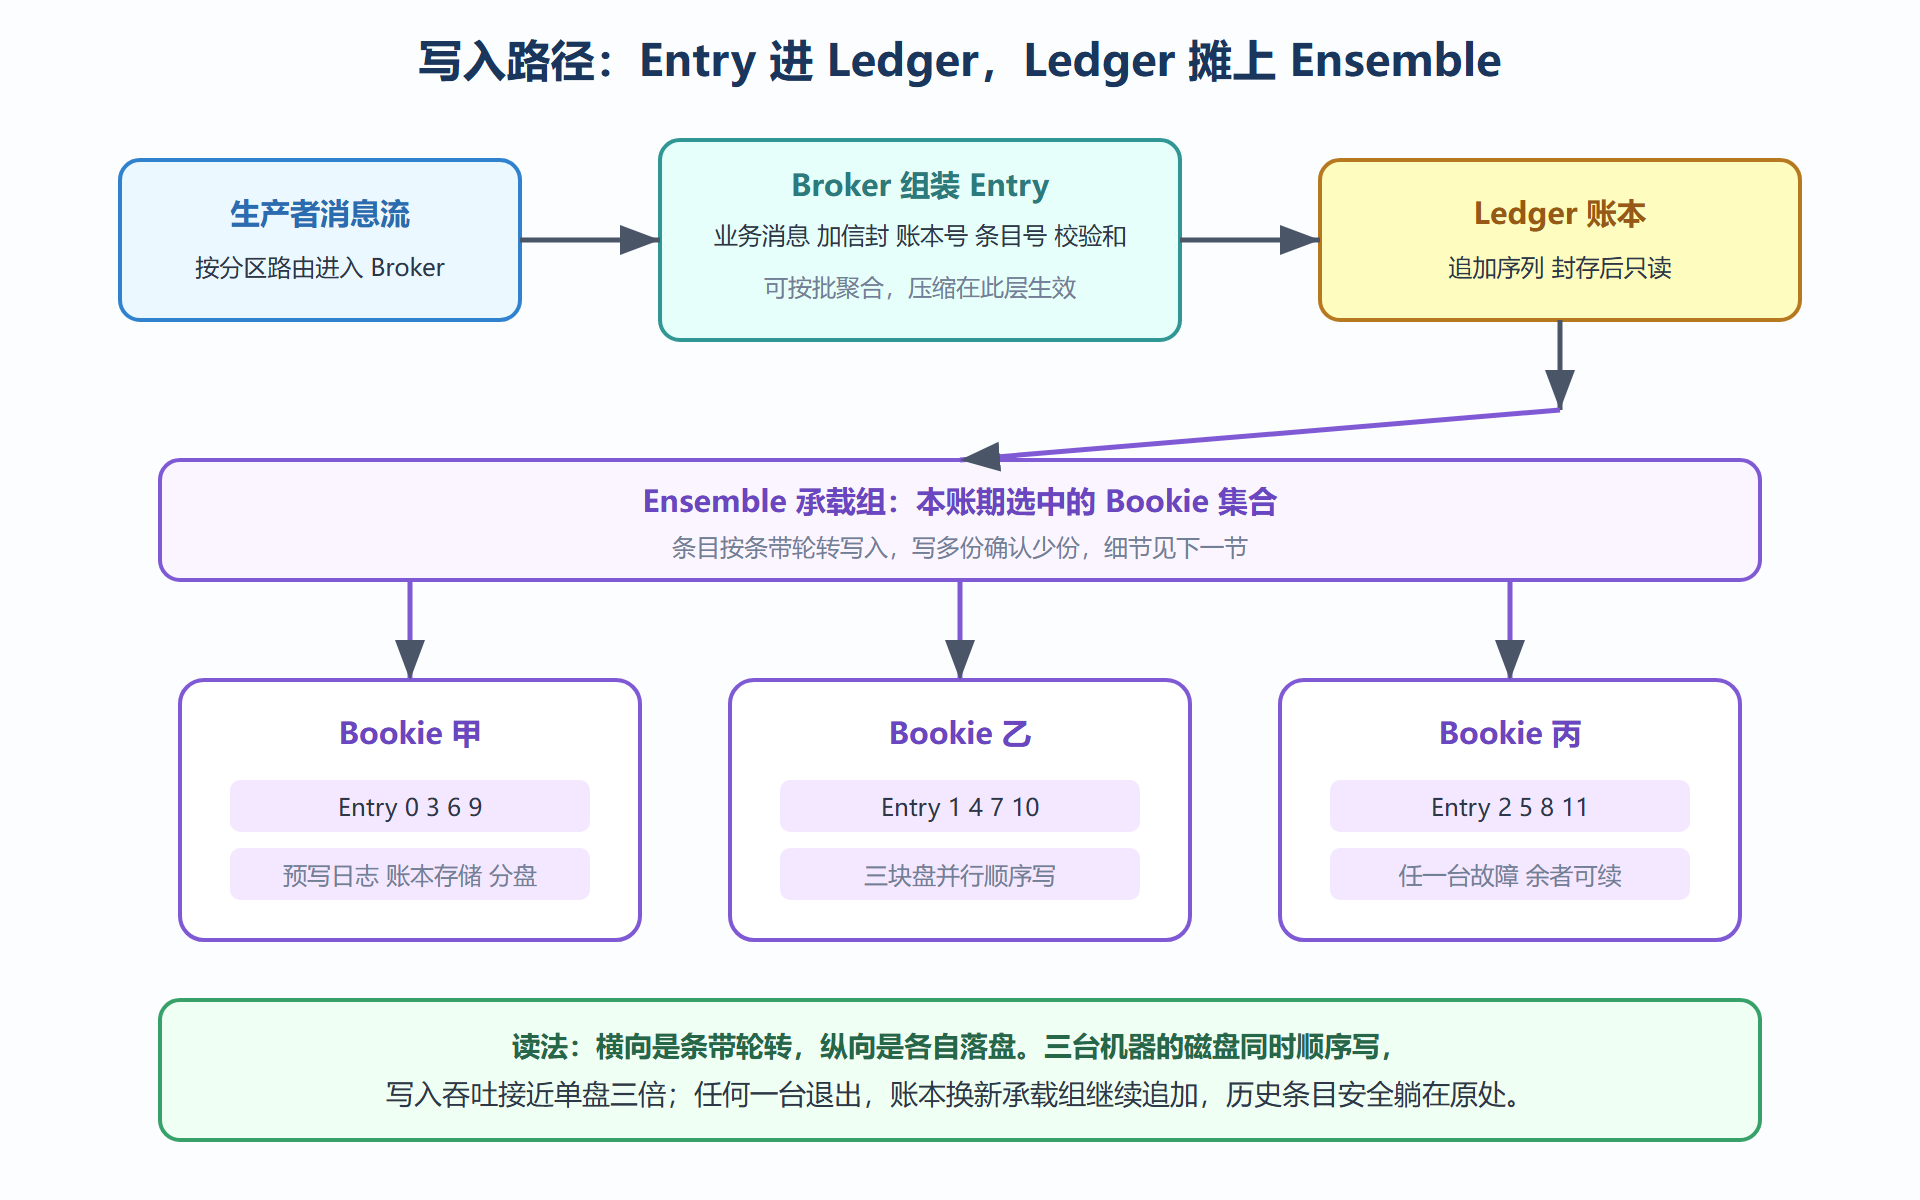
一条消息从 Broker 出发走向磁盘,经过三级组织:
**Entry(条目)**是存储层的最小写入单元。一条业务消息(或聚合后的一批)加上层信封信息,构成一个条目;信封里带着账本号、条目号与校验和。你在客户端拿到的 MessageId,就是"账本号加条目号"这组坐标。
**Ledger(账本)**是条目的追加序列,上一章已见过:主题分区按量或按时切段,每段是一个账本,账本封存后只读。
**Ensemble(承载组)**是账本背后的 Bookie 集合。创建账本时从集群选出若干台 Bookie 组成承载组,条目按条带轮转写进去。承载组是"账期内"的概念——账本可以由多段承载组接力(比如写到一半一台 Bookie 掉线,剩余条目换一组机器继续写),这让单个账本的寿命不再受任何一台机器的生死约束。
图 4-1 写入路径:从生产者到多块磁盘
二、读路径的对称性:按坐标取件
写入按坐标组织,读取自然按坐标定位。消费者请求消息时,Broker 凭游标知道"下一个该读账本几的条目几",直接向承载着该条目的 Bookie 发起读取。这里有个精妙的分工:热读走 Broker 的内存缓存(刚写的数据往往马上有人读,缓存命中率高),冷读直接找 Bookie(Broker 不做数据的二传手,避免自己变成瓶颈)。读懂这对分工,你就明白为什么 Broker 的内存配置里有一块专门给"读缓存",也明白为什么监控里缓存命中率是个值得盯的指标。
三、写路径上的两个省字节的环节
既然写入要跨网络跨磁盘,Pulsar 在路径上安排了两个可开关的节省环节。批量(batching):Broker 或客户端把短时间内的多条小消息聚合成一个 Entry 落盘,磁盘 IO 与网络包数都按比例下降,代价是消费端要拆包、且单条确认需要特殊的批内索引。压缩(compression):条目在写入前压缩、读取后解压,重复内容多的业务(日志、监控上报)压缩比可观。两者的参数旋钮都在生产者侧配置,第 5 章生产者实战会给出具体代码。
💡 关键直觉:把写入路径读薄成一句话——消息变成带坐标的条目,条目追加进账本,账本摊在一组机器上。坐标(MessageId)、账本(Ledger)、机器组(Ensemble),就是货仓全部的地址学。
Bookie 内部的两本账:预写日志与账本文件
把镜头再拉近一层,看单台 Bookie 内部怎么接住写请求。Bookie 手里有两类落盘结构,分工像餐厅的收银小票与库房台账。**预写日志(Journal)**是收银小票:每笔写入先在它这里顺序落盘,落定即应答——它存在的唯一目的是断电不丢账,顺序追加让它写得飞快。**账本存储文件(EntryLog)**是库房台账:小票记完的条目异步整理归档进按账本组织的存储文件,同时内存里更新条目到文件的索引。
这个双结构解释了三个生产铁律的来历。铁律一,两类文件分盘:小票要求极低延迟的顺序写,台账是顺序写加随机读,混在一张盘上互相抢磁头,写入延迟会周期性抖动。铁律二,日志盘用最快的介质:确认延迟基本取决于预写日志的落盘速度,它慢全链路都慢。铁律三,关注后台压平的节奏:删除与过期留下的空洞要靠压平回收,压平太猛抢 IO、太慢磁盘涨——给它单独限速并错峰,是 Bookie 运维的基本功。
对应用开发者,这一层的意义在于把"写多快"翻译成"哪块盘多快":消息系统的写入延迟,物理上等价于"网络加 Broker 排队加日志盘顺序写"的合计。性能报告里写"写入延迟涨了",运维第一句就问"日志盘换过没有"——现在你知道这句行话的出处了。
一段实盘观察:把写入路径读成数字
构造一个小实验把路径读成数字。准备一个测试主题,分别以"单条同步、开批量、开批量加压缩"三种姿势各灌十万条千字节报文,同时观察 Bookie 侧的写入指标与服务端返回的 Entry 数:
# 服务端视角:看测试主题的账本与条目规模 $ pulsar-admin topics stats-internal persistent://trade-order/transaction/bench # 关注两个字段:entriesAdded(Entry 总数)与 size(字节总量) # 三种姿势跑完记录三组数(示意): # 单条同步:Entry 约 100000,字节总量约 100MB,耗时最长 # 开批量(百条批):Entry 约 1000,字节总量约 100MB,耗时大幅下降 # 批量加 ZSTD:Entry 约 1000,字节总量约 25MB,耗时再降
三组数字把路径上的两个节省环节全部显形:批量让 Entry 数从十万跌到千,压缩让字节量缩到四分之一。下次有人说"消息系统撑不住量",先问这两个旋钮拧了没有——路径上白给的钱不捡,就去加机器,是 storage 层面最常见的浪费。
本节要点回顾
- 存算分离三条款:计算不落盘、容量独立规划、存储协议统一;代价是组件与监控面变多;
- Entry 是最小写入单元,Ledger 是条目序列,Ensemble 是账本背后的 Bookie 承载组;
- 承载组可中途换班,账本寿命不受单机生死约束;
- 读路径分工:热读走 Broker 缓存,冷读直达 Bookie;
- 批量与压缩是写路径上的两个省字节环节,旋钮都在生产者侧。
下一节做 Quorum 的算术:写几份、确认几份,数字背后是可靠性与开销的兑换率。