5.1 生产者实战:异步、批量与压缩
5.1 生产者实战:异步、批量与压缩
本节摘要:生产者的所有花样都围绕一件事:把"发一条等一下"变成"攒一批一起走,走完了告诉我"。本节拆解同步与异步的本质差异、批量的攒包机制与尾延迟代价、压缩算法的选择实测,最后给出一段可运行的高吞吐生产者完整代码。
别以为发消息只有 send 一步
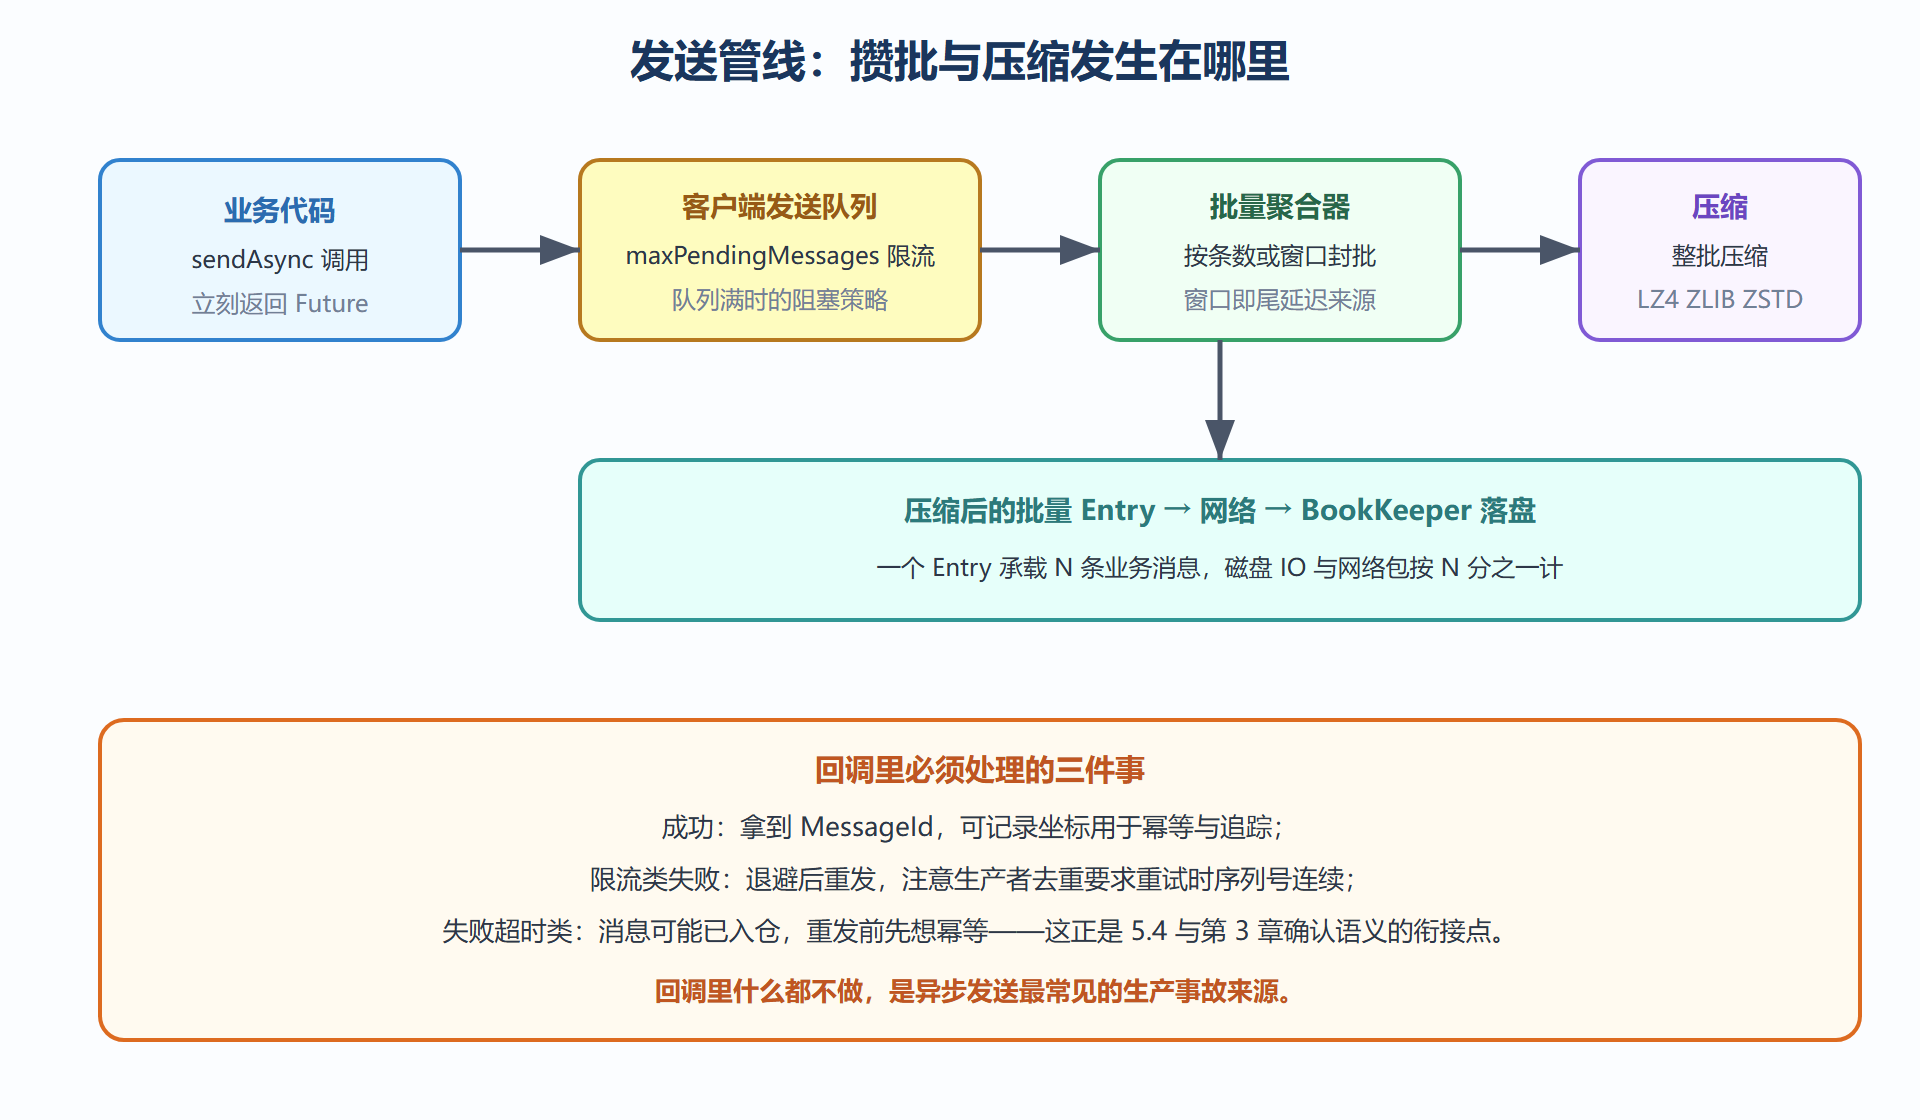
第 3 章说过 send 返回即"已入仓",那背后的等待去哪了?同步 send 的线程在等网络往返加落盘确认,单次几毫秒——每秒只能发几百条,快不过业务生成消息的速度。异步 sendAsync 是吞吐的答案:调用立刻返回 CompletableFuture,消息进客户端发送队列,网络与确认由后台线程完成,成功失败都通过回调通知你。生产代码的默认姿势应该是异步,同步 send 只留给"必须确认成功才走下一步"的关键点(比如任务的最终提交标记)。
异步化之后,真正的决策转移到了发送队列的治理上:队列满了怎么办(阻塞还是报错)、消息挂多久算超时、批量攒多大。这三个旋钮就是本节的主体。
一、批量:吞吐的发动机与尾延迟的代价
**批量(batching)**把极短时间内(毫秒级窗口)到达的多条消息聚成一个 Entry 落盘——第 4 章的写路径因此省下成比例的磁盘 IO 与网络包。参数只有两个:batchingMaxMessages(单批最多条数)与 batchingMaxPublishDelayMs(最长攒包窗口)。窗口越大攒得越多吞吐越高,但最幸运的那条消息也要白等满窗口——这就是批量的固有代价:尾延迟。
选参的实操方法:以业务能接受的 P99 发送延迟为上限倒推窗口。多数业务消息能接受十毫秒级窗口;日志类毫秒级都无感;交易信令类则干脆关批量。还有个常被忽略的旋钮 batchingMaxBytes(单批最大字节),大报文业务里它比条数先触顶,配合压缩一起调才有意义。
压缩(compression)在批量之后对整包生效,三种主流选择各有性格:LZ4 快而压缩比一般,通用默认;ZLIB 压缩比高但费 CPU,适合带宽紧、CPU 闲的场景;ZSTD 在压缩比与速度间取最佳平衡,新集群的首选。压缩在消费端自动解压,所以开启后只需注意旧版本客户端的兼容性。实测参考:订单报文这类 JSON 文本,ZSTD 通常拿到四到六倍的体积缩减,CPU 开销增加不足一成。
图 5-1 生产者发送管线:从业务对象到批量 Entry
二、一段可运行的高吞吐生产者
把本节所有决策装进一段完整代码(Maven 引入客户端依赖后可直接运行):
Producer<byte[]> producer = client.newProducer() .topic("persistent://trade-order/transaction/order-events") .enableBatching(true) .batchingMaxMessages(1000) // 单批上限千条 .batchingMaxPublishDelay(10, TimeUnit.MILLISECONDS) // 攒包窗口十毫秒 .compressionType(CompressionType.ZSTD) // 新集群首选 .maxPendingMessages(10000) // 发送队列深度 .blockIfQueueFull(true) // 队列满则背压阻塞,不丢调用方消息 .sendTimeout(30, TimeUnit.SECONDS) // 确认超时,防止无限悬挂 .create(); List<CompletableFuture<MessageId>> futures = new ArrayList<>(); for (int i = 0; i < 10000; i++) { byte[] payload = buildOrderEvent(i); // 业务报文构造 futures.add(producer.newMessage() .key("order-" + i) .value(payload) .sendAsync()); } // 汇总等待全部完成,失败计数与退避重试在此统一处理 CompletableFuture.allOf(futures.toArray(new CompletableFuture[0])).join(); long failed = futures.stream().filter(CompletableFuture::isCompletedExceptionally).count(); System.out.println("发送完成,失败条数 = " + failed);
预期行为:万条小报文在本地单机模式上数秒内完成,服务端看到的 Entry 数远小于一万(批量生效的直观证据)。想亲眼验证压缩与批量的效果,开两个生产者对照——一个开批量压缩、一个全关——分别跑 pulsar-perf produce 或自己的计时器,比较服务端 stats 里的 Entry 数与字节量,差距一目了然。
⚠️ 常见坑:异步高压发送时把 sendTimeout 设得过长又不处理失败回调,队列堆积、内存上涨、最终 OOM。发送队列的深度参数与回调处理是配套的,改一个必须检查另一个。
批量之下:单条确认与批内坐标
批量带来一个隐蔽的连锁问题:多条业务消息挤在同一个 Entry 里,消费者对其中一条的签收怎么精确到条?Pulsar 的解法是批内索引——消息的坐标(MessageId)扩展出批次内偏移,Broker 拆批发时为每条消息标上"第几批第几条",签收与重投都能精确到批内单条。应用层对此无感知,但有两个行为细节要知道:其一,批内一条消息未确认,整个批次在存储层的回收会被推迟(等最后一条漂完);其二,共享订阅下若消费者不支持批内签收的旧语义,Broker 会把整批重发给该消费者拆解——升级客户端版本能避免这类拆批浪费。
给批量业务的运维建议是围绕"批"立指标:平均批大小(条数)与批填充率(实际条数对上限的比值)。填充率长期偏低说明入口流量撑不满窗口,批量白开还平添尾延迟——这时要么关批量,要么缩小窗口;填充率贴顶说明上限设小了,往上调。批量不是开了就完,它和压缩一样是需要看着指标微调的活旋钮。
一份发送端的检查清单
把本节决策收成可执行的清单,新服务接入时过一遍:发送走异步加回调,回调内成功失败两路都写日志;业务键显式设置,顺序语义与路由都靠它;批量窗口按 P99 预算定,压缩选 ZSTD 起步、压测后微调;发送队列深度与背压策略成对检查;sendTimeout 必设,超时重发配幂等键;关键链路记录 MessageId 用于追踪与判重。清单过完,发送端的坑基本排净——比这更复杂的发送逻辑,通常意味着业务该拆了。
本节要点回顾
- 异步发送是吞吐的前提,回调里必须处理成功与失败两条路;
- 批量两个旋钮定吞吐与尾延迟,窗口大小用 P99 倒推;
- 压缩整批生效、消费端自动解压,ZSTD 是新集群的首选;
- 发送队列深度与背压策略配套调整,防止堆积 OOM;
- 超时重发的消息可能已入仓,发送端幂等与去重必须同步考虑。
下一站到河对岸:消费者怎么接、怎么签、怎么把坏消息送进死信。