6.1 集群部署监控与故障排查
6.1 集群部署监控与故障排查
本节摘要:本节是生产环境的作战地图:单机到集群再到跨地域复制的部署形态怎么选、Broker 与 Bookie 分面的监控指标清单怎么搭、三大典型故障的排查套路怎么走。所有命令与指标都围绕一个目标——在用户感知之前发现漂流的异常。
从单机到跨地域:部署的三种形态
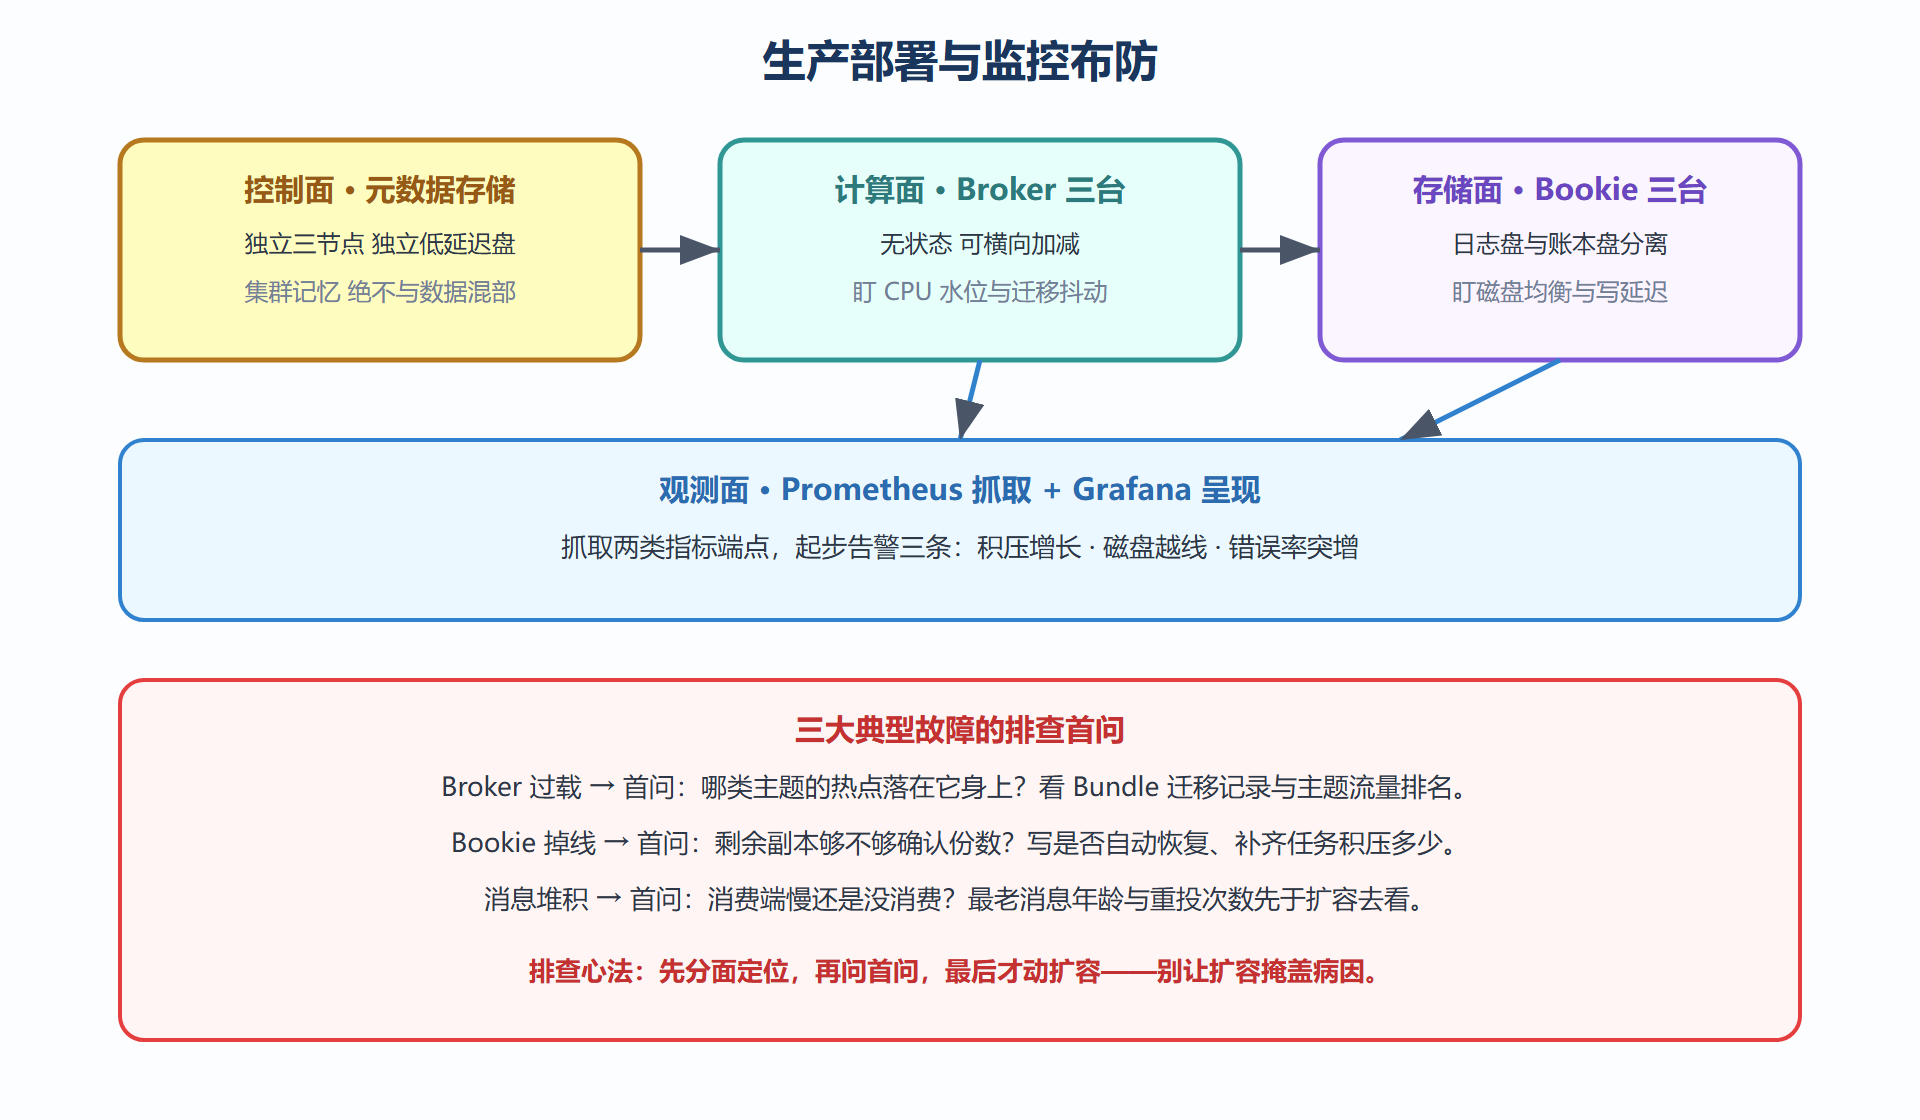
单机模式是学习与开发形态:Broker、Bookie、元数据存储合为一个进程,一条命令起全家。它不适合生产,但适合把全册代码跑一遍。集群模式是生产形态的起点:三种角色分节点部署,起步规模常见的做法是三台元数据节点、三台 Broker、三台 Bookie——每层都凑成可容忍单点故障的最小单元。磁盘布局的铁律在第 2 章埋过:Bookie 的预写日志盘与账本存储盘物理分离;Broker 机器不与 Bookie 混部,控制面绝不与数据面抢资源。
跨地域复制(Geo-replication)是形态的进阶:两个集群之间的主题互相同步,订单在北京集群产生、漂到上海集群供当地系统消费。它的语义要记牢:复制是异步的,跨集群存在秒级延迟窗口;同一条消息在两个集群各有独立游标,两地的消费进度互不牵连。配置层面,复制就是"主题声明远端集群"一件事:
# 集群注册后,为命名空间开启跨集群复制 $ pulsar-admin clusters create shanghai \ --url http://sh-broker.internal:8080 \ --broker-url pulsar://sh-broker.internal:6650 $ pulsar-admin namespaces set-clusters trade-order/transaction \ --clusters beijing,shanghai # 客户端侧:单条消息关闭复制,内部高频流不占跨地域带宽 # producer.newMessage().replicationClusters(List.of("beijing")).send()
客户端侧还有个常被忽略的杀手锏:消息级复制开关。某些高吞吐内部流不希望占跨地域带宽,生产者发送时按条关闭复制即可——全局与单条两个层级都有开关,带宽治理才有弹性。
一、监控三张面:Broker、Bookie、主题
监控要分面搭,因为三类组件的病灶不同。Broker 面盯连接与流量:主题所有者的 CPU 水位(过载会触发 Bundle 迁移抖动)、生产消费的吞吐与错误率、连接数突降(客户端断连风暴的先兆)。Bookie 面盯磁盘与写入:各盘利用率是否均衡(某台 Bookie 磁盘水位孤立偏高说明承载分布倾斜)、预写日志写入延迟、账本补齐任务的积压。主题面盯积压与延迟:每个订阅的 msgBacklog、最老未确认消息的年龄、确认超时重投的次数。
| 面 | 核心指标 | 异常的第一嫌疑 |
|---|---|---|
| Broker | CPU 水位、Bundle 迁移次数、请求错误率 | 迁移频繁说明负载不均或热点主题 |
| Bookie | 磁盘利用率分差、日志盘写延迟、只读触发 | 单盘倾斜或日志盘混用 |
| 主题 | 订阅积压、最老消息年龄、重投次数 | 消费能力不足或处理逻辑卡死 |
指标经 Prometheus 抓取、Grafana 呈现是社区标配玩法:Broker 与 Bookie 均内建指标端点,配置抓取目标后,官方仪表盘模板几乎开箱可用。告警规则建议从三处起步:订阅积压持续增长、Bookie 磁盘水位越线、Broker 错误率突增——这仨覆盖了绝大多数事故的前奏。
图 6-1 集群部署与监控布防全景
二、压测与排错的命令行武器
上生产前先压测,Pulsar 自带的压测工具可以直接构造负载跑出基线:
# 基线压测:一百个生产者打一个分区主题,采集吞吐与延迟分位 $ pulsar-perf produce -u pulsar://localhost:6650 \ -r 10000 -s 1024 persistent://trade-order/transaction/order-bench # 输出示意:Published 10000 msg ... throughput 为每秒条数,附延迟分位表 # 消费侧基线:同样工具反向拉,验证端到端能力 $ pulsar-perf consume -u pulsar://localhost:6650 \ -s bench-sub persistent://trade-order/transaction/order-bench
基线数据的用途是"知道自己集群的常态"。事故日的对比才有意义:延迟分位从常态的五毫秒涨到两百毫秒,涨幅与形态(整体抬升还是长尾)各自指向不同病因——整体抬升看资源面(CPU、磁盘、网络),长尾恶化看路径面(条带补齐、重投风暴、名册抖动)。
💡 关键直觉:运维 Pulsar 的功夫在"分面"二字。同一时刻出现的异常,先归面(计算、存储、控制、观测),再归因。跨面的归因(比如把 Bookie 磁盘倾斜当成 Broker 过载来扩容)是生产环境最昂贵的弯路。
配置变更与滚动升级的纪律
生产系统的一半事故来自变更,Pulsar 的变更纪律围绕"可灰度、可回滚"展开。配置面大多支持动态下发(经管理接口改、各 Broker 热加载),但动态不等于无风险——限流类参数改错立刻全集群生效。纪律有三条:变更前在测试集群复演一遍并记录回滚值;变更时按单台 Broker 灰度观察,再推全量;变更后盯三十分钟关键指标(错误率、延迟分位、Bundle 迁移次数),无异动才算完成。
滚动升级的顺序套路:先 Broker(无状态,逐台摘流重启,客户端自动重连)、再 Bookie(逐台转只读、等补齐与写入切换、再重启)、最后元数据层(多数版本不常动,动前整备份)。每个环节之间留观察窗口,别连续推进。升级窗口内最容易忽视的是客户端版本兼容:服务端新版本对老客户端一般宽容,反过来则未必——升服务端前先确认各语言客户端的版本要求,这条写进升级手册第一行。
本节要点回顾
- 部署三形态:单机学习、三三层生产起步、跨地域复制异地消费;
- 跨地域复制是异步的,游标两地独立,消息级开关管带宽;
- 监控分三面搭:Broker 盯迁移与错误,Bookie 盯磁盘均衡,主题盯积压年龄;
- 三大故障各有首问:热点在哪、副本够不够、是慢还是没消费;
- 先压出基线再谈异常,分面归因先于扩容。
下一站立规矩:认证、授权与配额,把共享集群变成权责分明的公共设施。