6.1 帧率监控与瓶颈定位
6.1 帧率监控与瓶颈定位
本节摘要:性能工作的第一步不是优化,是测量。本节建立「时间账」的观测体系:JS 帧耗时与 UI 帧耗时两条独立曲线、各自的正常区间、超时的归因方向;然后给出排查决策树,把滚动掉帧、响应迟滞、启动缓慢三类症状的定位路径画清楚,最后用一次完整的归因实录示范全程。学完本节,你面对「感觉卡」将不再无从下手。
两本账:JS 帧与 UI 帧分开记
屏幕每刷新一次就是一帧,多数设备按每秒六十帧的节奏工作,每帧预算约十六毫秒——超预算就掉帧,肉眼感受到的就是顿挫。RN 里有两本账要分开记:JS 帧耗时指 JavaScript 线程处理完一轮工作(渲染计算、事件回调、数据加工)花的时间;UI 帧耗时指原生线程完成布局与绘制花的时间。两本账超时指向完全不同的凶手:JS 帧超时,嫌疑人是重计算、过度渲染、高频事件;UI 帧超时,嫌疑人是绘制成本(大量层级、透明度叠加、超大图)或线程争抢(2.1 节的病理)。
测量仪器按场景分三档。开发期用内置性能监视器:晃动设备或命令打开开发菜单,开启帧率监视,两条曲线实时显示,零成本适合随手看;进阶用 React 开发工具的分析器:记录一段时间内的组件渲染次数与耗时,专治「谁在无谓重渲染」;重型武器是原生剖析工具(iOS 的 Instruments、Android 的 Profiler):能看清系统级线程与渲染细节,适合疑难杂症,使用成本也最高。纪律是「由轻到重」:先用监视器确认哪本账超了,再用分析器锁定嫌疑组件,最后才动用原生工具。
图:性能排查决策树
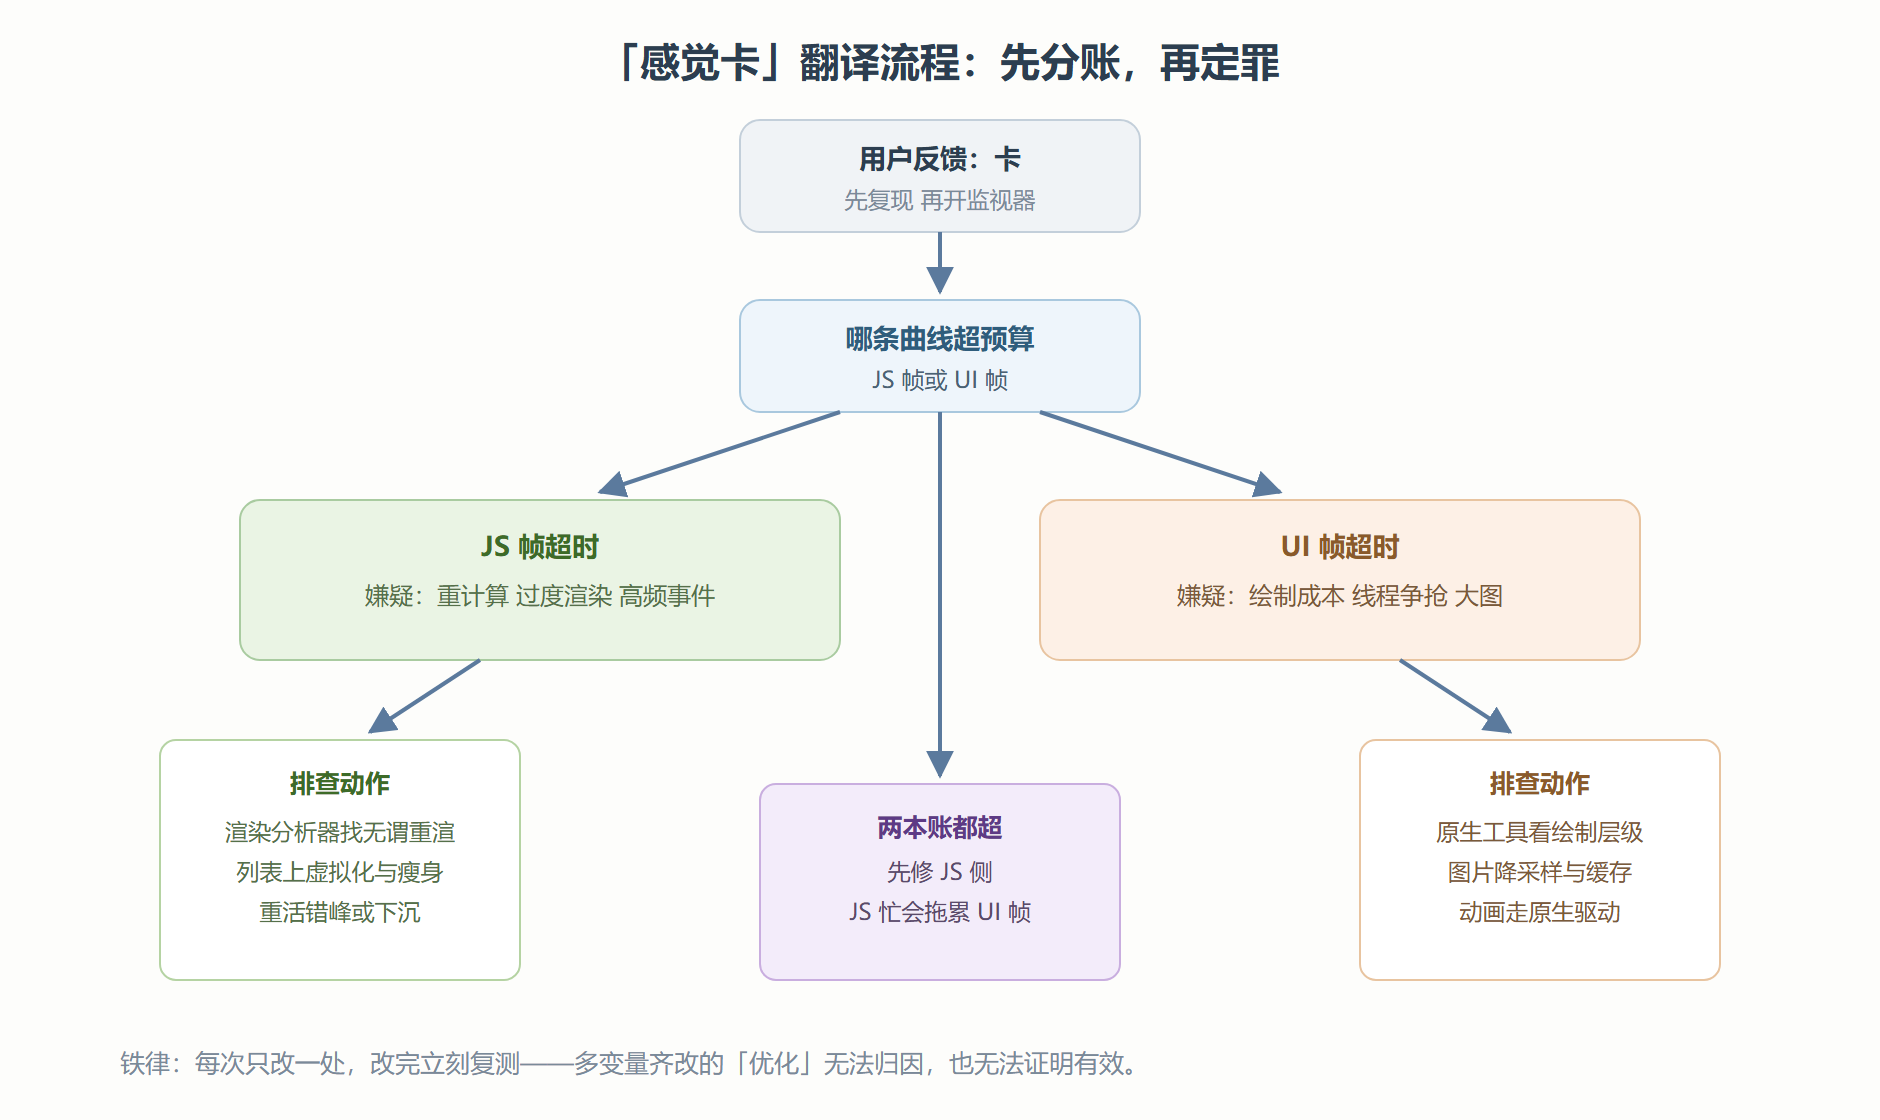
三类症状的定位路径
滚动掉帧先分账。JS 帧超:打开渲染分析器,重点看列表项组件的重渲染次数——常见凶手是父组件一次状态更新引发全部列表项重渲染,或列表项内联函数与内联对象每次渲染都生成新引用,破坏了子组件的记忆化。UI 帧超:看图片——未按显示尺寸降采样的大图是低端 Android 机的头号杀手;再看层级深度与半透明叠加。
响应迟滞(点了没反应)几乎都是 JS 线程被占:回忆 2.1 的病理,手势事件要过线程,正被数据加工占住的线程会让一切点击排队。修法是错峰与下沉:重计算挪后台或分片,交互回调轻量化。
启动缓慢按 2.3 的三段口径归因:白屏长查原生壳与引擎,包装载长查包体与同步初始化,首屏卡查首屏渲染量。三类症状的修法分别在后续小节与第 8 章展开,本节先立好「测与判」的骨架。
动手:给核心页面建性能基线
性能工程的第一个交付物不是优化代码,是「基线」——核心页面在标准设备上的帧率、耗时、内存记录。有了基线,之后任何改动都能说清「变好还是变坏」。建立基线的操作步骤值得照抄:定场景(列表滚动、页面转场、表单提交流各选一个代表);定脚本(把操作步骤写死:滚动几屏、停留几秒、触发什么动作,人肉执行会引入节奏偏差);定环境(同一台设备、同一网络档位、关闭无关后台应用、发布构建而非调试构建——调试构建的性能数据不可信,这是新手最容易忽视的前提);记录(每项指标至少三到五次取样,取中位数,记录机型与系统版本)。
JS 侧的计时可以在代码里固化,作为回归脚本的一部分:
// 用性能时间源给关键处理打点:进入页面到数据就绪的耗时 const t0 = global.performance.now(); const data = await prepareFeed(raw); const cost = global.performance.now() - t0; // cost 超过预算(如 50 毫秒)时输出告警,纳入持续观测 if (cost > 50) { console.warn('feed 加工超预算:' + Math.round(cost) + 'ms'); }
基线的另一半价值是「防守」:给核心指标立预算(列表滚动 JS 帧均值不超过若干毫秒、页面进入耗时不超过几百毫秒),写进团队规范。性能预算让争论变得简单——新功能导致基线越线,要么优化实现,要么明确豁免理由,没有第三种「感觉还行」。基线数据还要定期重录:设备换代、依赖升级、业务增长都会让旧基线失真,一个季度重测一次是务实的节奏。
完整归因实录:一次「越用越卡」的侦察
背景:某社区应用反馈使用十分钟后明显变卡,重启才恢复。操作全程如下:复现时打开性能监视器,记录两本账曲线随时间的变化;发现 JS 帧基线随使用时长缓慢抬升——排除了「某处一直慢」的静态问题,锁定「累积型」病因;用渲染分析器快照对比前十分钟与三十分钟的渲染统计,发现某个悬浮徽章组件的重渲染次数异常增长;追查它的订阅链,发现它订阅了一个全局事件总线,而页面每次进出都注册了新监听、从不注销,监听数组越长,事件分发越慢。修复:监听注册与注销配对(副作用钩子返回清理函数),并给徽章组件加记忆化。验证:复测同一脚本操作三十分钟,JS 帧基线平稳。解读:这个案例演示了本节的完整方法链——分账定方向、快照找异常、订阅链找病根、配对验证闭环;「越用越卡」四个字里藏着的累积型病因,几乎都顺着这条链抓到。变式:若当时曲线显示的是内存持续上涨,侦查方向就要转向 6.3 的空间账——同一套纪律,另一本账。
读数的艺术:均值、长尾与用户体感
有了仪器还要会读数。均值会骗人:平均帧率看起来还行,但用户记住的是最卡的那几次——性能问题的体感由长尾决定,关注指标要看重分位(比如最差的那一小段操作的耗时)而不是平均数。另一个读数要点是「对照情境」:滚动帧率要看滚动中的曲线段而不是整个会话的平均,转场耗时要看转场窗口内的峰值,截错窗口的读数毫无意义。最后,读数要带着机型分层看——高端机的长尾可能是低端机的均值,混在一起的平均数对两端都没有解释力。这三条读数纪律与 6.3 的线上监控一脉相承:开发期的读数习惯,决定上线后你能从监控数据里读出多少东西。
本节要点回顾
- 每帧预算约十六毫秒:JS 帧与 UI 帧两本账分开记,超时各自指向不同凶手;
- 仪器由轻到重:监视器分账、分析器锁组件、原生工具看系统级真相;
- 两本账都超先修 JS:JS 线程忙碌会拖累 UI 帧的提交节奏;
- 累积型症状追订阅链:监听只注册不注销,是「越用越卡」的头号病根;
- 单变量纪律:一次只改一处,改完即测,无法归因的优化等于没做。
方法在手,下一节攻最重的战场:长列表的虚拟化与调优。