8.2 调试日志与性能优化
8.2 调试日志与性能优化
重活搬进队列后,主干提速了多少?感觉不算数,数字才算。本节把「用户说慢」翻译成「哪一段多少毫秒」:日志分级让信息按重要程度归档,慢查询日志让数据库开口交代,瓶颈定位板让优化有章可循。本节回收 7.3 的防线日志(通道留痕)与 5.2 的模板缓存(编译产物),把观测视角拼完整。学完你应当能给书店项目产出一份带数字的瓶颈报告,并知道每个数字该对应什么动作。
日志分级:让信息按重要程度排队
日志的第一原则是分级——所有信息挤在一个文件里等于没有信息。框架按严重程度分了层级,写日志时选对级别:
use think\facade\Log; Log::debug('变量调试:{var}', ['var' => print_r($cart, true)]); // 开发期细节,生产常关 Log::info('订单创建成功,编号 {sn}', ['sn' => $sn]); // 正常业务流水 Log::notice('库存低于阈值,编号 {sn}', ['sn' => $sn]); // 值得留意 Log::warning('第三方通知接口超时,重试中'); // 潜在问题 Log::error('支付回调验签失败,单号 {sn}', ['sn' => $sn]); // 需要介入
通道与轮换在配置里定:错误单独一个通道(7.3 的拒绝日志、8.1 的死信任务都归这里),按天轮换防止单文件膨胀,保留期按团队规范设置。级别纪律一条:生产环境只开 info 及以上——debug 的量足以把磁盘写满,把真正重要的 error 淹没。告警则挂在 error 级别上:错误出现即通知值班(对接 8.3 的发布后观察),而不是等人翻日志。
Trace 与 SQL 慢查询:两台显微镜
「慢」有两台显微镜。第一台是 Trace 调试面板(开发环境开启),它把一次请求的完整开销摊开:路由耗时、SQL 清单(含每条的执行时间)、视图渲染、日志条目。开发期随手开着,写完一个接口顺手看一眼 SQL 条数——列表页出现几十条同构查询,就是 N 加一问题的现场(每行记录各查一次关联表),用 4.3 的关联预载入一次收编。
第二台是慢查询日志(生产环境的必需品),配置数据库把超过阈值的 SQL 记录下来:
// 数据库配置里打开 SQL 日志级别并配合慢日志阈值 'default' => 'mysql', 'connections' => [ 'mysql' => [ // ... 'trigger_sql' => false, // 生产关闭 SQL 实时输出,交给慢日志 ], ],
-- 数据库侧示例:记录超过一秒的查询(MySQL 参数示意) SET GLOBAL slow_query_log = 'ON'; SET GLOBAL long_query_time = 1;
阈值从一秒起步逐步收紧到几百毫秒——阈值太松清单干净但没有信息量,太紧则噪音淹没信号。慢查询清单是优化的工作队列:每一条都值得追到代码(4.1 的 EXPLAIN 流程在这里回收:看索引有没有命中、扫描行数与返回行数是否失配)。
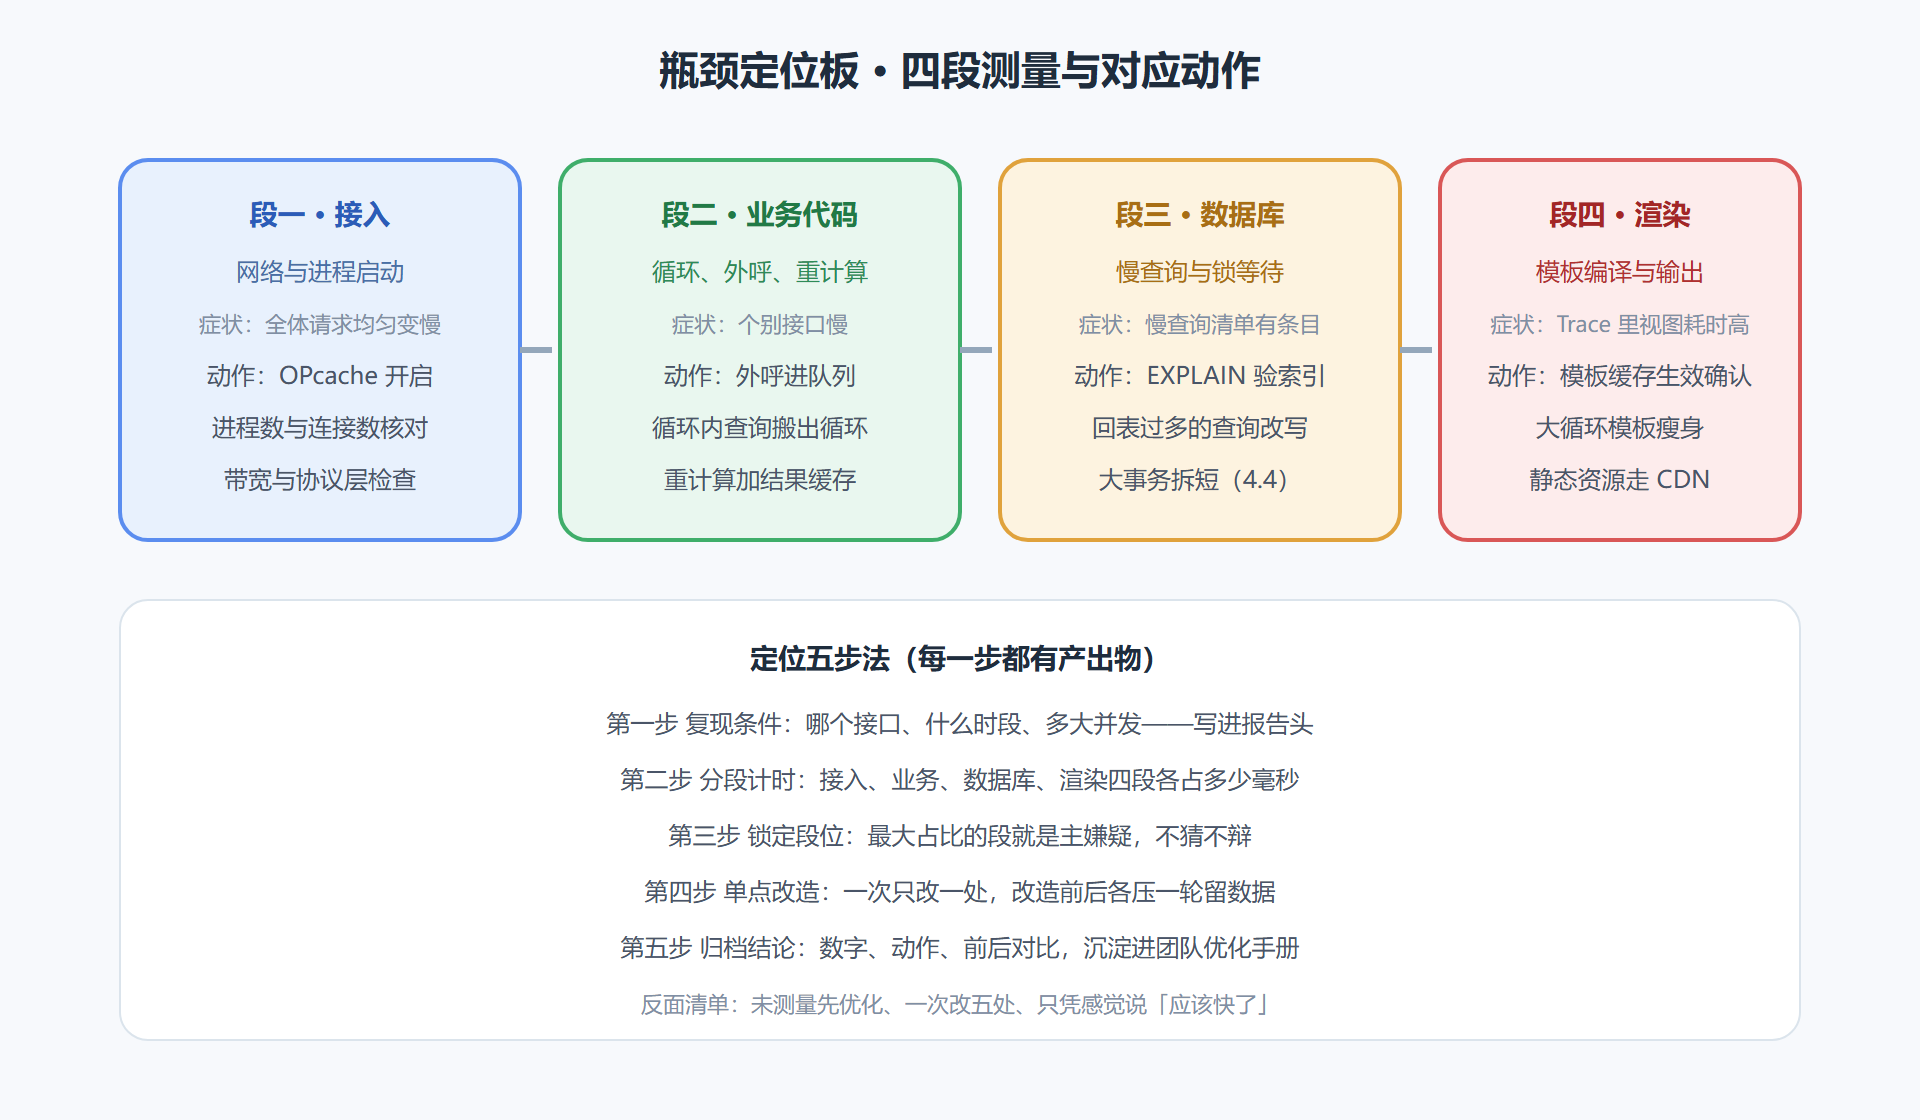
图 8-2:瓶颈定位板 · 从感觉到数字
部署级调优与优化纪律
四段之外还有一段「整体开关」值得单独说:OPcache。PHP 每次请求默认重新编译全部脚本,OPcache 把编译产物放进共享内存,生产环境开启后接入段开销大幅下降——它不改变一行代码,却是性价比最高的单项优化。核对三件事:扩展已启用、内存够放全项目产物(压测后看命中率)、生产与开发配置隔离(开发频繁改文件,开 OPcache 反而困惑)。
优化纪律是本节真正的收口:测量先行,单点改造,数据说话。瓶颈定位板的五步法之所以每步都要求产出物,是因为性能优化最贵的成本不是写代码,是「优化了没效果还不自知」。任何一次改造,改前改后各留一组压测数字——没有对比数据的优化报告,一律视作未完成。
动手练习:产出书店项目第一份瓶颈报告
背景:练习项目列表接口在并发一百时响应明显劣化。操作:按五步法走完全程——压测记录基线;Trace 分段定位;发现列表页存在关联查询的 N 加一,慢查询清单证实;用预载入改造;复压对比并归档。结果示例:报告显示数据库段耗时从占比七成降到一成五,整体响应改善约一半,剩余瓶颈转向渲染段的静态资源。解读:注意「剩余瓶颈」的表述——优化不是消灭所有数字,是让最大的数字让位;报告结尾永远写下一次的嫌疑段。变式:在预载入之外再试一次结果缓存(6.2 回收),对比两种方案在本场景的收益与失效成本,把结论写进优化手册。
💡 关键直觉:性能问题的第一现场通常不是代码慢,而是「代码让数据库重复干活」。四段定位板的价值在于把目光从「猜」转到「量」——数字会告诉你嫌疑人是谁,你只需要按住单点改造的纪律。
一次完整的定位现场
把定位板落到一个真实现场。某天运营反馈「图书列表页变慢了」。第一步复现条件:慢集中在工作日上午十点与晚八点,其余时段正常——这个分布本身就是线索,指向「访问高峰才慢」。第二步分段计时:接入段两毫秒稳定,业务段十二毫秒,数据库段八百多毫秒且随并发上涨——嫌疑锁定段三。第三步进慢查询清单:同一句分类统计查询高频出现,执行计划显示全表扫描;第四步单点改造:给分类字段补上索引,语句从全表扫变成索引扫;第五步复压归档:高峰期列表响应时间从九百毫秒降到九十毫秒,结论与执行计划的前后对比一并写进优化手册。
这个现场的完整价值在复盘里:索引缺失为什么没被开发期发现——开发库数据量小,全表扫描也不慢,问题只在数据量上来后显形。这解释了为什么慢查询清单要常开:它是唯一一个「在生产环境替你盯着数据长胖」的观测点。
日志的治理:三个月后的瘦身
日志系统的第二个问题在上线三个月后出现:磁盘与注意力同时告急。治理三板斧:分级复核——生产环境 debug 是否真的关了、info 里有没有本该 debug 的流水;轮换与保留期——按天轮换配合保留窗口,超期自动清;通道分离——错误通道独立后,业务流水的高频写入不再污染告警视野。日志治理的目标是「出事时找得到、平时没人看」,达成它的手段恰恰是让平时的日志更少更准。
本节要点回顾
- 分级是日志的生命:生产只开 info 以上,错误通道独立并接告警。
- 两台显微镜分工:Trace 管开发期全景,慢查询日志管生产期清单。
- N 加一是头号惯犯:列表页几十条同构查询,预载入一次收编。
- OPcache 是整体开关:不改代码的接入段优化,开启、内存、命中率三核对。
- 无对比不优化:测量先行、单点改造、数据归档,缺一步的报告视作未完成。
看得见慢点了,最后一公里是把它安全地送上线:测试、环境与部署见 8.3。