4.2 页面跳转 API 与传参
4.2 页面跳转 API 与传参
本节导读:登记之后是流转。本节把四种跳转 API 放在"页面栈会发生什么"的坐标下对照,给出按目标栈态选 API 的决策法;传参部分覆盖 query、复杂对象与 EventChannel 三档,末尾用商城下单动线把全部 API 串成一次实战。
四个 API 的本质是四种栈操作
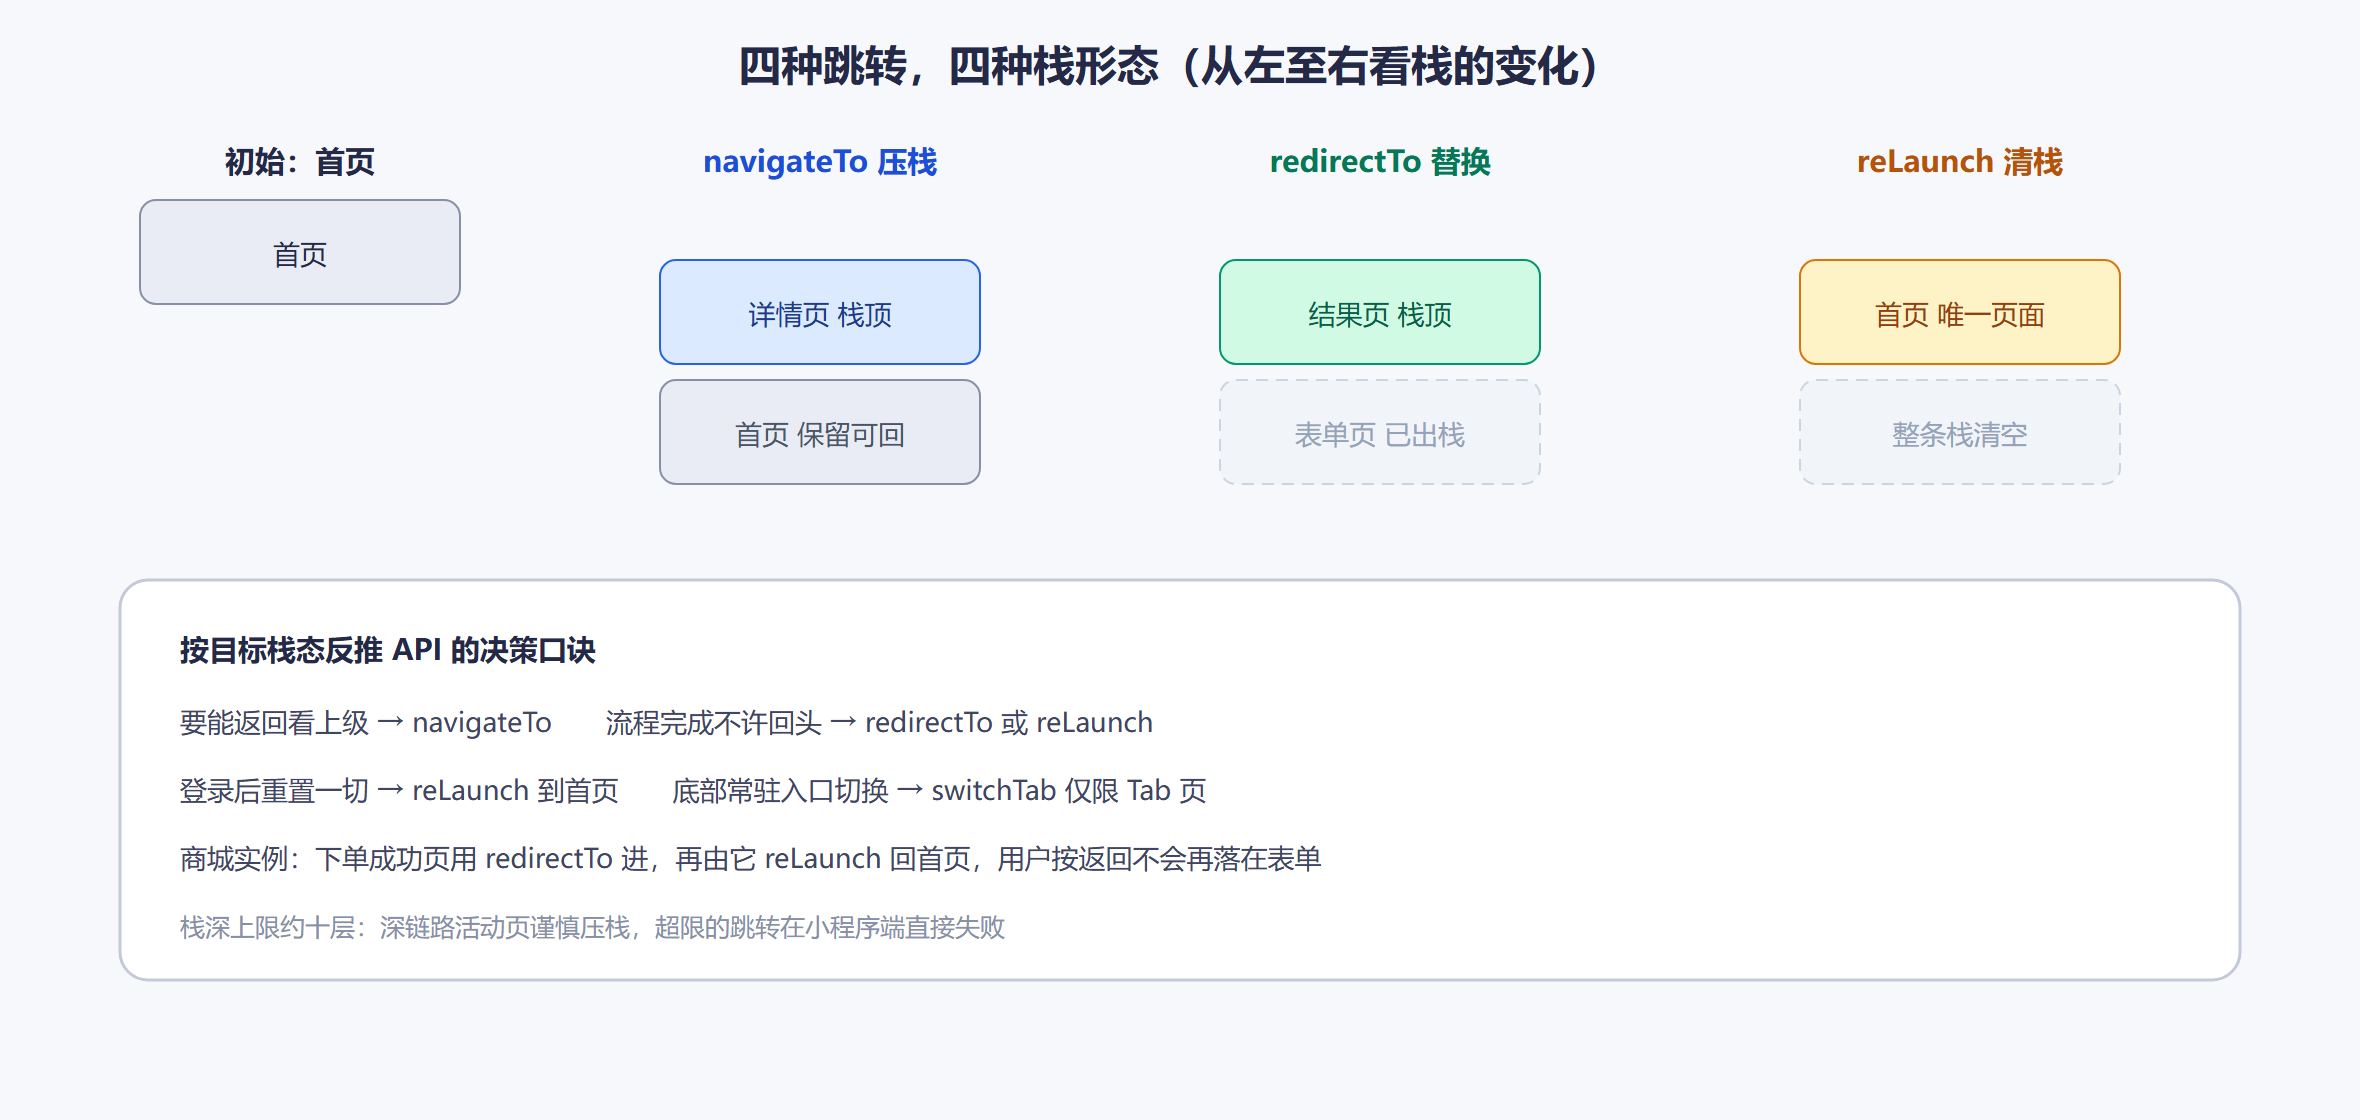
跳转 API 的文档参数大同小异,真正的差异在栈语义。把四个 API 排进同一张对照,选择标准立刻清晰:navigateTo 压栈,新页进栈顶、旧页保留,可返回;redirectTo 替换栈顶,当前页出栈、新页顶上,返回跳过当前页;reLaunch 清栈重开,整条栈清空、目标页成为唯一页面;switchTab 切常驻层,只在 pages.json 里登记过的 tabBar 页面之间切换,非 Tab 页调用直接报错。
图 4-2 跳转 API 对页面栈的影响
传参三档:query、复杂对象与 EventChannel
第一档 query 是默认通道:url 后拼查询串,目标页在 onLoad 的参数里取回。两条纪律——只传标量(字符串与数字),必编码(encodeURIComponent 包住动态值):
// 跳转方:参数拼接 const kw = encodeURIComponent('春季 新品'); uni.navigateTo({ url: `/pages/goods/list?keyword=${kw}&from=home` }); // 目标页:onLoad 取参 export default { onLoad(query) { this.keyword = decodeURIComponent(query.keyword || ''); this.from = query.from || 'direct'; this.fetchList(); } };
第二档是复杂对象。列表页要把整份商品对象带进详情时,常见错误是把对象直接拼进 url——小程序端会把它序列化成无法解析的字符串。可行做法按数据体量选:小对象走 JSON 加编码;大对象不走红毯,先落存储或全局状态,url 只带 id,详情页按 id 取回。这条纪律顺带解决了"分享链接打开参数丢失"的问题——id 是可还原的,对象不是。
第三档 EventChannel,处理"页面之间直接说话":跳转时带 events 监听、目标页用 getOpenerEventChannel 回话,适合"选择地址页把选中项还给下单页"这种来回协作:
// 下单页:发起跳转并监听回话 uni.navigateTo({ url: '/pages/user/address-picker', events: { addressPicked(addr) { this.order.address = addr; } } }); // 地址选择页:向打开它的页面回传 export default { onLoad() { const channel = this.getOpenerEventChannel(); this.confirmAddr = (addr) => { channel.emit('addressPicked', addr); uni.navigateBack(); }; } };
EventChannel 的端覆盖整体良好,但 H5 端在刷新后通道失效——刷新即重建页面实例,这是机制使然而非缺陷,关键协作仍要有数据兜底(选中项同步写一份到存储),通道只是顺路的快速道。
实战:商城下单动线的完整跳转编排
把四个 API 放进一次真实动线收尾。商品详情点"立即购买"→ navigateTo 进确认订单页(要能返回再挑地址);确认订单提交成功 → redirectTo 进支付结果页(表单使命结束,不该再回去重复提交);结果页点"回到首页"→ reLaunch 回首页(整条下单栈作废);用户此后从底部进购物车 → switchTab。整条动线没有一个"返回"能把用户带回已作废的表单——这不是巧合,是每一步都按目标栈态选了 API。把这个推理过程变成习惯,跳转 API 就从"背参数"升级成"画栈图"。
跳转故障三则与定位口诀
三个真实跳转故障帮助把规则记住。故障一,跳转无反应:十有八九是目标页没在 pages.json 登记,或 url 漏写开头斜杠;定位口诀是"先查登记再查字符串"。故障二,switchTab 报错:目标页不是 Tab 页,把 navigateTo 误写成了 switchTab;口诀是"常驻层才走 switchTab"。故障三,参数拿到是 undefined:跳转串里的参数名与 onLoad 里取的名字对不上,或者动态值没编码导致截断;口诀是"拼接与取参用同一份常量,动态值必编码"。把这三条口诀贴在代码评审清单里,跳转类缺陷的返工基本可以绝迹。
给跳转层做一次收口
散落在页面里的 uni.navigateTo 调用,与散装请求是同一种病:url 字符串各写各的,参数拼写错误要等运行期暴露。收口方案是一个路由模块:把每条路由的 path 与参数定义集中在一个文件里,导出语义化的跳转函数(goGoodsDetail(id)、goOrderSubmit(goodsId)),内部统一处理 url 拼接与编码。收益立竿见影:页面重构改名时只改一处;参数必填校验在开发期就能拦截;埋点同学要加统一来源参数,也是一处搞定。这个路由模块通常五十行以内,是投入产出比最高的一次收口,建议在项目起步期就做。
深链与场景值的补充说明
补一个容易漏的话题:外部拉起。商城的分享卡片、二维码、短信链接都能从外部直接进入某个页面,这类入口走的是各平台的深链机制,落地后同样要过"目标页是否登记、参数是否可解析"两道关。工程要点两条:深链目标页必须能独立初始化——不依赖"一定从某个上级页跳来"的隐含前提,参数缺失给默认值;来源参数(scene、渠道值)统一解析进 5.1 的全局状态,运营统计与页面逻辑共用一份。深链是获客的入口,也是崩溃的入口,把它的健壮性当正式功能对待。## 本节要点回顾
- 跳转 API 的差异是栈操作:压栈、替换、清栈、切常驻层,按目标栈态反推选择;
- query 传参只传标量并编码,复杂对象走存储加 id,url 保持可分享可还原;
- EventChannel 解决页面间直接协作,H5 刷新即失效,关键数据要有存储兜底;
- 栈深上限约十层,深链路压栈要节制;
- 下单动线示范了"每一步按栈态选 API",返回行为从此可推导。
跳转编排好了,下一节看栈的另一面:页面栈的生命周期协同与返回拦截。