1.1 一条指令的一生:从源代码到字节再回来
1.1 一条指令的一生:从源代码到字节再回来
本节摘要:本节在全册知识体系中充当"预告片":承接导读的工坊鸟瞰图,用一条加法指令的完整旅程,把编译、汇编、编码、取指、译码、执行这些后面各章的主角提前亮相。读完你应当能复述指令生命周期的各个环节,并亲手核对两个真实的机器码。
先看全程:加法指令的旅程
学指令集最容易掉进"只见术语不见全程"的坑:操作码、寻址、流水线一个个学过去,却始终没把它们串成一条线。所以我们反着来——先用最短的时间走完全程,再回头逐站细看。全册的每一章,都对应这段旅程中的某个站点。
假设你在一个 C 文件里写下这样的小函数,它把传入的参数加 20 后返回:
int add20(int b) { return b + 20; }
这行代码对处理器毫无意义。CPU 不认识 int,不认识函数,更不认识加号。它只认一种东西:按指令集格式填好的二进制位串。从你的源代码到处理器内部真正发生加法,中间隔着一条完整的流水账,我们逐站走一遍。
站点一:编译器翻译。编译器(比如 GCC 或 Clang)先做语法分析,把 C 代码变成中间表示,然后针对目标指令集做指令选择。对 x86-64,它可能选中一条带位移的加载有效地址指令来顺手完成加法;对 RISC-V,它会用最朴素的自增立即数指令。同一个 b + 20,不同的指令集给出的答案完全不同——这就是"契约不同,产物不同"。
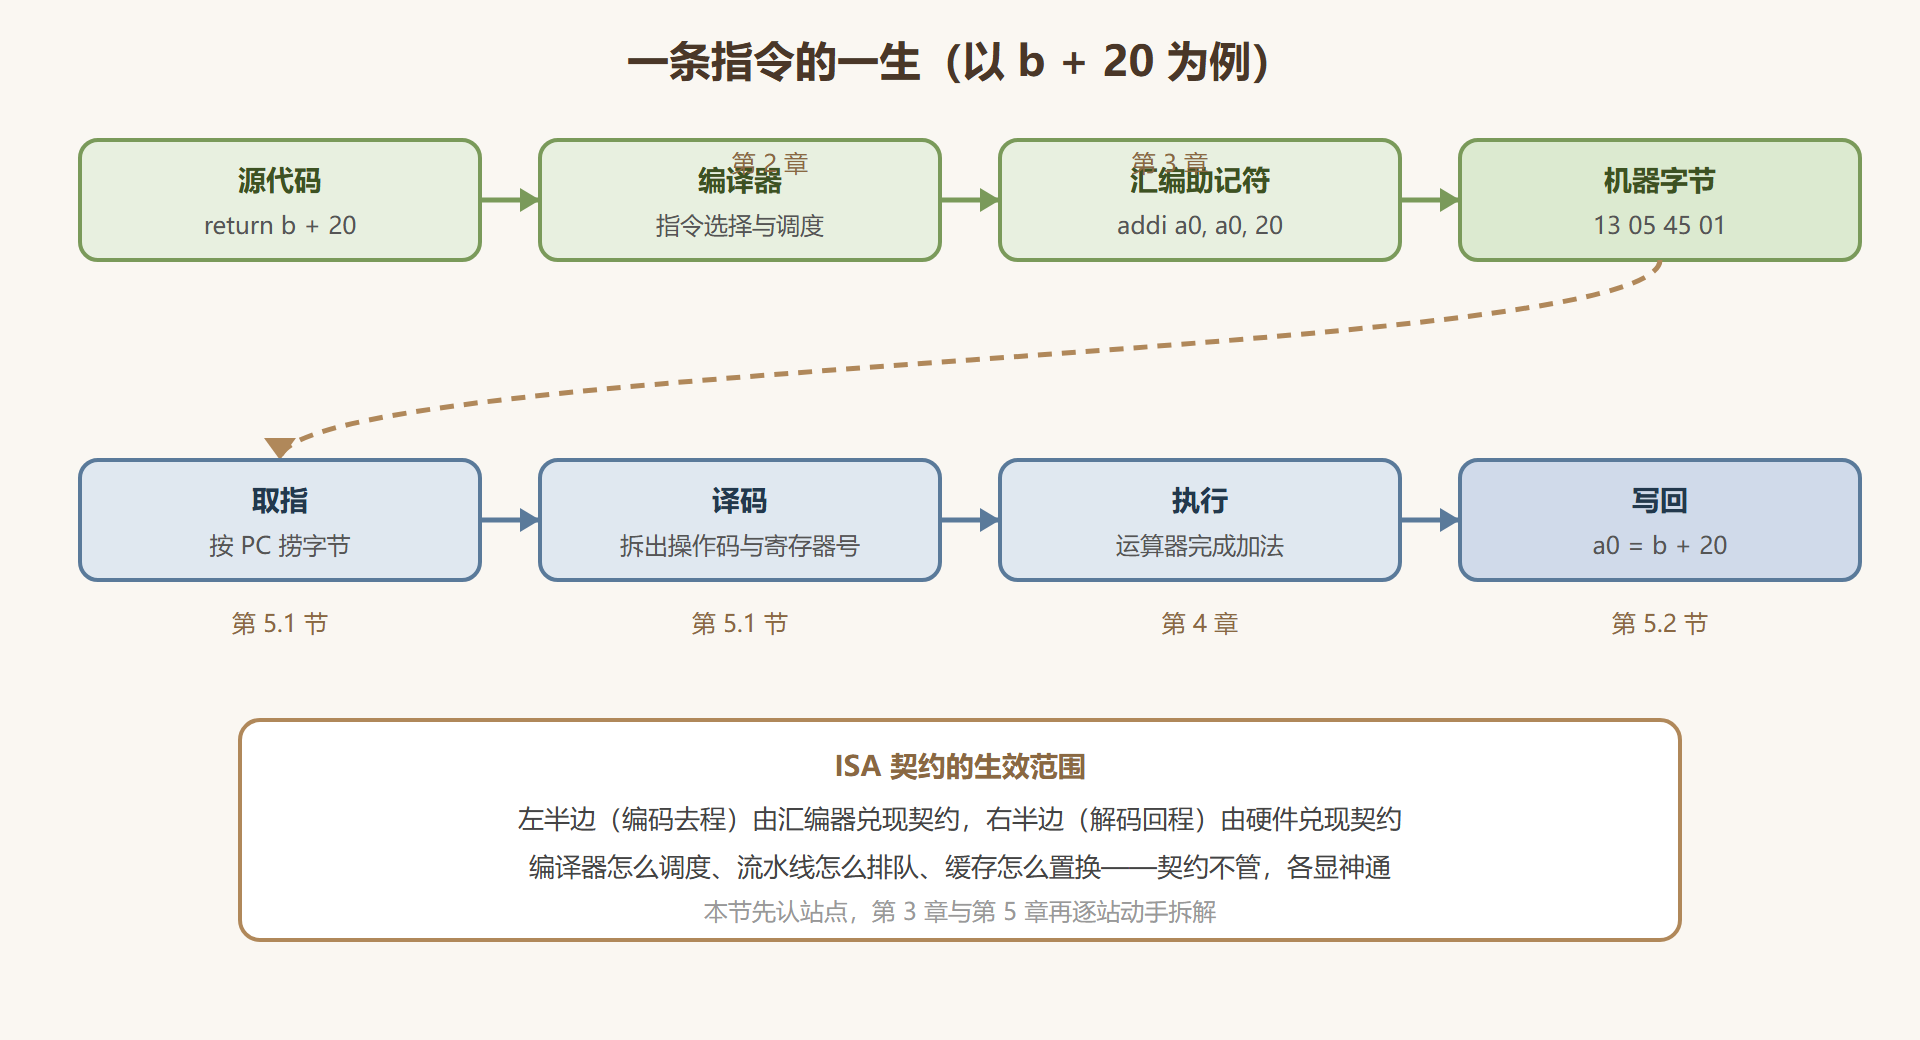
站点二:汇编器编码。编译器输出的是汇编文本,人还能读,机器读不了。汇编器把每行助记符查表、填字段、拼位流,输出真正的机器字节。这一步就是第 3 章编码车间的全部内容。现在你只需要看结果:
; x86-64 版本(GCC -O2 典型输出) lea eax, [rdi+20] ; 把 rdi 里的值加 20 放入 eax ret ; 返回 ; 对应机器字节(十六进制) 8D 47 14 ; lea eax, [rdi+20] C3 ; ret
; RISC-V RV64 版本 addi a0, a0, 20 ; a0 = a0 + 20 ret ; 等价于 jalr zero, ra, 0 ; 对应机器字节 13 05 45 01 ; addi a0, a0, 20(小端存放) 67 80 00 00 ; ret
同一个加法,x86-64 用了三字节指令,RISC-V 用了四字节指令。字节在内存里按小端序摆放:RISC-V 那条加法的逻辑值是 0x01450513,落到内存里就成了 13 05 45 01,低位字节在前的低地址。这类"逻辑值与存放顺序"的细节,4.1 节还会专门展开。
站点三:加载与取指。机器字节被写进可执行文件,操作系统把它映射进内存,程序计数器(PC)指向它的地址。处理器开始取指:按 PC 从指令流中捞字节。x86-64 在这里遇到一个麻烦——指令长短不一,处理器得先猜这条指令是几字节;RISC-V 的定长指令则没有这个烦恼。差异的种子在编码阶段就埋下了。
站点四:译码。取到的字节进入译码器。以 RISC-V 那条 0x01450513 为例,硬件按格式表切分:低 7 位 0010011 表明这是"立即数运算"类指令;接下来的 3 位功能码 000 说明是加法;再往后依次是源寄存器号 01010(即 a0)和立即数 20。一串位被还原成"把 1 号源寄存器(对应 a0)的值加上 20"这条语义。第 5 章解码车间会带你逐位拆解全过程。
站点五:执行与写回。运算器接过源操作数,完成加法,结果写回目标寄存器 a0。随后 ret 指令把返回地址装进 PC,旅程结束,控制权交回调用者。寄存器里的新值,就是这条指令留在世界上唯一的痕迹。
图 1-1:一条指令的一生:编码去程与解码回程
动手核对:把两个机器码拆回字段
看图不算数,我们当场核对。先拆 x86-64 的 8D 47 14:第一个字节 8D 是操作码,在 x86-64 的一字节映射表里对应 LEA(加载有效地址);第二个字节 47 是 ModRM 寻址字节,二进制为 01 000 111——最高两位 01 表示"带一个 8 位位移",中间三位 000 指定目标寄存器 eax,低三位 111 指定基址寄存器 rdi;第三个字节 14 是十进制的 20,就是那个位移量。拼回语义:把 rdi 加 20 的结果放进 eax。与源代码 b + 20 完全对上——调用者把参数 b 放在 rdi(System V 调用约定),返回值放在 eax。
再拆 RISC-V 的 0x01450513。按 I 型格式从低位往高位切:最低 7 位 0010011 是操作码,代表立即数类运算;随后 3 位 000 是加法功能码;随后 5 位 01010 是源寄存器 x10(a0);随后 5 位还是 01010,这次是目标寄存器 x10;剩余高 12 位 000000010100 是立即数,恰好是 20。逐位无一冤枉。你可以把这两段字节抄在任何反汇编工具里验证,输出会精确还原出上面的助记符。
这项"逐位对账"的手艺是全册的基本功。3.4 节会把它扩展成完整的手工编码演练——给你一段汇编,你从格式表出发独立装配出全部字节;5.1 节则站在硬件视角再做一遍同样的事,体会译码器为什么要按固定格式切分位流。
同一段旅程换到 ARM64 上
为了确认"契约不同、产物不同"不是 x86 与 RISC-V 的偶发差异,再看 ARM64 的版本。函数 add20 在 ARM64 上的典型产物只有一条主指令:
; ARM64 版本 add w0, w0, #20 ; w0 = w0 + 20(32 位运算) ret ; 对应机器字节 00 50 00 11 ; add w0, w0, #20(逻辑值 0x11005000)
逐位核对 0x11005000:最高位是位宽标志,清零表示 32 位运算;接着的操作码段 00100010 宣告这是"立即数加法";随后一个移位标志位和 12 位立即数字段——填的正是 20;最后两个 5 位字段分别是源与目标寄存器号,都是 w0 对应的 0 号。整条指令恒定 4 字节,格式板正,没有任何一条 ARM64 指令会多一个字节或少一个字节。对比 x86-64 的三字节 lea 和 RISC-V 的四字节 addi:同一语义,三种格式,三种字节量,各有各的算盘——这盘算盘怎么打,正是第 2 章流派与第 3 章编码车间要细算的账。
这段旅程还能反过来解释你调试时的日常。在调试器里单步到某行 C 代码,窗口显示的其实是它展开后的几条机器指令及其地址;崩溃报告给出的出错地址,要靠可执行文件里的符号信息映射回"哪个函数哪条指令";优化编译器改变了指令顺序,导致单步时源代码行号来回跳——这些现象全都发生在"站点二之后的旅程"上。掌握了全程地图,工具链里那些看似魔法的行为,都能还原成"某条指令在某个站点被如何处理"的具体问题。
容易踩的坑
最常见的误会,是把"指令的一生"想成一条物理流水线上的货物搬运。站点一到站点五不是五台顺序排开的机器:现代处理器会把取指、译码、执行重叠进行,同一时刻流水线里可能躺着十几条不同指令的不同阶段。旅程的"逻辑顺序"不等于"物理时间线",这层区分在第 5 章讲流水线时会变得至关重要。
第二个坑:假设所有架构的函数参数都放在同一个寄存器。x86-64 的 System V 约定把第一个整型参数放在 rdi,Windows 的 x64 约定却放在 rcx;ARM64 放在 x0。参数放哪不是 ISA 的本体规定,而是调用约定——它在 ISA 之上、由平台标准化组织另行约定。第 5 章讲控制流时会回头收拾这个话题。
最后提醒一点:本节出现的所有十六进制编码都值得亲手抄一遍再拆一遍。指令集学习的效果差就差在"看懂了"和"会拆了"之间——那道坎只能靠手指头迈过去。
本节要点回顾
- 指令的一生分五站:编译器翻译、汇编器编码、加载取指、译码、执行写回;ISA 契约约束"字节格式与语义",不约束实现方式。
- 同一语义在不同 ISA 下产物不同:
b + 20在 x86-64 是8D 47 14(lea),在 RISC-V 是0x01450513(addi),格式差异由第 2、3 章解释。 - 逻辑值与内存摆放是两回事:小端序把
0x01450513摆成13 05 45 01,字节序在 4.1 节展开。 - 逐位拆解是基本功:操作码、功能码、寄存器号、立即数各占其位,本节已完整演示两次。
- 调用约定独立于 ISA:参数放在哪个寄存器由平台约定决定,别把它当成指令集本体。